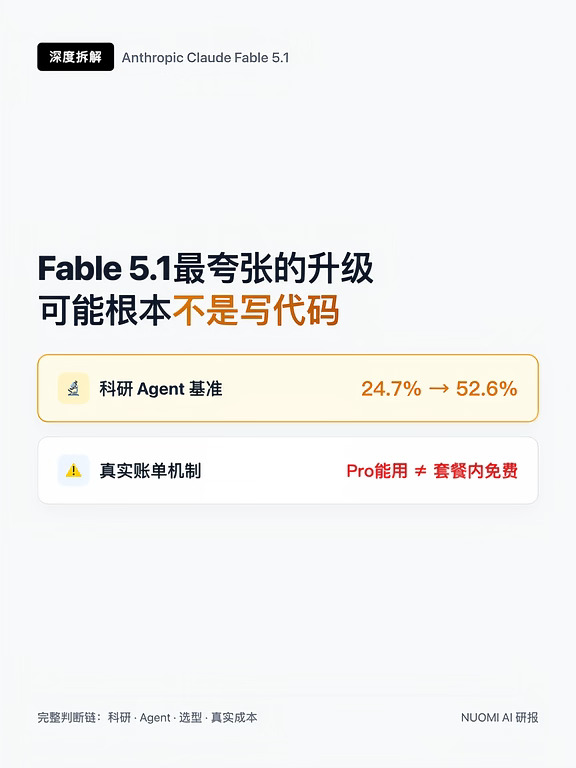
Fable 5.1 发布后,大家聊得最多的还是编程 SOTA。但我翻完官方 System Card,这次最值得深挖的,其实根本不是写代码。
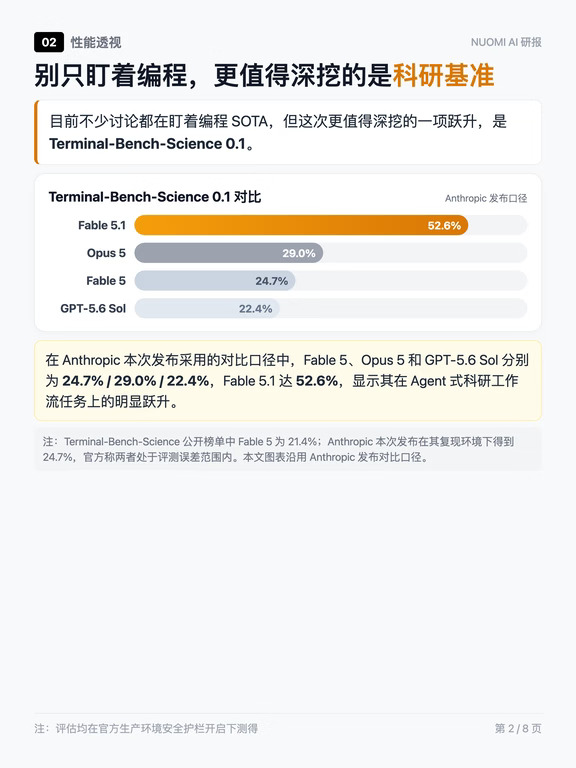
是那个被很多人划过去的科研基准:Terminal-Bench-Science 0.1。Fable 5.1 拿到 52.6%,同口径下 Fable 5 为 24.7%,Opus 5 为 29.0%,GPT-5.6 Sol 为 22.4%。(公开榜单标 21.4%,官方复现 24.7% 处于误差范围内,本文沿用官方口径)。
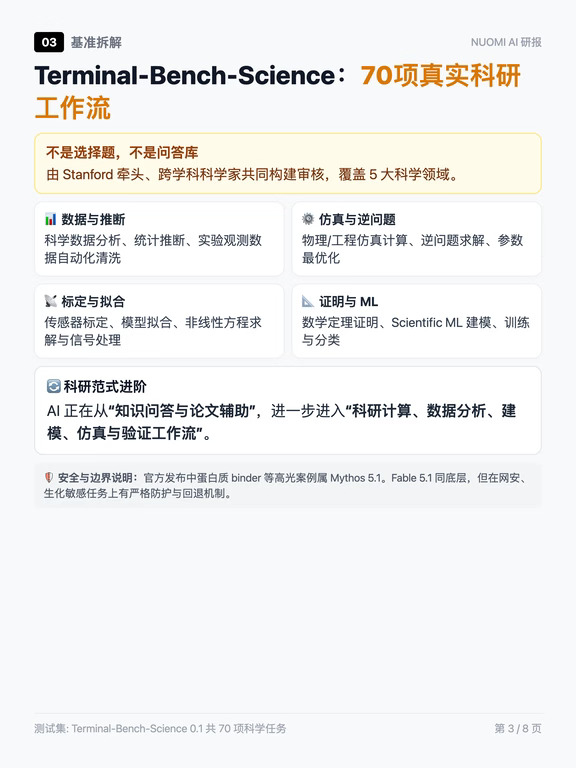
测试包含 5 大领域 70 项真实科研工作流,考的是数据分析、仿真计算、逆问题、传感器标定、模型拟合、定理证明等真动手算的硬活。
AI 开始从“读文献改格式”往前挪了一步,能帮科研人员分担计算、建模与验证了。人的精力更多留在提假设、判断物理可行性与最后把关上。(注:蛋白质高光案例属 Mythos 5.1,Fable 5.1 在网安和生化方向有严格防护)。
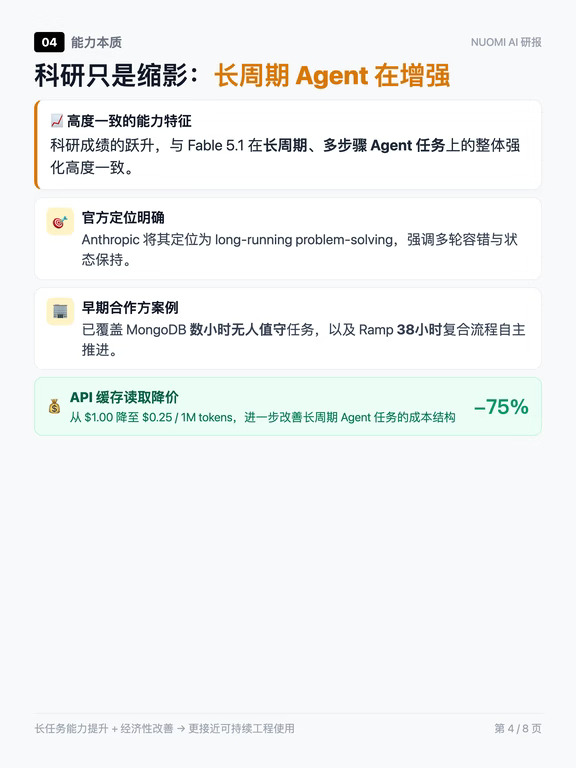
科研成绩翻倍和长周期 Agent 强化是一回事。官方定位为 long-running problem-solving,早期合作方覆盖数小时无人值守任务与 38 小时流程。加上 API 缓存降价 75%,长任务成本结构明显改善。
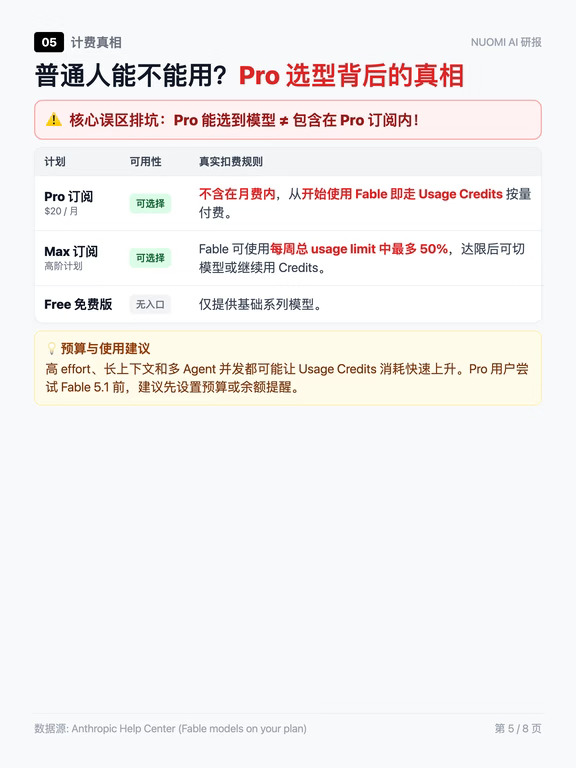
再聊聊大家最容易踩的坑:账单。
必须划重点:Pro 能选到模型 ≠ 包含在 Pro 订阅里!
在 Pro 里切到 Fable 5.1,第 1 条消息开始走 Usage Credits 按量扣,每月 20 刀月费不抵扣。Max 则是每周总 limit 中最多 50% 可用,用满后切模型或继续走 Credits。
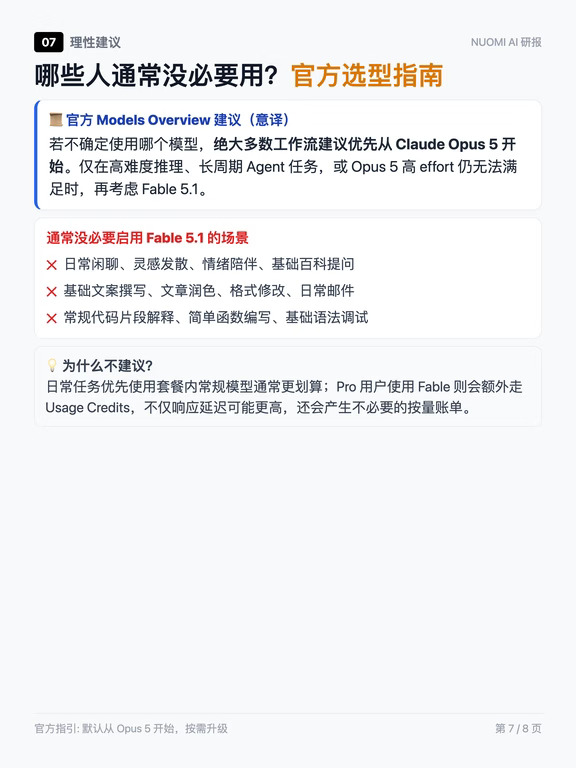
所以别盲目冲:日常聊天、文案润色、简单代码问答,用套餐内常规模型最划算。高 effort 加长上下文 Credits 掉得飞快,Pro 用户尝试前先设好余额提醒。
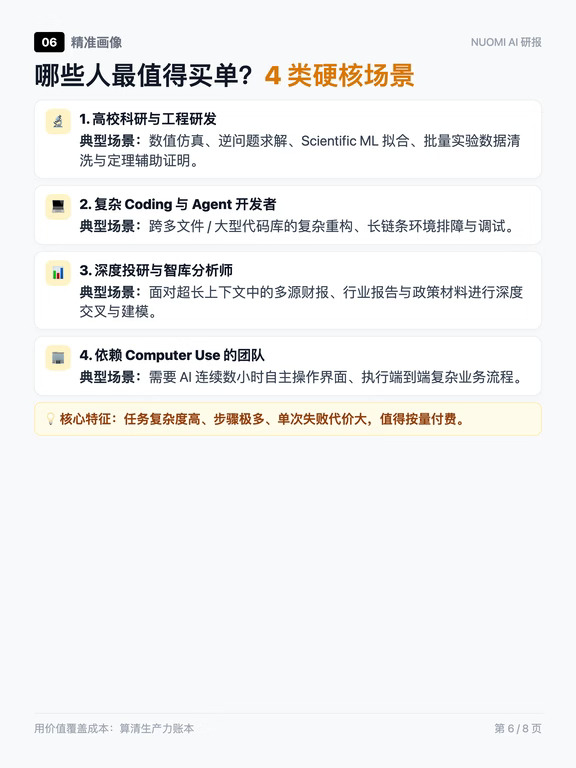
只有这几类才值得单独掏钱:复杂科研与仿真研发、跨多文件大型代码库重构、超长上下文投研分析,或让 AI 连续跑几小时的自动化团队。
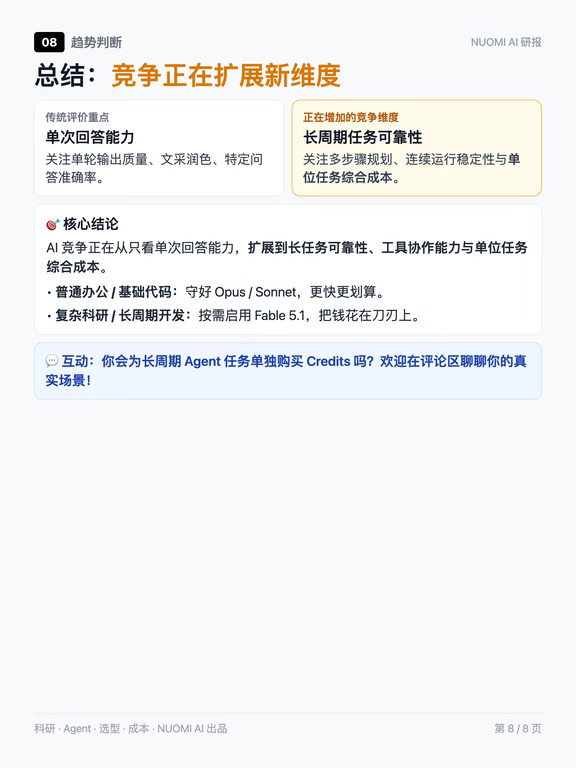
AI 比拼正在从只看单次回答能力,扩展到长任务可靠性与综合执行成本。把钱花在刀刃上,比什么都强。
#Claude #Fable51 #Anthropic #AI科研 #AIAgent #大模型测评