之前断言DSH(DeepSeek Harness)的缓存高,虽然API价格上涨,但可能相比在其他Agent工具上用DS的价格大差不差。
但是,这里会有一个问题。会不是是因为DSH把所有历史都线性塞进上下文,所以缓存比例才这么高呢?那么就算缓存高,因为上下文爆炸,实际上成本还是提高了。
我也担心这个问题打脸,所以研究了下DSH的上下文处理方式。
DSH官方插件的上下文处理机制,实际上已经和CODE/CC的机制大差不差,都有工具调用结果的处理,不会在解决相同问题下,上下文相比其他AGENT暴涨的情况(不至于几倍那样)。
各个Agent的上下文组织优化都谈不上多极限,或者说 ,大家目前都没把精力放在这上面,毕竟Token用的更多,收入更多嘛。
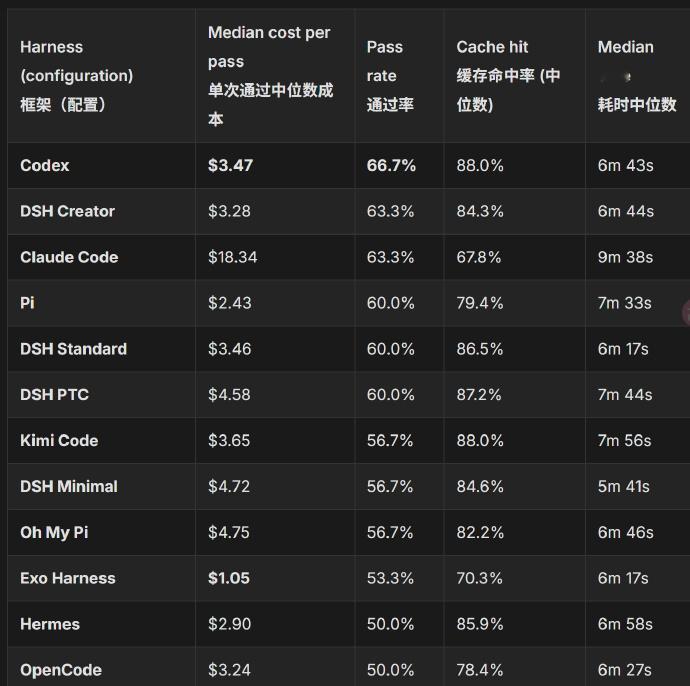
真正可以证明DSH上下文没有比其他Agent更多的,是下面9月1日发布的测试(图1)网页链接不同Agent统一用的。
因为统一使用KIMI的大模型,缓存率大差不差,平均上下文近似平均成本DSH的成本、通过率、时间都和CODEX差不多然而A/仍然是A/,因为有故意破坏缓存的机制,通过率甚至不占优的情况下,价格是CODEX和DSH的5倍。还在用CC的各位有福了。(话说咱也是DSH出来后才跳车的,之前相比CODEX确实更适合我的领域)
如果再考虑使用不同的模型,比如DSH与CODE/CC各自原生大模型缓存价格的对比,DSH的成本优势会更明显。因为DS自家大模型的缓存价格极其便宜,是其他大模型的10%以下。
同时是DS自身模型新输入的1/30,新输出的1/90。所以理论上,只要某个上下文片段在30轮以内对解决问题有贡献,那么最好是保留在上下文中成为稳定前缀,持续命中缓存更好,而不是像其他Agent那样压缩上下文,一方面破坏缓存的稳定前缀,还可能损失有效信息,导致解决问题的轮次增加。
要知道增加一轮新输入相当于缓存30轮,新输出相当于缓存90轮。换句话说,如果一个上下文在30轮以内对成功率有贡献,那么压缩并不一定对最终成本更优。
进一步考虑到,根据人类目前社会运行的组织架构方式,现在的Agent上下文组织方式还有很大的优化空间。DSH运行的方方面面更灵活透明,可以轻松对上下文组织进行优化,从收益/成本来看,DSH必然是长期最优的选择。大家都可以试试自己编排或者找一点插件用上试试。