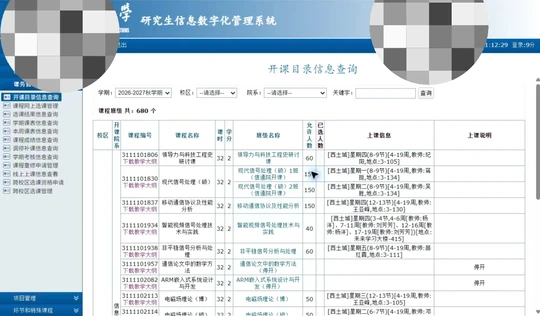
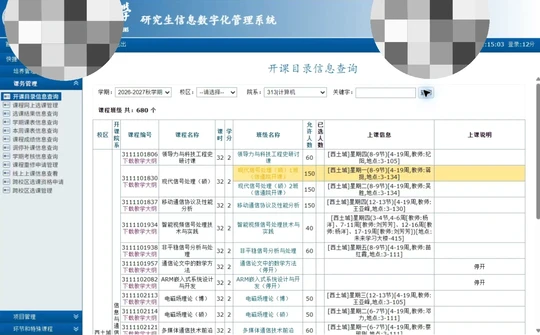
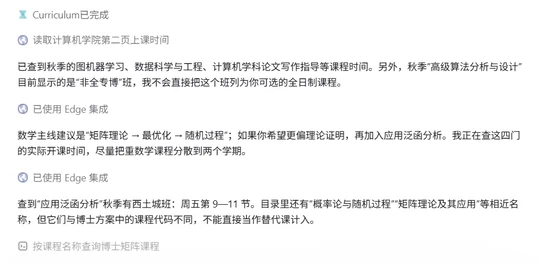
起因是主包昨天突发奇想,GPT6-Astra发布同期,Openai宣称其computer use能力实现大幅度跃升;Codex是否可以帮助我甚至直接操纵我的教务网站实现选课的自动化呢?然后,主包目前手头只有博士培养方案/研究生教务网站账密,突然意识到研究生课选课实际是一个长距离的多步规划computer use问题(长距离多步:agent需要阅读培养方案pdf,进行学分规划,课程时间排表等),且没有一个特定的workflow去指导agent(所有教务系统都老旧且按钮位置/名称/网页架构都不同)。
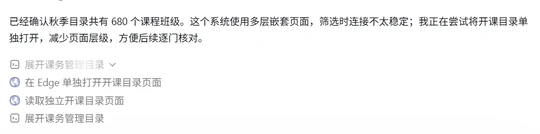
结论:在配备必备工具以及浏览器插件的情况下,Codex目前不能够完全实现对国内大学老旧教务页面的操控(比如无法在教务页面下载教学大纲pdf,刷新被浏览器阻拦等问题);然而,其长链逻辑思维能力依旧是惊艳的(总共处理了1h左右),能够实现从培养方案读取,学分规划,课程时间排布(一直在操纵鼠标点按筛选课程按钮和搜索按钮进行课程搜索),免修筛选(这个很重要,主包免修英语,事先prompt中都忘说了,他从培养方案中检查出并告知了我)。
目前的主要问题有:
1.教务系统网页并非是全新的,而是老旧的,因此代码结构和目前的网页代码结构可能有所不同,导致gpt6无法理解并无法解析问题;
2.gpt6极爱刷新页面,刷新后网页会触发保护机制,导致刷新后白屏,任务中断;
3.gpt6极爱读取网页源码,这一操作极其浪费时间和token,既然是操纵鼠标,那就直接操纵就好。
综上所述,在选课任务上,面对复杂的教务系统选课环境,即使是最新的最强的模型搭配最新的harness依旧无法解决人类能够解决的computer use问题。
CourseBench: Benchmarking LLM Agents in Interactive Course Registration Environments
Introduction: 近年来,大语言模型智能体逐渐从静态问答走向真实信息系统中的自主决策与操作。然而,现有基准主要关注网页导航、软件操作和通用工具调用,难以系统评估智能体在复杂规则约束下进行信息检索、长期规划与交互执行的能力。
选课系统为此提供了一个具有代表性的测试环境:智能体不仅需要理解课程要求、时间冲突、容量限制和先修关系,还需要根据用户目标制定方案,并在动态系统状态下完成操作。
为此,我们提出 CourseBench,一个面向选课系统的智能体评测基准。CourseBench 构建了覆盖选课规划、约束推理、系统操作与异常恢复的多类任务,并从任务成功率、规则遵循、交互效率和决策鲁棒性等维度进行评估。#大模型 #选课 #机器学习 #科研