酥悠沫评
大模型竞赛进入 2026 年下半年,一个明显的趋势是:各家开始从"全能选手"转向"专项冠军"。OpenAI 的 GPT-5.6 系列分出 Sol、Terra、Luna 三个变体,Anthropic 的 Claude 系列在 Opus 和 Sonnet 之间拉开定位,DeepSeek 则继续在 Pro 和 Flash 两条线上并行推进。
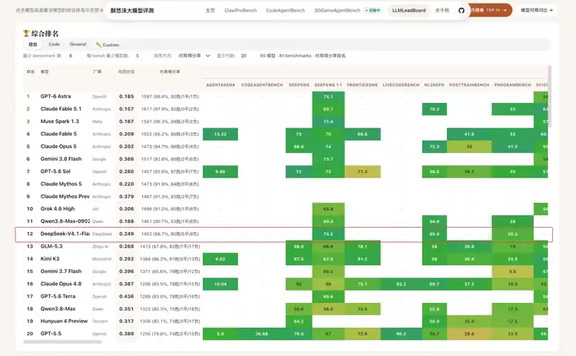
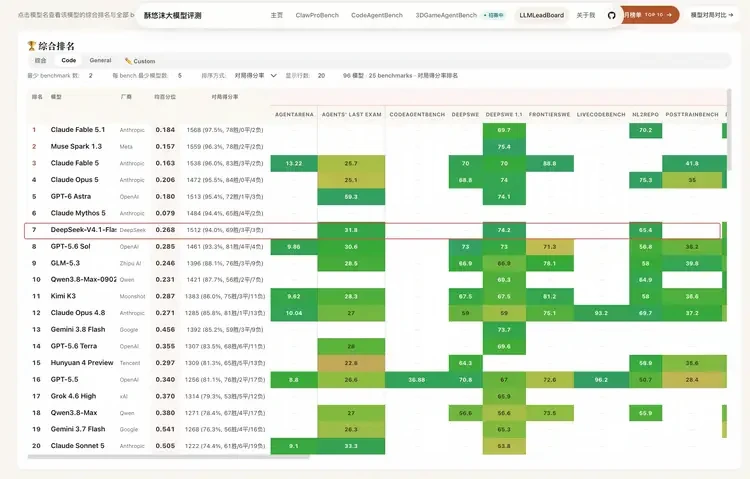
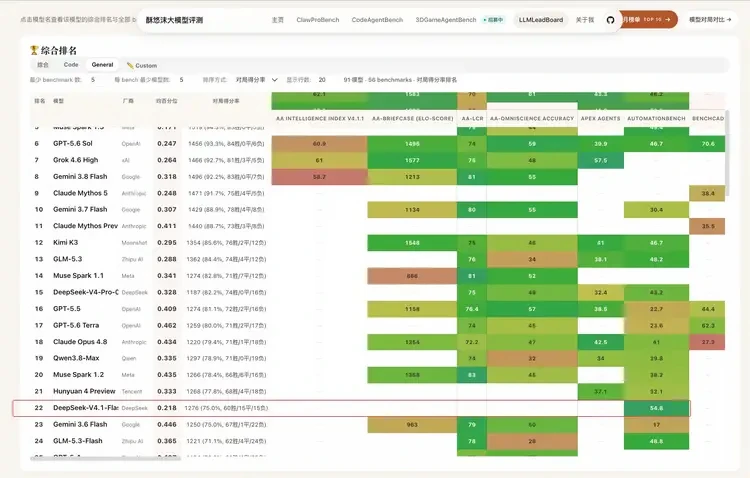
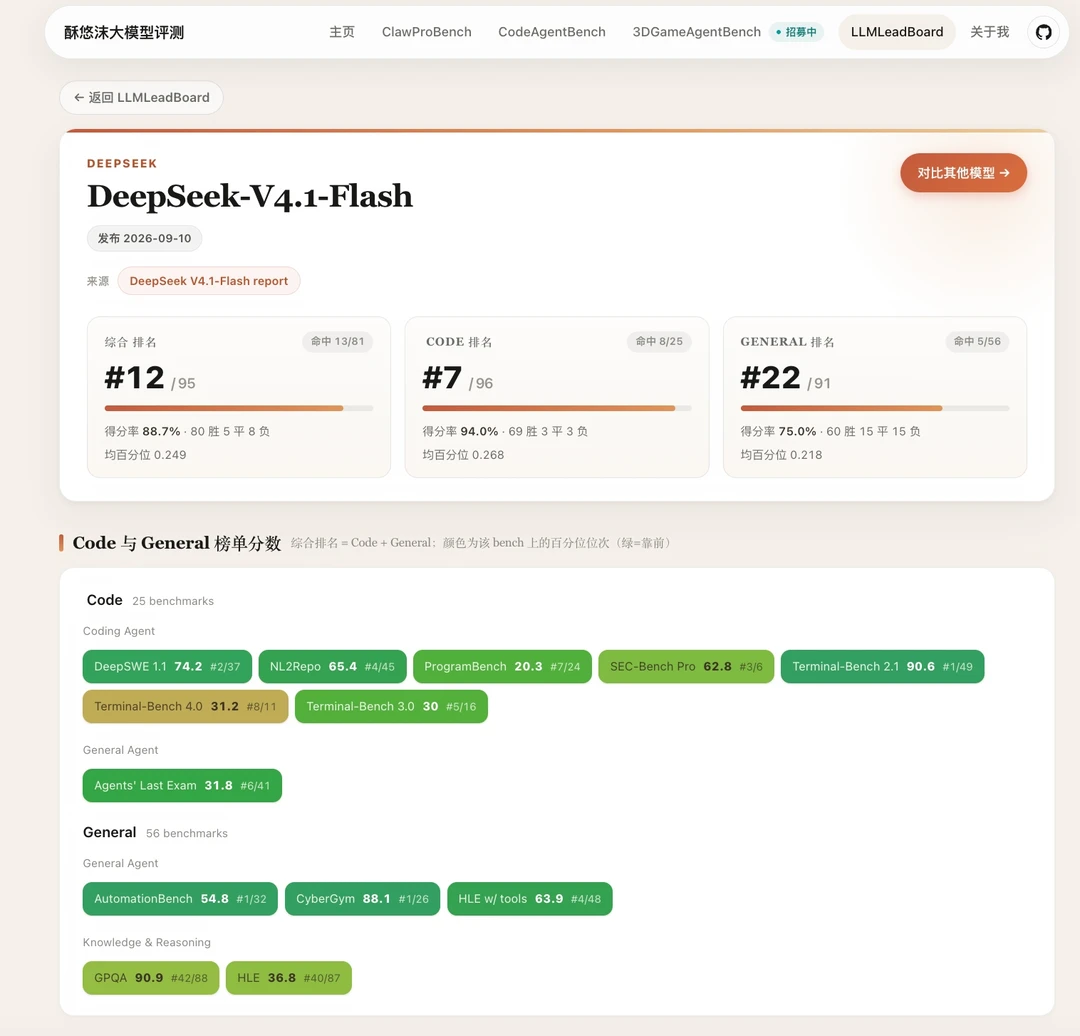
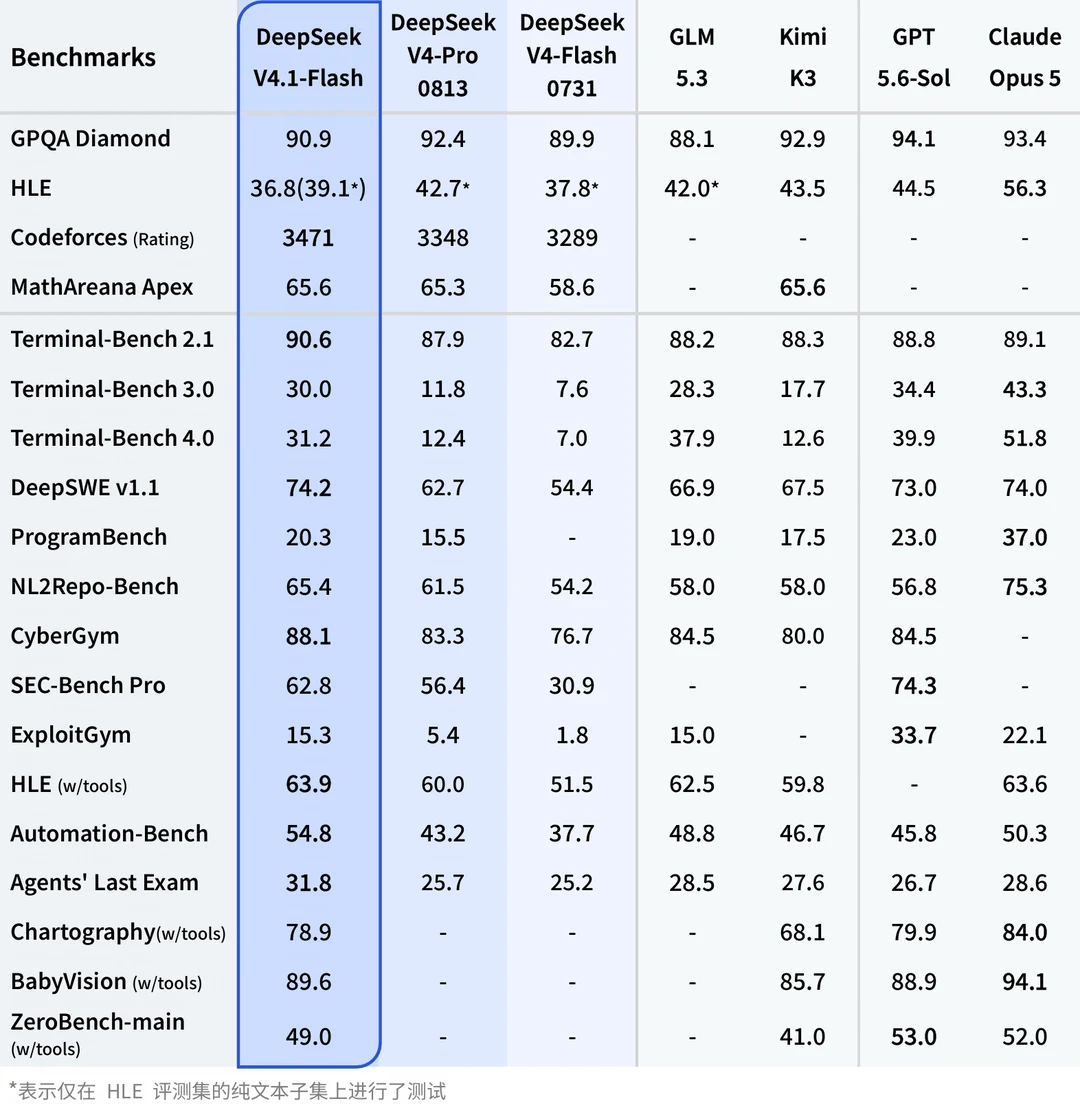
V4.1-Flash 的选择很明确:不做全能冠军,做工程场景的利器。Terminal-Bench 2.1 的 90.6 分、Codeforces 的 3471、Automation-Bench 的 54.8 分——这些数字指向同一个画像:一个能在真实开发环境中干活的模型。它不擅长做高中物理竞赛题(HLE 36.8),但它能帮你修 bug、写代码、操作终端、调用工具。对于大多数开发者来说,后者可能比前者更有用。
这种"偏科"策略让人想起《庄子》里的话:"匠石运斤成风,听而斫之,尽垩而鼻不伤。"匠人的斧头不是万能的,但在它擅长的领域,精准到可以削去鼻尖上的白土而不伤皮肤。V4.1-Flash 就是这样的斧头——它不追求在所有 benchmark 上都拿高分,而是在编程和 Agent 这两个对开发者最实用的维度上做到极致。
当然,偏科也有代价。综合排名第 82 位的数字不好看,HLE 36.8 的分数在竞品面前显得单薄,Terminal-Bench 从 2.1 到 4.0 的性能衰减也暴露了复杂任务处理能力的不足。DeepSeek 需要在后续版本中补齐这些短板,否则 V4.1-Flash 可能只是一个"好用的工具",而不是一个"全面的助手"。
#大模型评测 #大模型评估 #大模型 #智谱 #酥悠沫大模型评测 #claude #gpt #基座大模型 #大模型基座 #deepseek #人工智能发展 #kimik3 #kimi #moonshot #stepfun #阶跃星辰 #阶跃 #deepseek #deepseekv41 #deepseekv4
#deepseekv4发布#deepseekv4pro