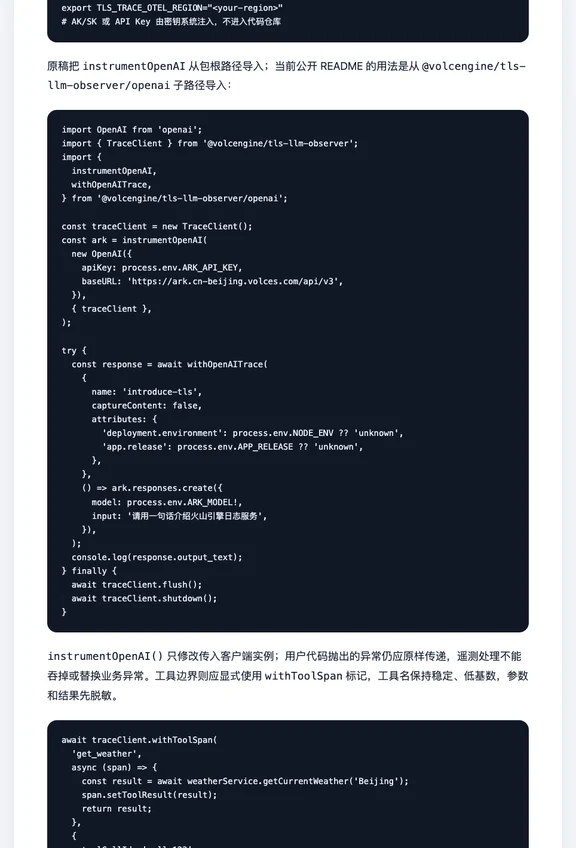
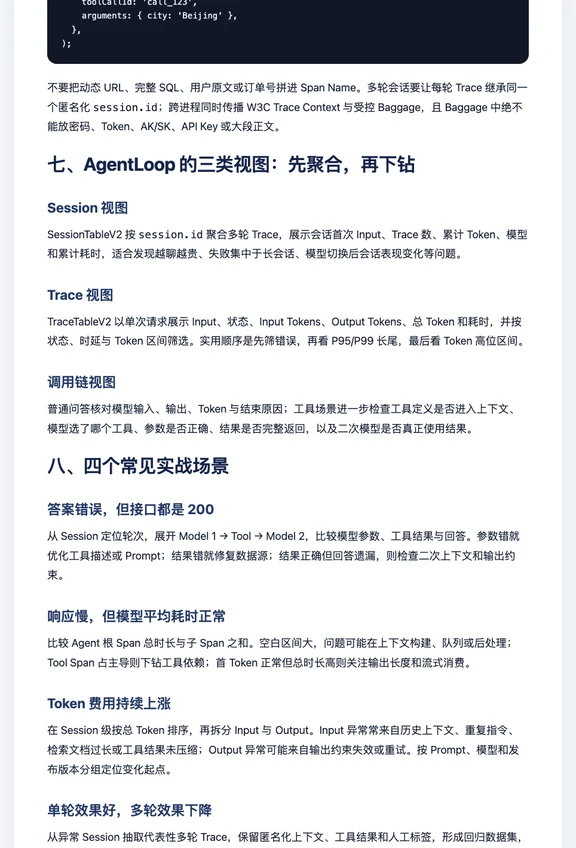
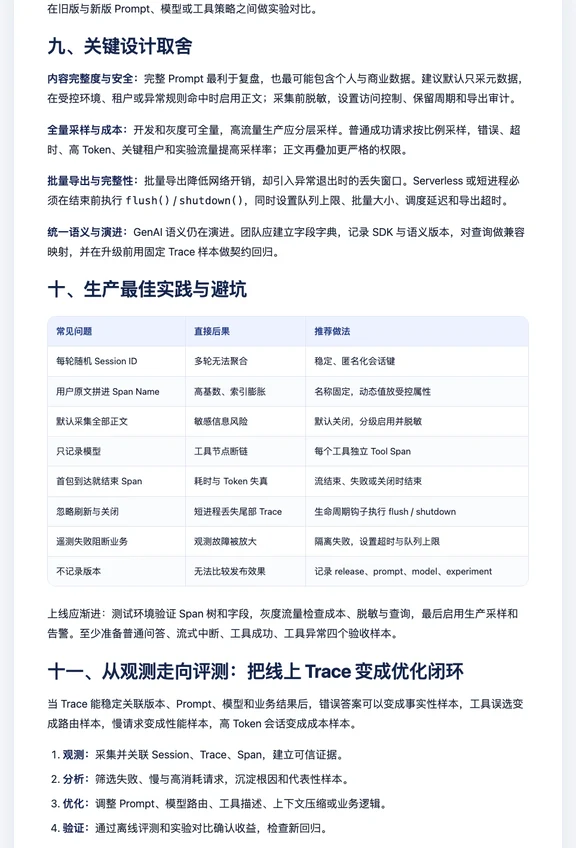
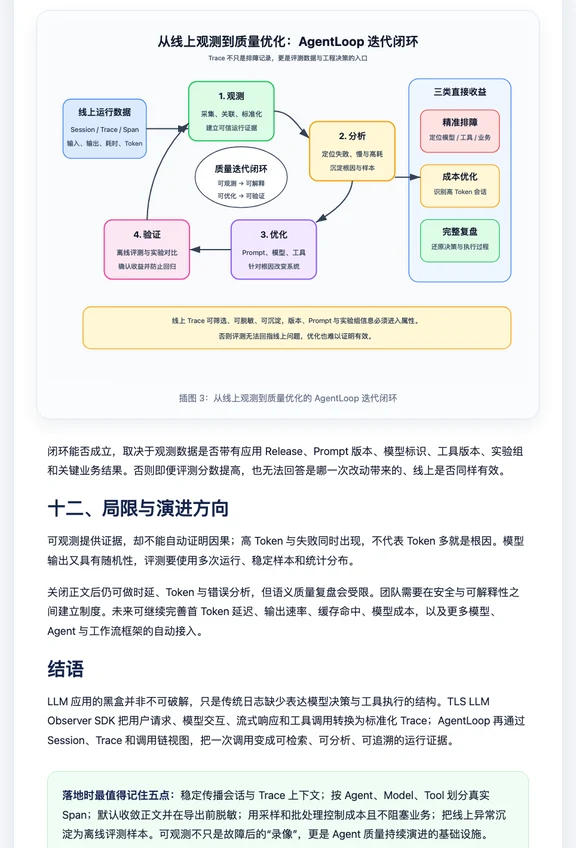
当一个回答背后同时发生上下文拼装、两次模型推理、一次工具调用和一次结果改写时,单条“请求成功”日志几乎没有解释力。LLM 可观测的目标不是多记几行日志,而是把一次会话中的模型决策、工具执行、Token 消耗、时延与错误组织成可关联、可查询、可回放的证据链。本文以火山引擎日志服务 TLS、TypeScript LLM Observer SDK 与 AgentLoop 为主线,拆解从埋点、标准化、传输、存储到复盘和评测的完整工程方法。
核验边界(2026-09-14):npm 公共仓库可核验 @volcengine/tls-llm-observer 最新版本为 0.0.1,要求 Node.js 18+,支持 OpenAI 兼容客户端、Responses、流式响应、工具调用、内容采集开关与 OTLP/TLS 导出配置。AgentLoop 的页面名称和功能描述以用户提供的产品稿件为依据,具体入口与字段以实际租户控制台为准。火山引擎公开材料对 TLS 英文展开存在历史命名差异,本文统一使用“火山引擎日志服务 TLS”。
一、真正的黑盒,不只是“模型为什么这样回答”
传统 Web 请求通常有比较稳定的因果链:入口收到参数,服务执行业务规则,数据库返回结果,接口组装响应。即使发生故障,应用日志、APM Trace 和数据库审计通常也能把问题定位到某个函数、SQL 或下游接口。
LLM 应用不同。一次表面上的问答,可能先读取十几轮历史消息,再完成 Prompt 模板拼装;模型第一次返回工具调用意图,应用执行搜索、数据库或 MCP 工具;模型收到工具结果后再次推理,最后还可能经过内容安全、格式化和兜底逻辑。最终答案只有几十个字,背后却是一棵带分支的执行树。
因此,线上问题会以新的方式出现:回答错误,但模型请求、工具执行和接口状态都显示成功;总耗时突然增加,却不知道慢在首轮模型、工具还是二次总结;Token 成本上涨,普通业务日志只记录调用次数,无法解释上下文膨胀来自哪一轮;单轮 Trace 看起来正常,但多轮会话中模型持续携带了错误上下文;工具返回正确,模型却遗漏了关键字段,或者选择了错误工具。
#howto入门codex #howto入门vibecoding #AI反常识howto #SOP框架课代表 #ai #多模态人工智能 #大模型 #用户体验优化