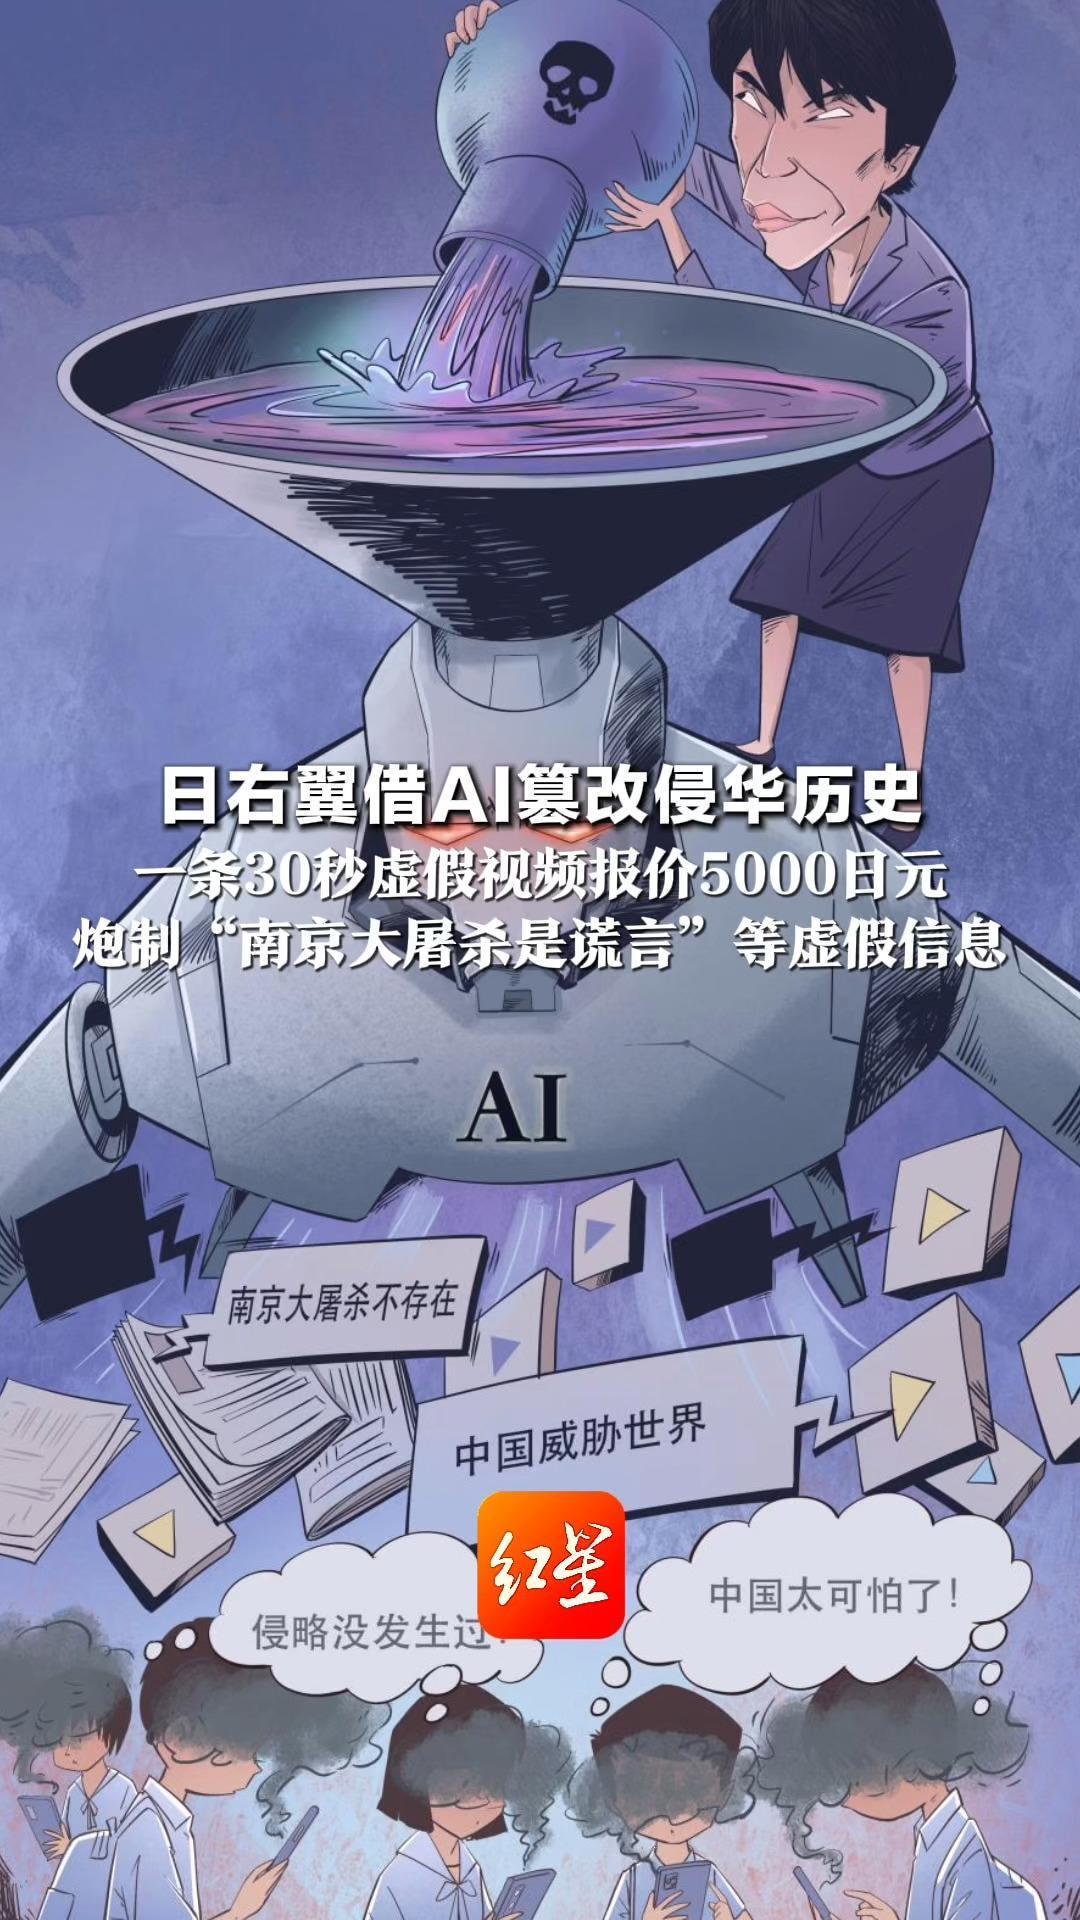
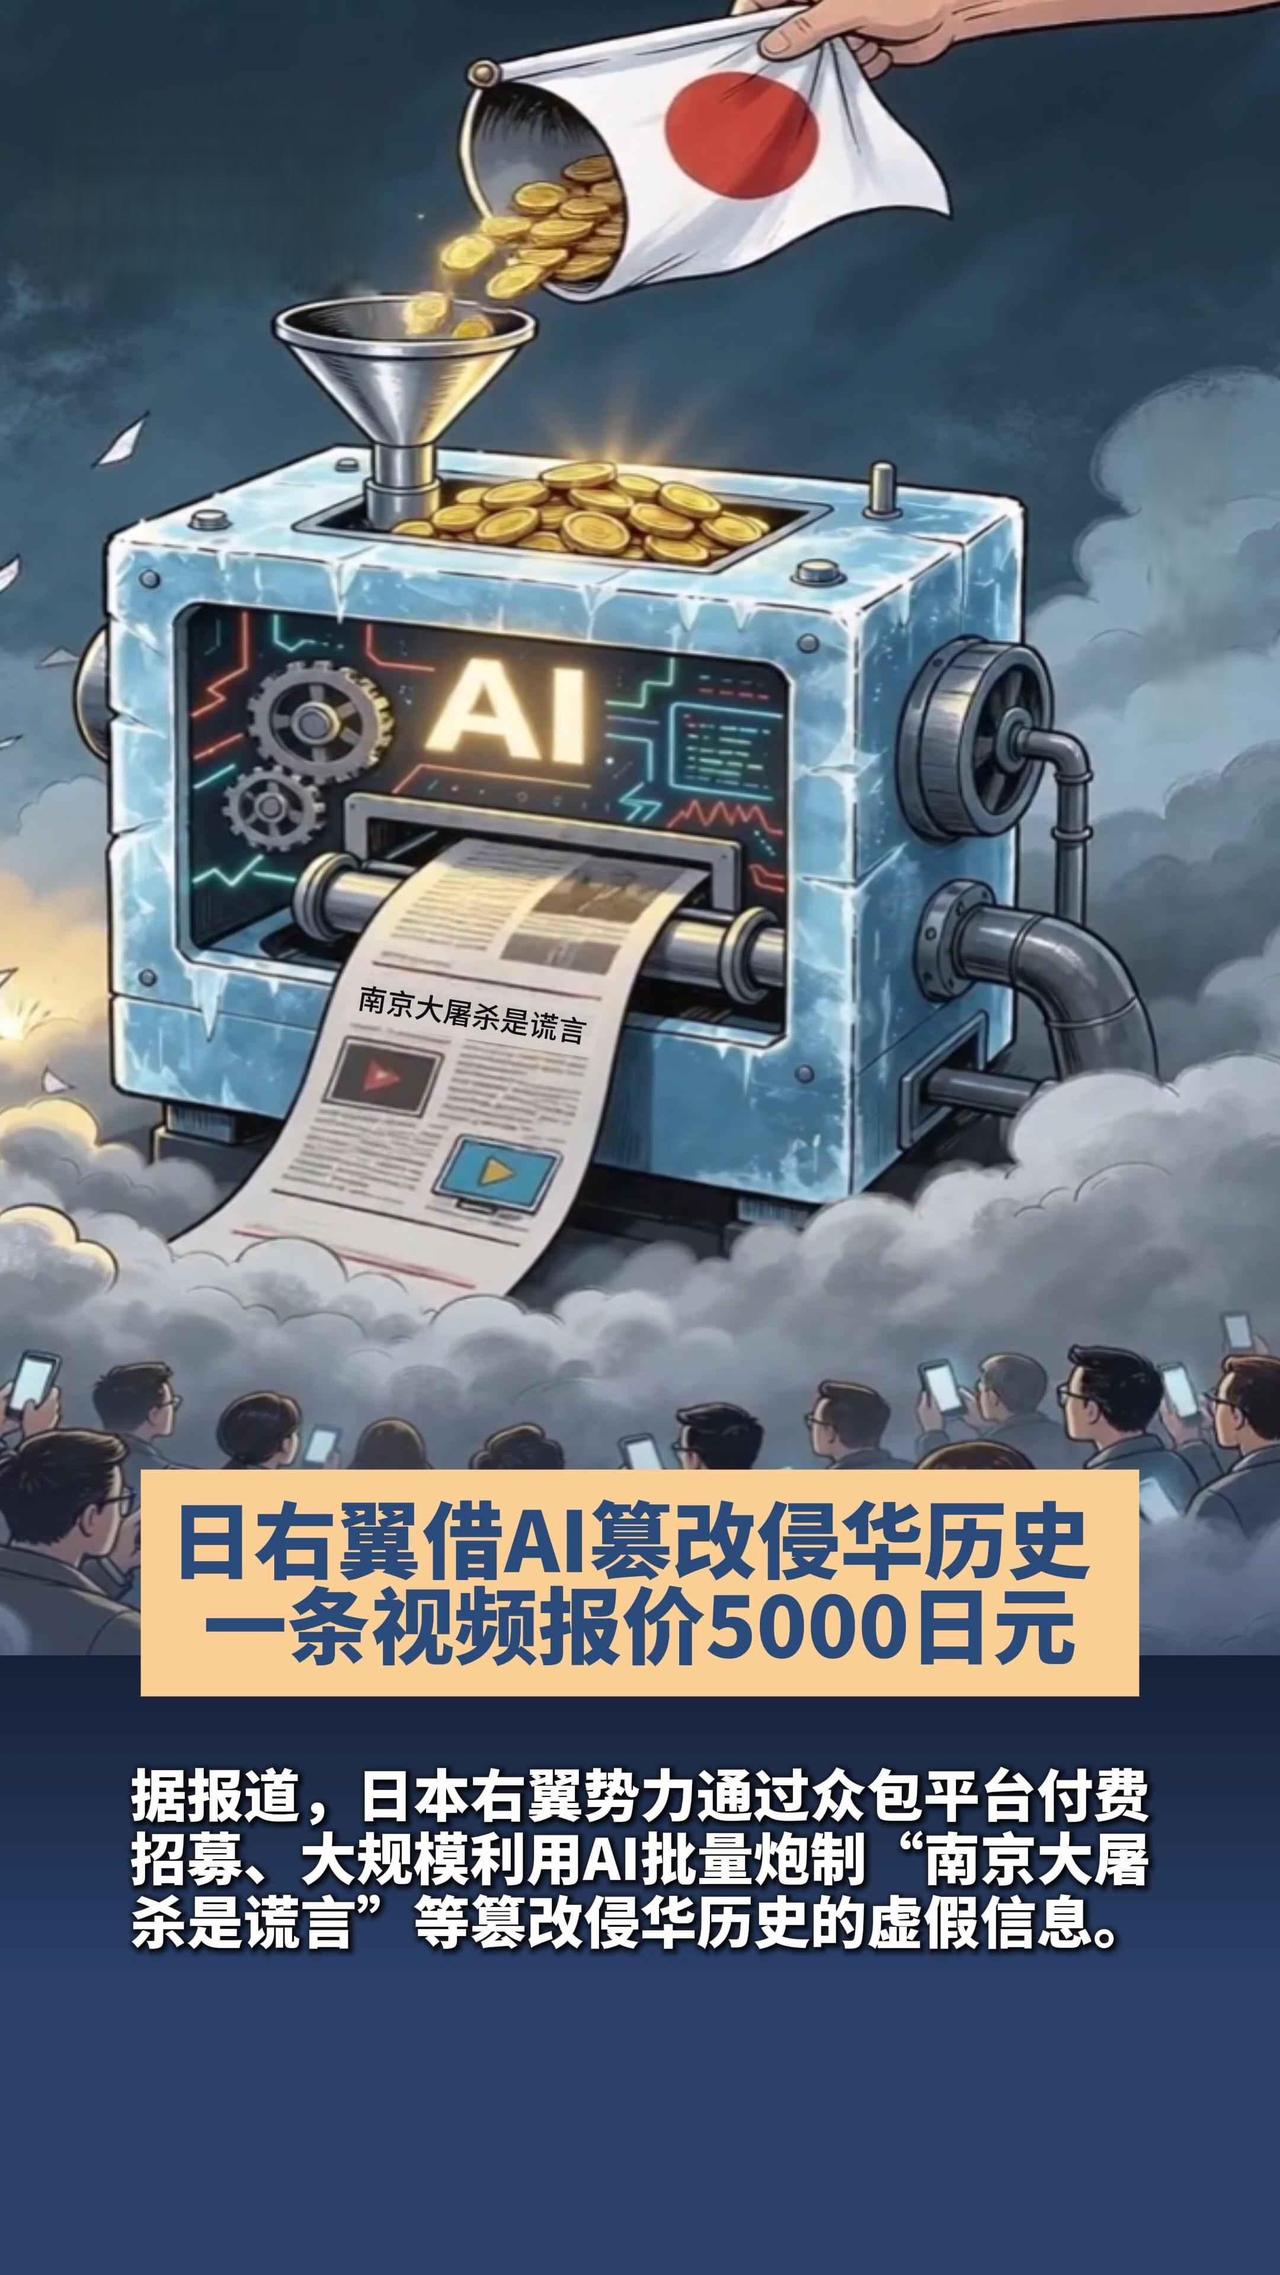
日本篡改历史还不够,又盯上了AI?如果连大模型都开始改写二战真相,几十年后的年轻人还知道南京大屠杀吗?
如果有一天,年轻人不再翻历史书,而是直接问人工智能:“南京大屠杀到底发生过什么?”而AI给出的答案却模棱两可,甚至把已经有大量档案、照片、证词和审判记录的历史,说成“存在争议”,我们该怎么办?
这才是今天真正值得警惕的问题。
最近,网络上出现了一些针对人工智能历史问答的测试,部分模型在使用不同语言、不同资料来源提问时,对南京大屠杀等历史问题给出的回答并不完全一致。有的会强调遇难人数存在不同统计口径,有的则会大量引用日本方面的官方表述。
当历史进入人工智能时代,数据来源和信息权重本身,就可能影响人们看到的历史。
日本在历史教科书问题上的争议,却确实存在了几十年。
日本文部科学省公开资料显示,日本实行教科书审定制度。历史上,日本教材对于侵略战争、南京大屠杀等问题的表述,也曾长期引发国内外争议。上世纪80年代,日本教科书审定问题甚至成为东亚外交争议的一部分。美国斯坦福大学关于日本历史教材争议的研究也记录了相关过程。
而今天,战场正在从纸质教材转向互联网和人工智能。
过去,一个日本年轻人看到怎样的历史,可能取决于老师怎么讲、教材怎么写;今天,一个美国学生、欧洲学生,甚至一个普通中国年轻人,可能直接打开AI问一句:“二战时期日本在南京做了什么?”
问题就来了。
AI并不是历史学家。它不会像人一样真正“记住”1937年发生了什么,它只是根据训练数据、检索结果、资料来源和算法规则生成答案。如果网络上某一种说法数量更多、传播更广,或者某些来源在检索体系中权重更高,那么AI就可能更容易把这些内容呈现给用户。
这意味着,未来的历史争夺,可能不只是争夺教科书上的一句话,而是争夺数字世界里的资料入口。
南京市档案馆保存的1946年《南京首都地方法院检察处奉令调查敌人罪行报告书》,就记录了相关调查结果;国家档案局公布的调查材料中,也保存了大量被害人、证人和调查记录。
更重要的是,这些材料并不只有中国方面的单一来源。
联合国教科文组织已经将《南京大屠杀档案》列入《世界记忆名录》。相关档案包括1937年至1938年大屠杀期间形成的资料,也包括战后调查、战争审判以及相关司法档案。
所以,未来真正需要警惕的,不是某一个模型今天回答错了一句话,而是大量碎片化、来源不明甚至相互矛盾的信息进入人工智能之后,会不会让历史事实越来越模糊。
这才是AI时代最大的变化。
过去有人可以修改一本教材,但很难让全世界几十亿人同时看到同一本教材;现在,一个搜索引擎、一套推荐算法、一个人工智能模型,却可能在几秒钟之内把某种叙事传播给全世界。
因此,中国真正需要做的,也不是只在网上和别人争论一句“30万到底是多少”。
我们更应该把原始档案、战地照片、幸存者证词、日军日记、外国记者记录、战后审判材料全部数字化,建立可以被全球用户检索、交叉验证的历史数据库。
因为历史最有力量的地方,从来不是喊得有多大声,而是证据摆在那里。
南京大屠杀档案已经进入《世界记忆名录》,中国官方档案中保存着大量原始调查材料,近年来南京大屠杀遇难同胞纪念馆还持续从中国、日本、美国、英国、德国等国家征集新的文物史料。
这其实就是我们面对AI时代最重要的底气。
未来如果有人试图用算法模糊历史,我们就用档案说话;如果有人试图用数据制造争议,我们就把原始证据直接摆出来;如果人工智能回答出现错误,我们就让更多经过验证的史料进入数字世界。
技术本身没有历史立场,但数据可以决定它看见什么。
所以真正需要争夺的,不是谁能够把历史“写得更好听”,而是谁能够把真实、完整、可验证的历史保存下来,并让下一代人工智能能够找到它。
因为一个民族真正害怕的,从来不是别人提出质疑,而是有一天,世界上的机器开始找不到我们的证据。
历史不能靠情绪保存,只能靠证据传承。AI时代,我们要守住的不是一句口号,而是那些能够经得起全世界检验的历史档案。
参考来源:
联合国教科文组织:《南京大屠杀档案》
国家档案局:南京大屠杀调查档案
日本文部科学省:日本教科书制度