最近看到一个挺新的东西:Jev。
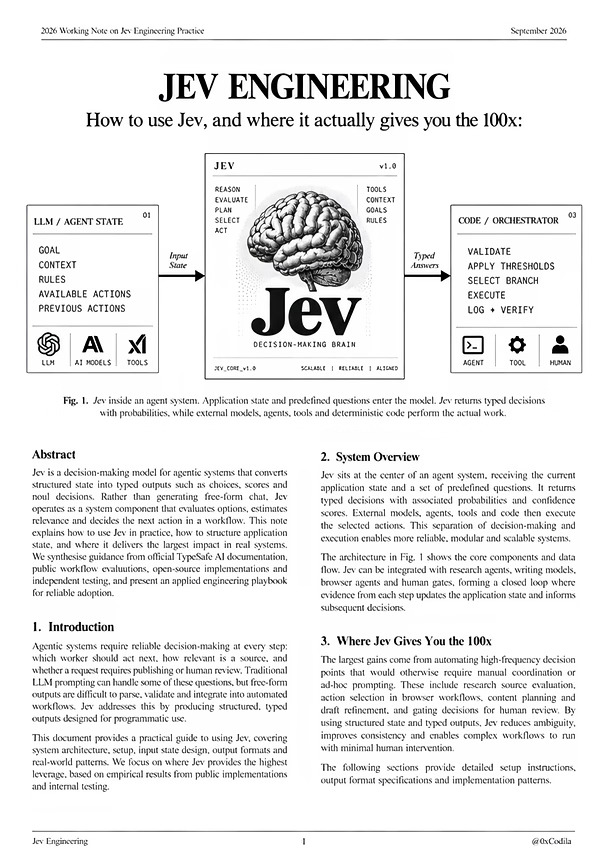
它和GPT、Claude走的路线不一样。GPT负责“想”和“写”,Agent负责执行,而Jev专门干中间那一步:
下一步该做什么?
TypeSafe把它叫做 System One Model。它不生成长篇文字,只输出软件能直接使用的结构化判断,例如:选哪个工具、风险有多高、这件事成立的概率是多少。
为什么这个方向值得看?
今天很多Agent其实很浪费。
每走一步,都可能重新叫一次昂贵的大模型:读状态→思考→选择工具→执行→再思考。
Jev的思路是把这些“小决定”拆出来,让一个非常快、非常便宜的模型处理;碰到复杂问题,再升级给GPT或Claude。
TypeSafe自己的测试里,Jev在特定System One工作流上最高做到 193.6倍更快、444.6倍更便宜。不过这个数字要打个星号:这是公司自己的benchmark,而且TypeSafe自己也承认,这是测试里偏高的一组结果,并不能直接理解成所有AI任务都能省400倍。
我觉得有意思的地方在架构变化。
以前大家追求:
一个越来越强的大模型解决所有问题。
现在可能开始变成:
大模型负责复杂推理和创造;
小型决策模型负责routing、判断和验证;
传统代码负责确定性计算;
Agent负责真正执行。
这样一来,每个任务都调用最贵模型,反而可能显得很笨。
而且Jev这个名字本身就来自经济学家Jevons。TypeSafe押的也是那个经典逻辑:
智能越便宜,我们最后使用的智能可能越多。
如果一次AI判断的成本下降两个数量级,公司未必会少买算力。
以前一个流程调用10次AI,未来可能调用1000次。
所以这件事对AI投资的启发挺有意思:
下一阶段大家竞争的,也许不只是“谁的模型最聪明”。
谁能把每一次智能调用变得足够便宜、足够快,AI才真正有机会塞进每一段软件流程里。
Jev现在还很早,early access刚开始,我不会因为一个benchmark就下结论。
但这个方向我会继续跟。
Agent时代的下一个效率突破,可能来自“别什么事都让大模型亲自干”。
#人工智能 #AI #AIAgent #大模型 #OpenAI #Claude #AI投资 #科技股