AI算力的血管:光互联,看不见的高速大动脉!
一台AI服务器能不能跑得快,不只看芯片有多强,还要看数据能不能及时送到。
大模型训练和推理时,成千上万颗芯片同时交换数据,芯片负责计算,光互联负责传输。没有足够快、足够稳定的连接,算力就像堵在路上的汽车,再大的发动机也跑不出速度。
这也是光互联容易被忽略的原因,它不像GPU那样直接出现在聚光灯下,却默默承担着AI数据中心里最关键的“搬运”任务,算力规模越大,芯片之间传输的数据越多,这条通道就越不能掉链子。
不少人把光互联简单理解成光模块,仿佛只要把光模块做出来,整条产业链就算完成了。也有人看到NPO、CPO等新名词,就觉得这只是市场炒作,热闹一阵便会过去。
问题在于,光互联从来不是某一个单品的故事,而是一套完整的系统。光芯片、无源器件、光引擎、光模块,再到承担远距离传输任务的特种光纤,任何一环出现短板,最终都会影响整条链路的性能和稳定性。
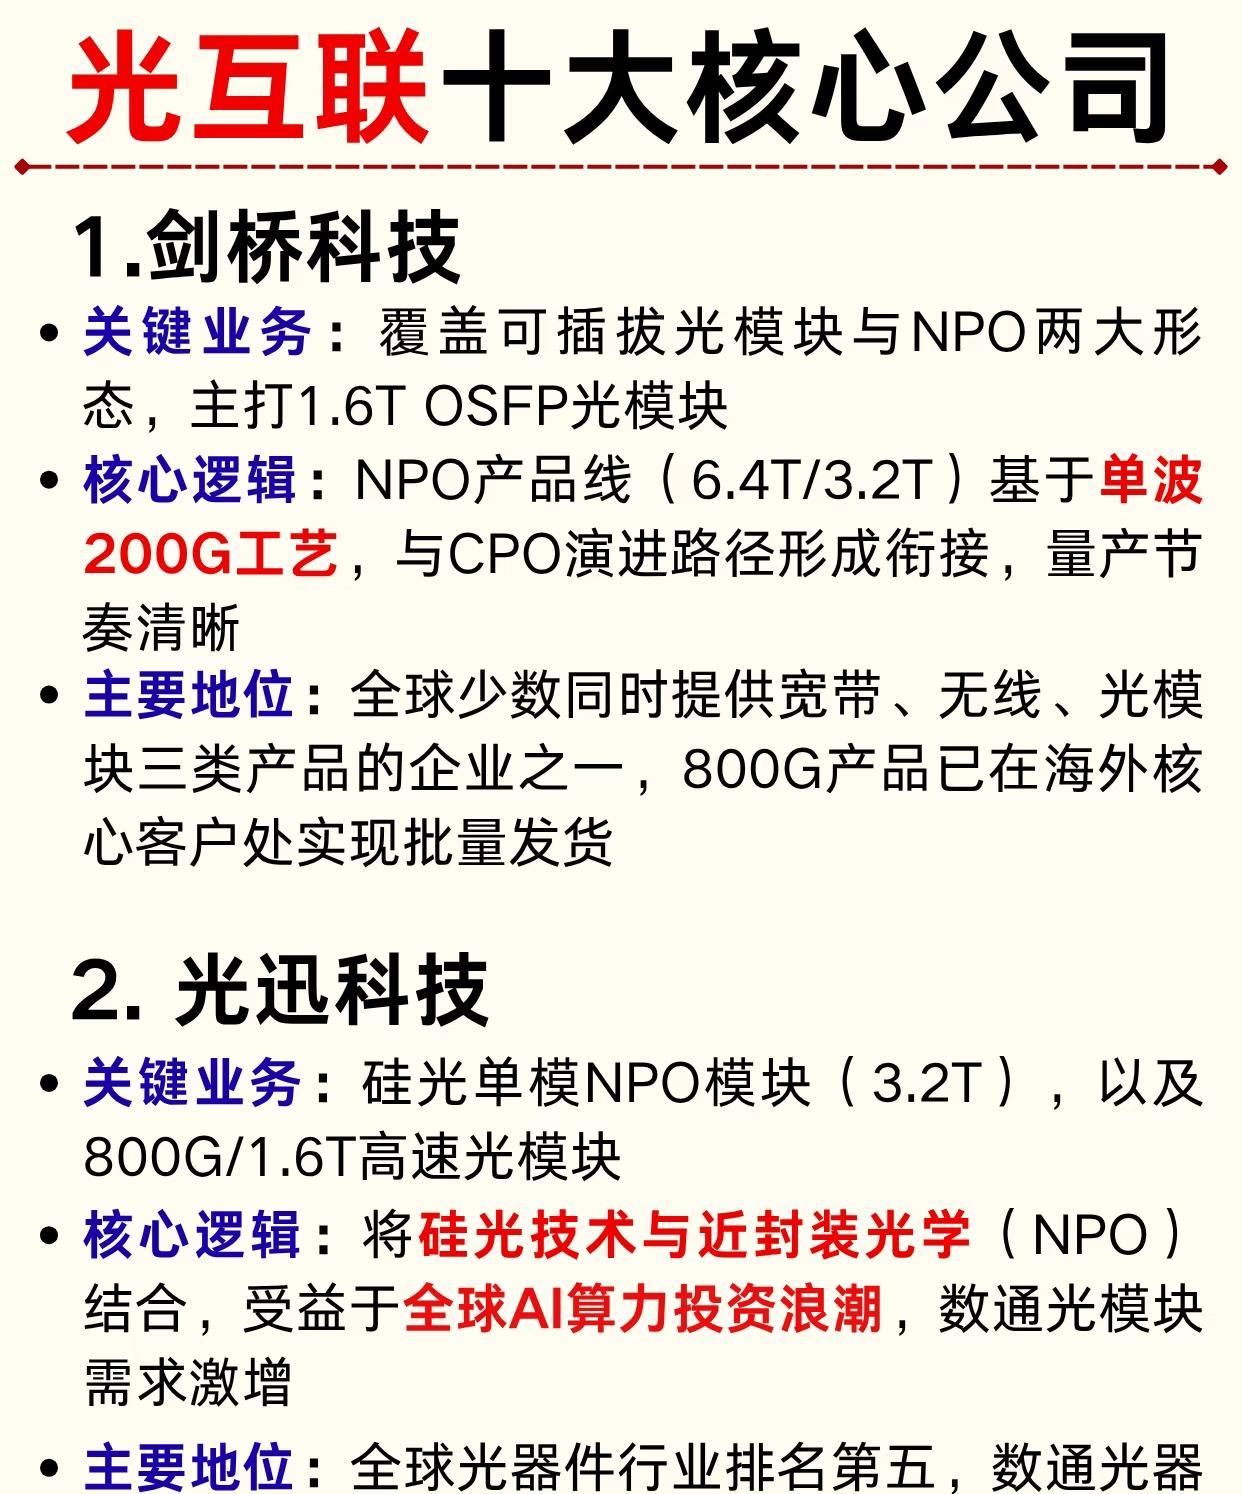
AI集群的数据流量正在快速增长,传统传输方案逐渐碰到瓶颈,产业因此不断向更高速度推进,从1.6T到3.2T,未来还可能进一步走向6.4T。数字看起来只是规格升级,背后却意味着芯片、封装、散热、信号完整性和制造工艺都要同步跟上。
NPO和CPO的出现,也不是凭空冒出来的新概念,它们的共同思路,是让光器件更靠近计算芯片,尽量缩短信号传输距离,降低损耗和功耗,同时释放更大的带宽空间。
传统光模块通常通过较长的电连接与芯片相连,速度越高,信号损耗和能耗越明显,NPO、CPO则试图把光引擎或相关器件放到更靠近芯片的位置,减少中间环节。这样做有机会突破传输瓶颈,但也会带来封装、维护、可靠性和量产难度等新问题。
所以,行业真正比拼的不是谁能提出一个更响亮的概念,而是谁能把技术稳定地做出来、交付出去,并经受住真实应用场景的长期考验。
从产业链看,上游掌握着不少关键能力,激光器、AWG等光芯片和无源元器件,决定着信号处理与传输的基础性能。相关器件的精度、良率和稳定性,往往直接影响中下游产品能不能顺利落地。
中游是光引擎和高速光模块,它们要完成电信号与光信号之间的转换,是技术走向产品的重要环节。规格参数再漂亮,如果不能批量生产,或者无法满足客户对可靠性、寿命和成本的要求,最终也很难真正进入数据中心。
再往下游,是特种光纤,它承担着更长距离的数据传输任务,看似只是“线”,却并不是普通网线的简单升级。随着速率不断提高,光纤材料、结构设计和传输损耗都会变得更加重要。
这三部分并非各干各的,上游决定性能天花板,中游决定产品能否落地,下游决定数据能不能稳定跑远,AI算力的传输底座,正是由这些看不见的环节共同撑起来的。
光互联这几年也走过一段从火热到冷静的路,前两年,高速光模块受到市场追捧,相关概念频频登上热搜,行业情绪一度非常高涨。到了热度退去,大家开始重新追问:哪些产品已经具备批量交付能力,哪些还停留在样品或实验室阶段?
这个问题并不难理解,光器件的研发不是做出样品就结束了,还要经历反复测试、工艺改进、客户验证和规模生产。客户愿意采购,也不代表马上就能形成大规模应用,产品还要在稳定性、良率、成本和交付能力之间找到平衡。
很多新技术看上去只差临门一脚,真正走到产业化,却可能还要跨过几道门槛,概念传播可以很快,一夜之间就能刷屏;产业落地却慢得多,往往需要长时间验证。这个节奏差,正是市场情绪容易反复的地方。
更现实的一面是,AI的发展不会只带来对计算芯片的需求,也会持续推高对网络连接和数据传输的要求,模型越大,集群越复杂,芯片之间越需要高效交换数据。计算能力在往前冲,传输能力也必须跟上,否则算力规模越大,系统内部的“拥堵”反而越明显。
光互联或许不会一直处在最热闹的位置,但它的重要性不会因为市场降温就消失,真正有价值的技术,往往不是靠短期概念取胜,而是在一次次测试和交付中慢慢站稳。
说到底,AI的速度不只写在芯片上,也藏在那些不容易被看见的连接里,算力负责创造能力,光互联负责让能力真正流动起来。
本文仅作行业科普交流,不构成任何投资或方向建议。产业发展仍有不确定性,面对热点,少一点追涨,多一点耐心。