我终于串起了三类RL方法
前面把 Reward、Return、Value、Q、Advantage 一路学下来,我却一直有个问题:这些东西到底拿来干嘛?直到学到 Value-based、Policy-based 和 Actor-Critic,我才发现它们终于都有位置了。
先看 Value-based。
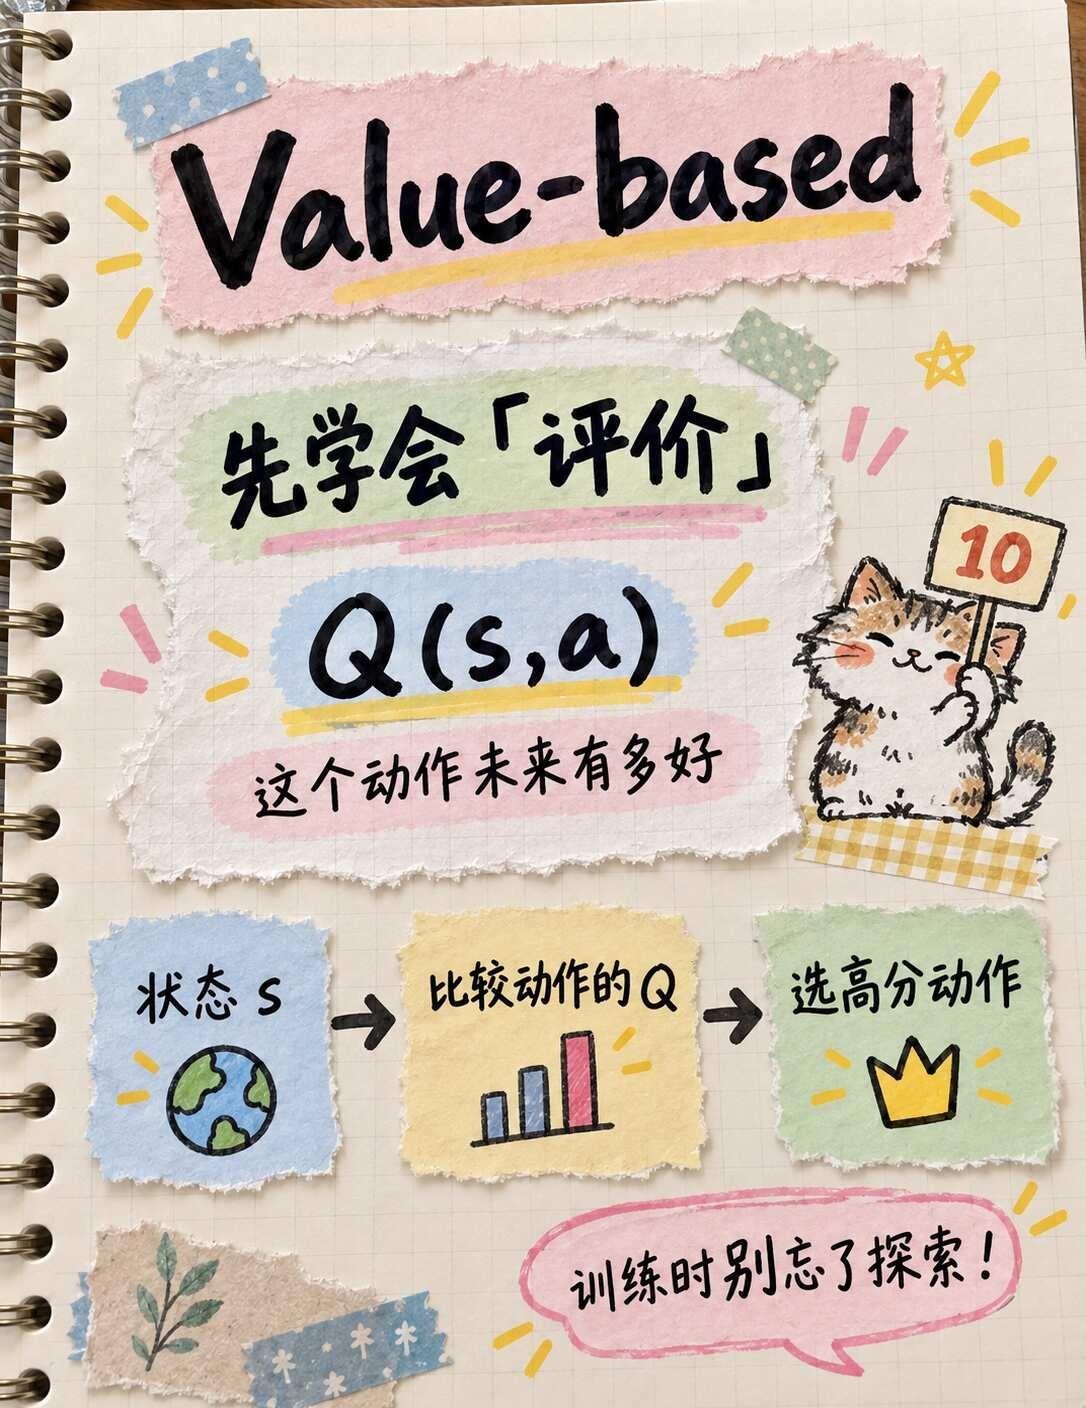
Q(s,a) 表示:在状态 s 做动作 a,之后能拿到的期望回报。决策也很自然——比较动作的 Q,选择分数高的。
所以很多 Value-based 方法是先学“评价”,再根据评价决策。像 Q-learning,就是更新 Q,再选出 Q 最大的动作。当然训练时仍要探索,不会一直只选最高分。
但我接着又想:一定要先算每个动作的 Q,再挑最大的吗?
不一定。
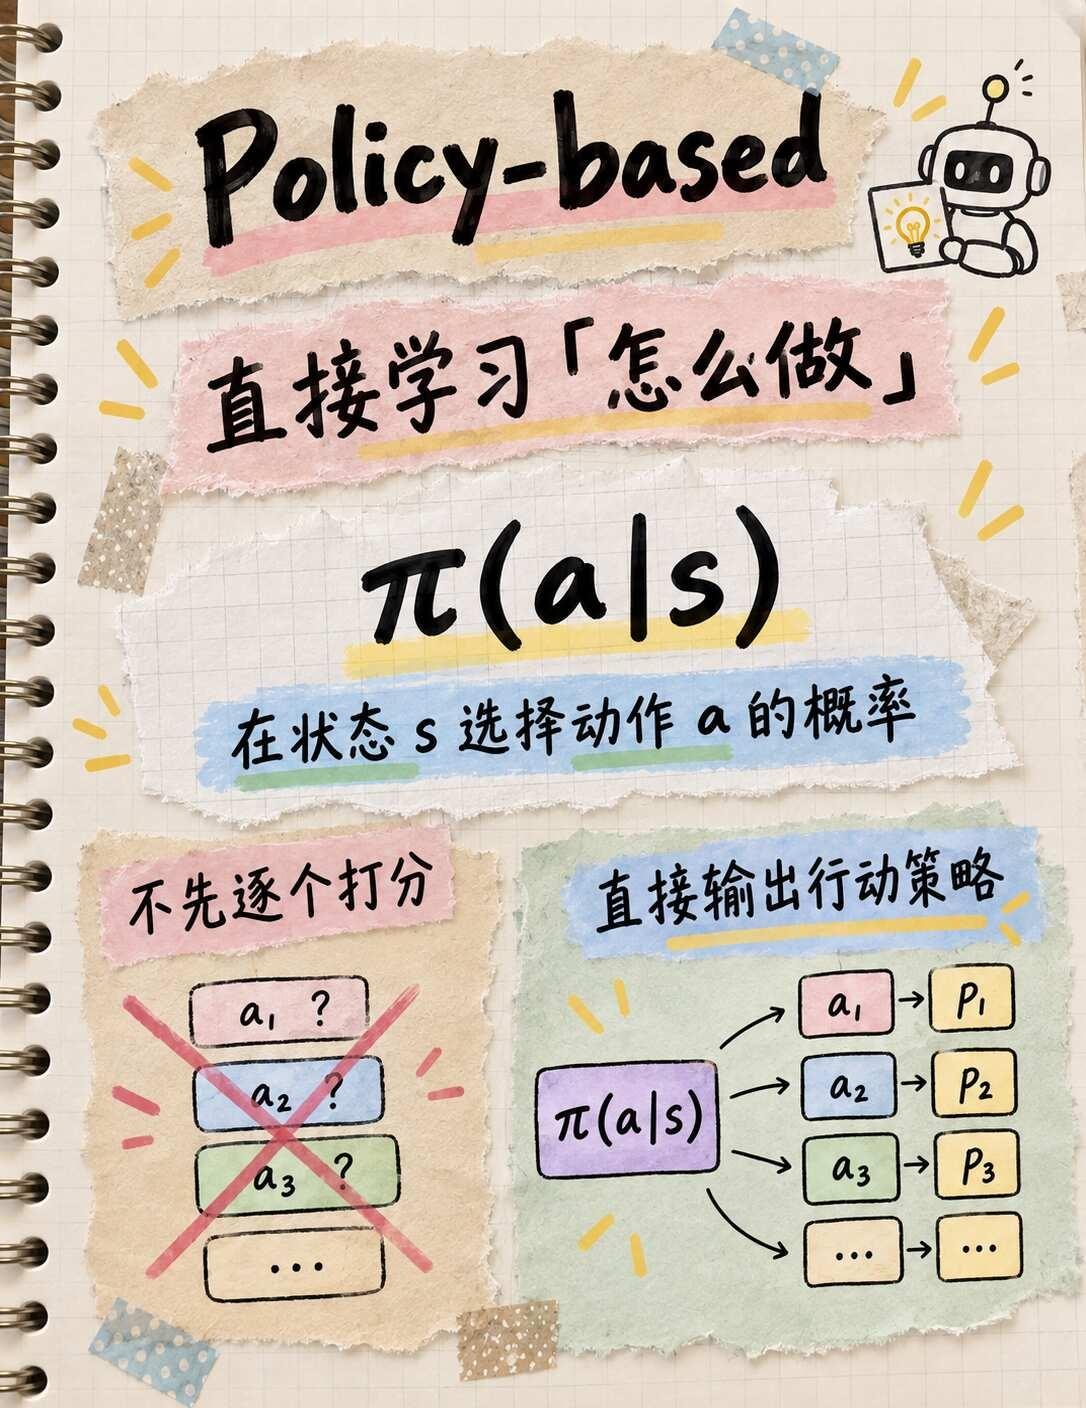
Policy-based 直接学习策略 π(a|s):到了状态 s,各动作应该以多大概率被选择。它直接回答“我该怎么行动”,不用把所有动作列出来逐个比较。
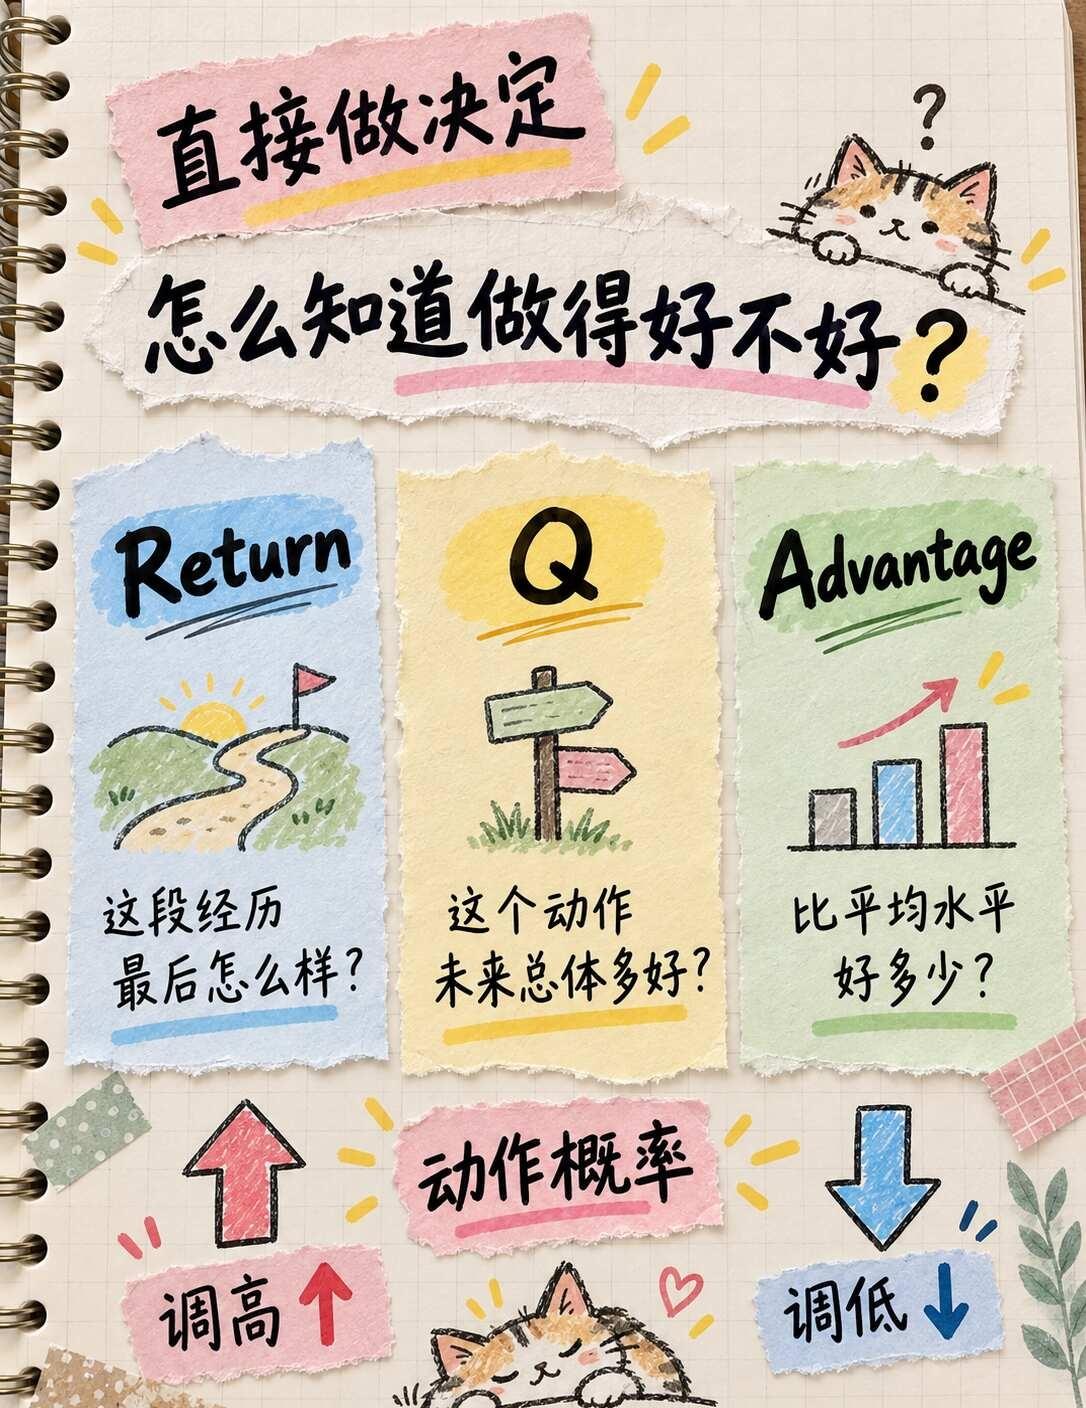
可新的问题马上出现了:策略做完决定,怎么知道该把哪个动作的概率调高?
评价信号又回来了。
Return 能看这段经历最终得到多少回报;Q 能判断动作后的长期表现;Advantage 能判断它比当前策略的平均水平好多少。结果越好,动作以后被选中的概率就该越高。
这时再看 Actor-Critic,就不神秘了:
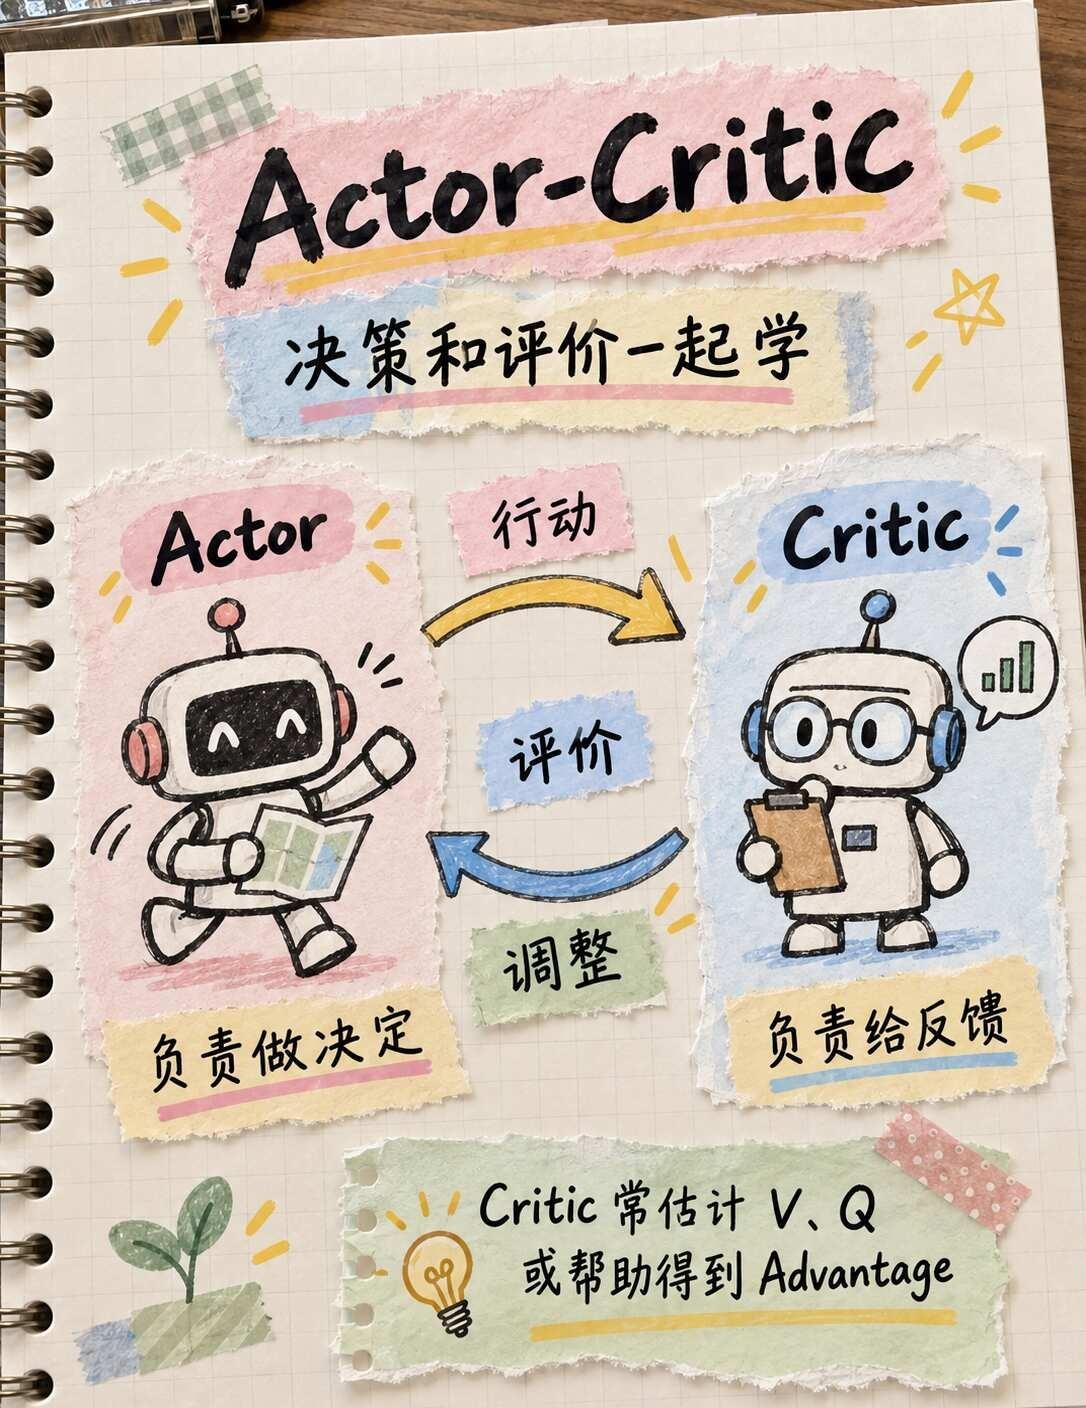
Actor 是策略,负责决定;Critic 负责评价,常估计 V、Q,或帮助得到 Advantage。Actor 根据反馈调整,Critic 也用新经验修正判断。
所以我现在会把强化学习中的很多方法,先放进两个问题里理解:
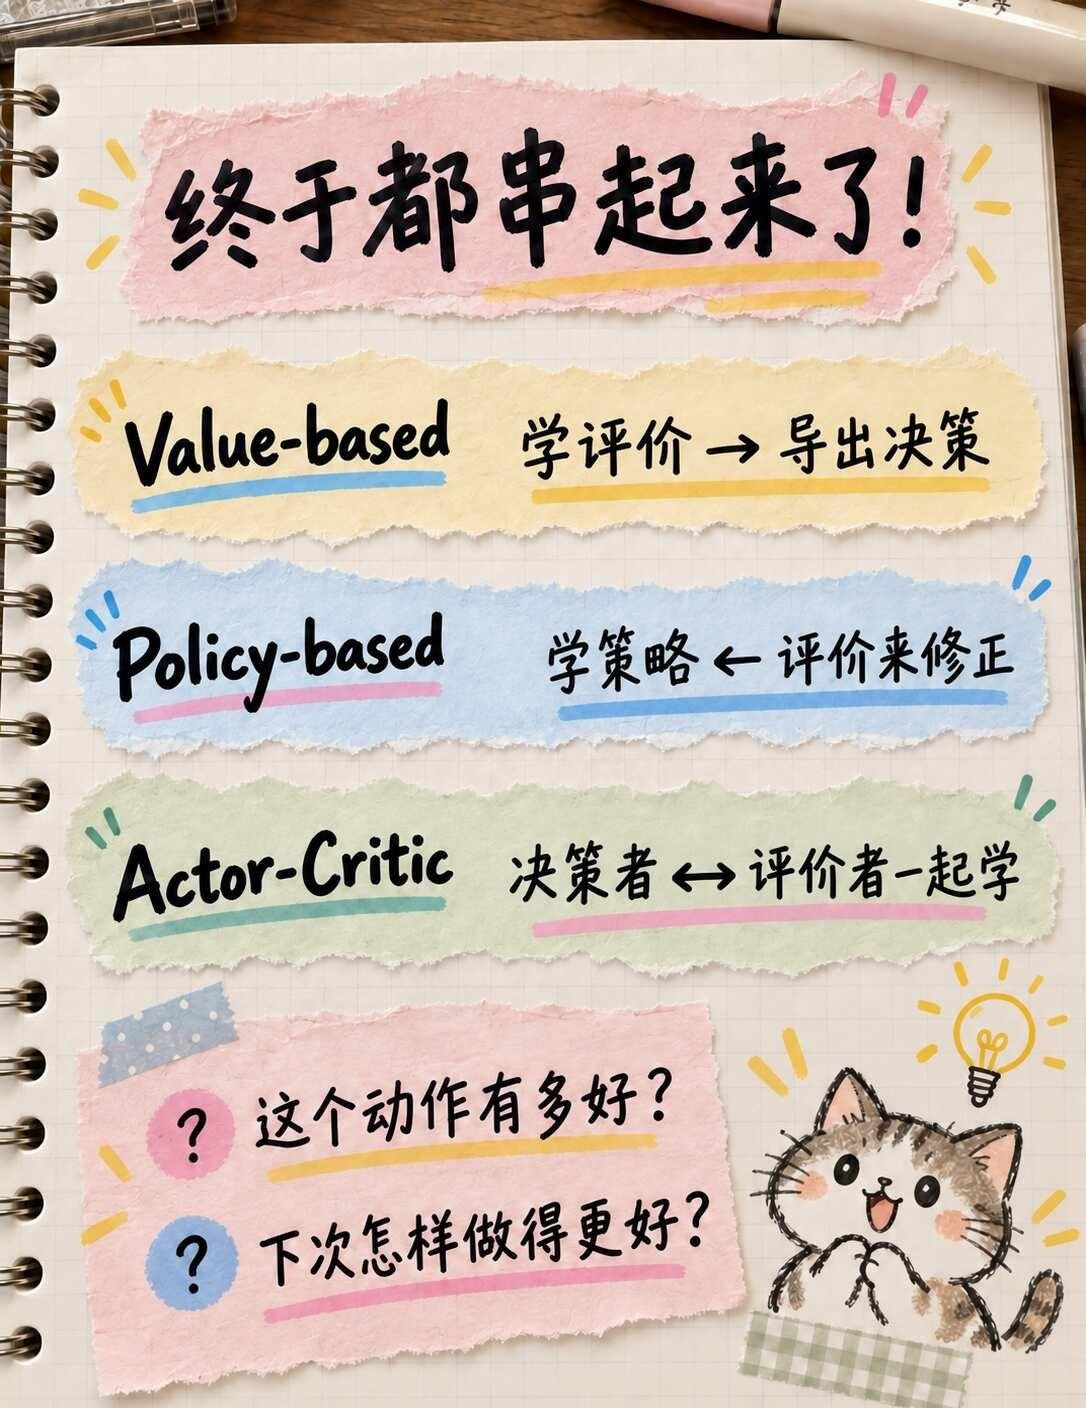
① 怎么评价一个动作?
② 怎么利用评价,做出更好的决策?
Value-based:重点学习价值,再由价值导出决策。
Policy-based:直接学习策略,用回报或价值相关信号修正策略。
Actor-Critic:同时学习决策者和评价者,让两者配合更新。
这只是帮助入门的主干图,不同算法的边界并不绝对。但有了这条线,我再看 Value、Q 和 Advantage,就不觉得它们是一堆孤立公式了。
它们一直在回答:刚才这个动作有多好?而算法接着关心:知道好坏后,我该怎么做得更好?
强化学习 AI学习 机器学习 ActorCritic PolicyGradient AI全栈