一个Bug跑100+次,对话清晰度到底影响什么
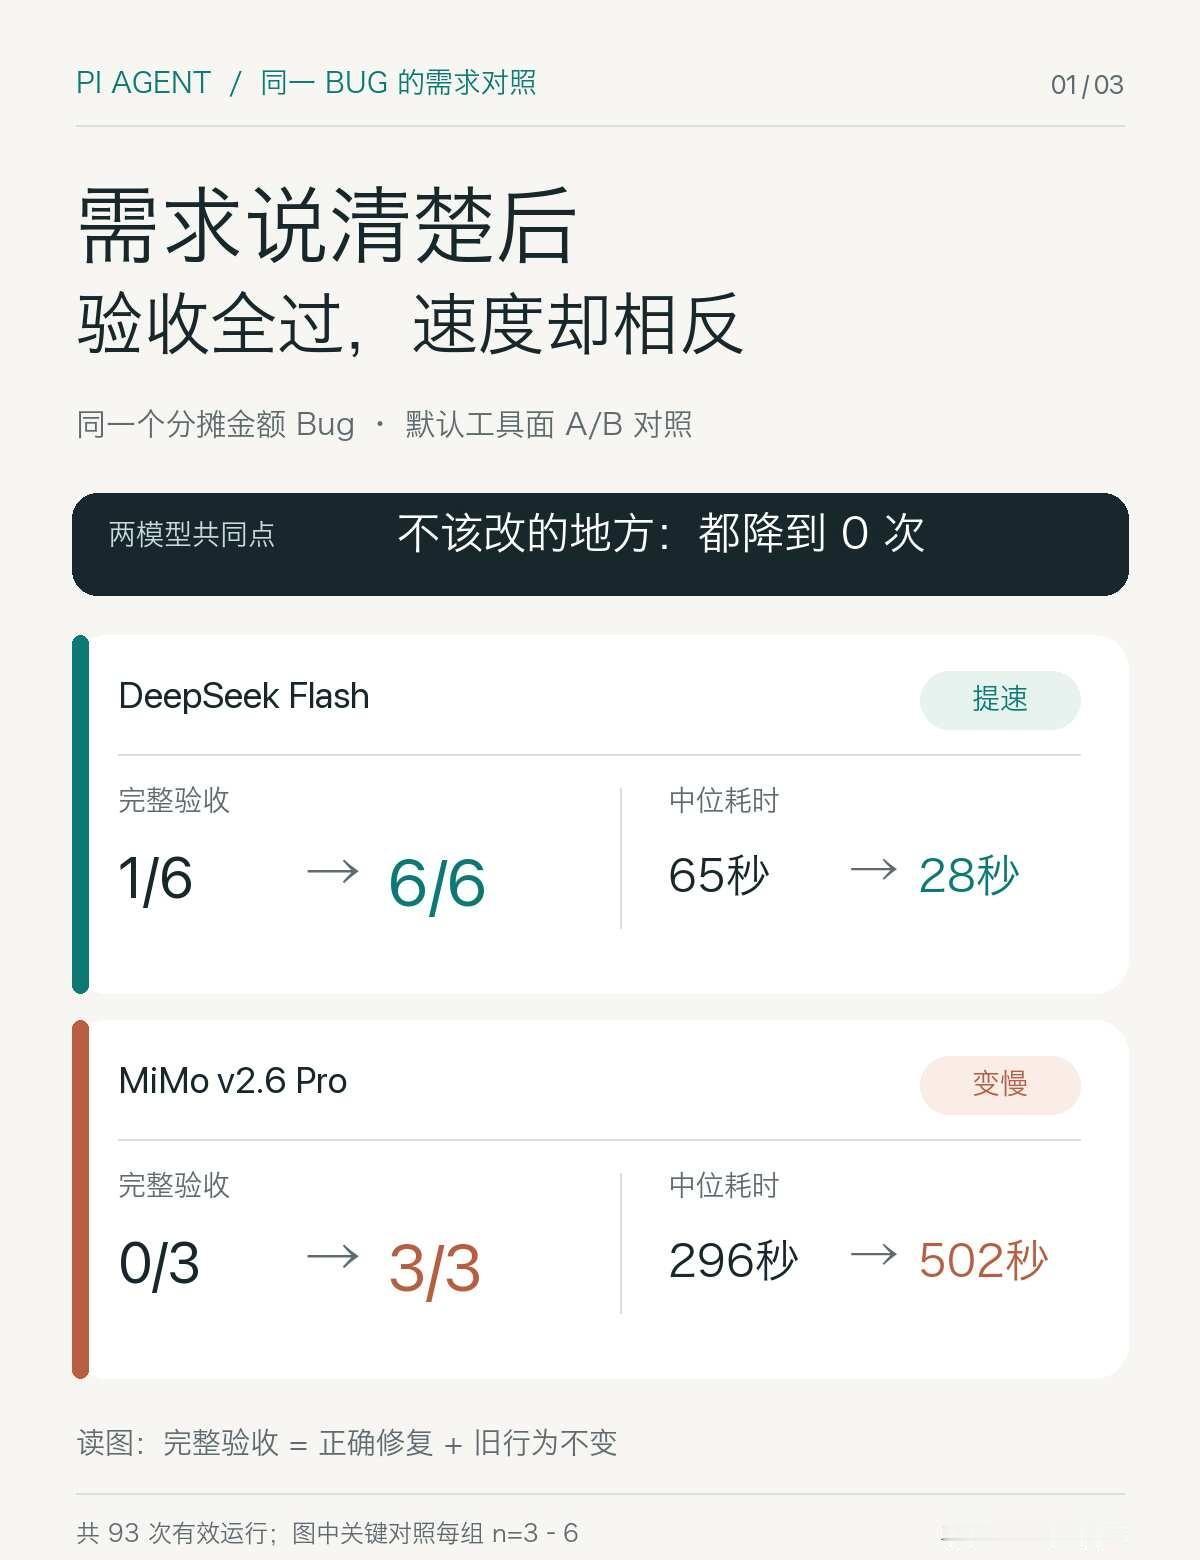
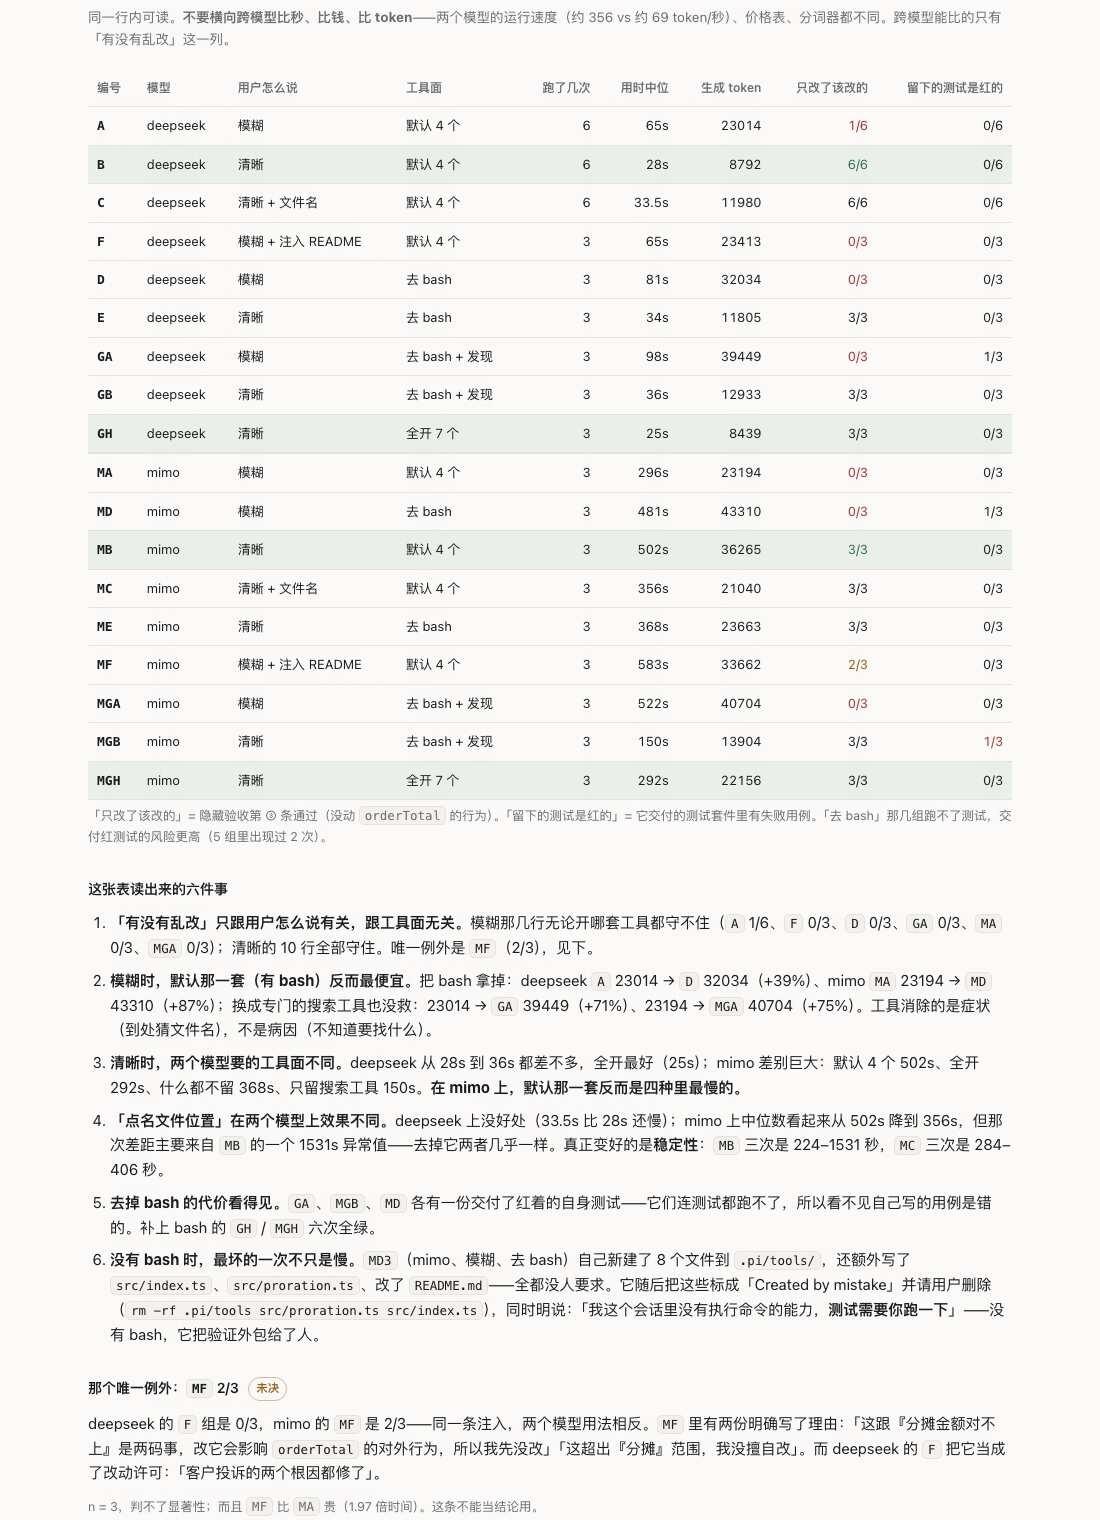
先说结果:同一个分摊金额 Bug,需求从「金额对不上」改为写清验收条件和旧行为边界后,DeepSeek 完整验收 1/6→6/6,MiMo 0/3→3/3;越界改动(乱写代码)分别从 5/6→0/6、3/3→0/3。
但清晰不等于更快:DeepSeek 中位耗时 65→28 秒、生成 token 约 2.3万→0.88万;MiMo 却是 296→502 秒、2.32万→3.63万。
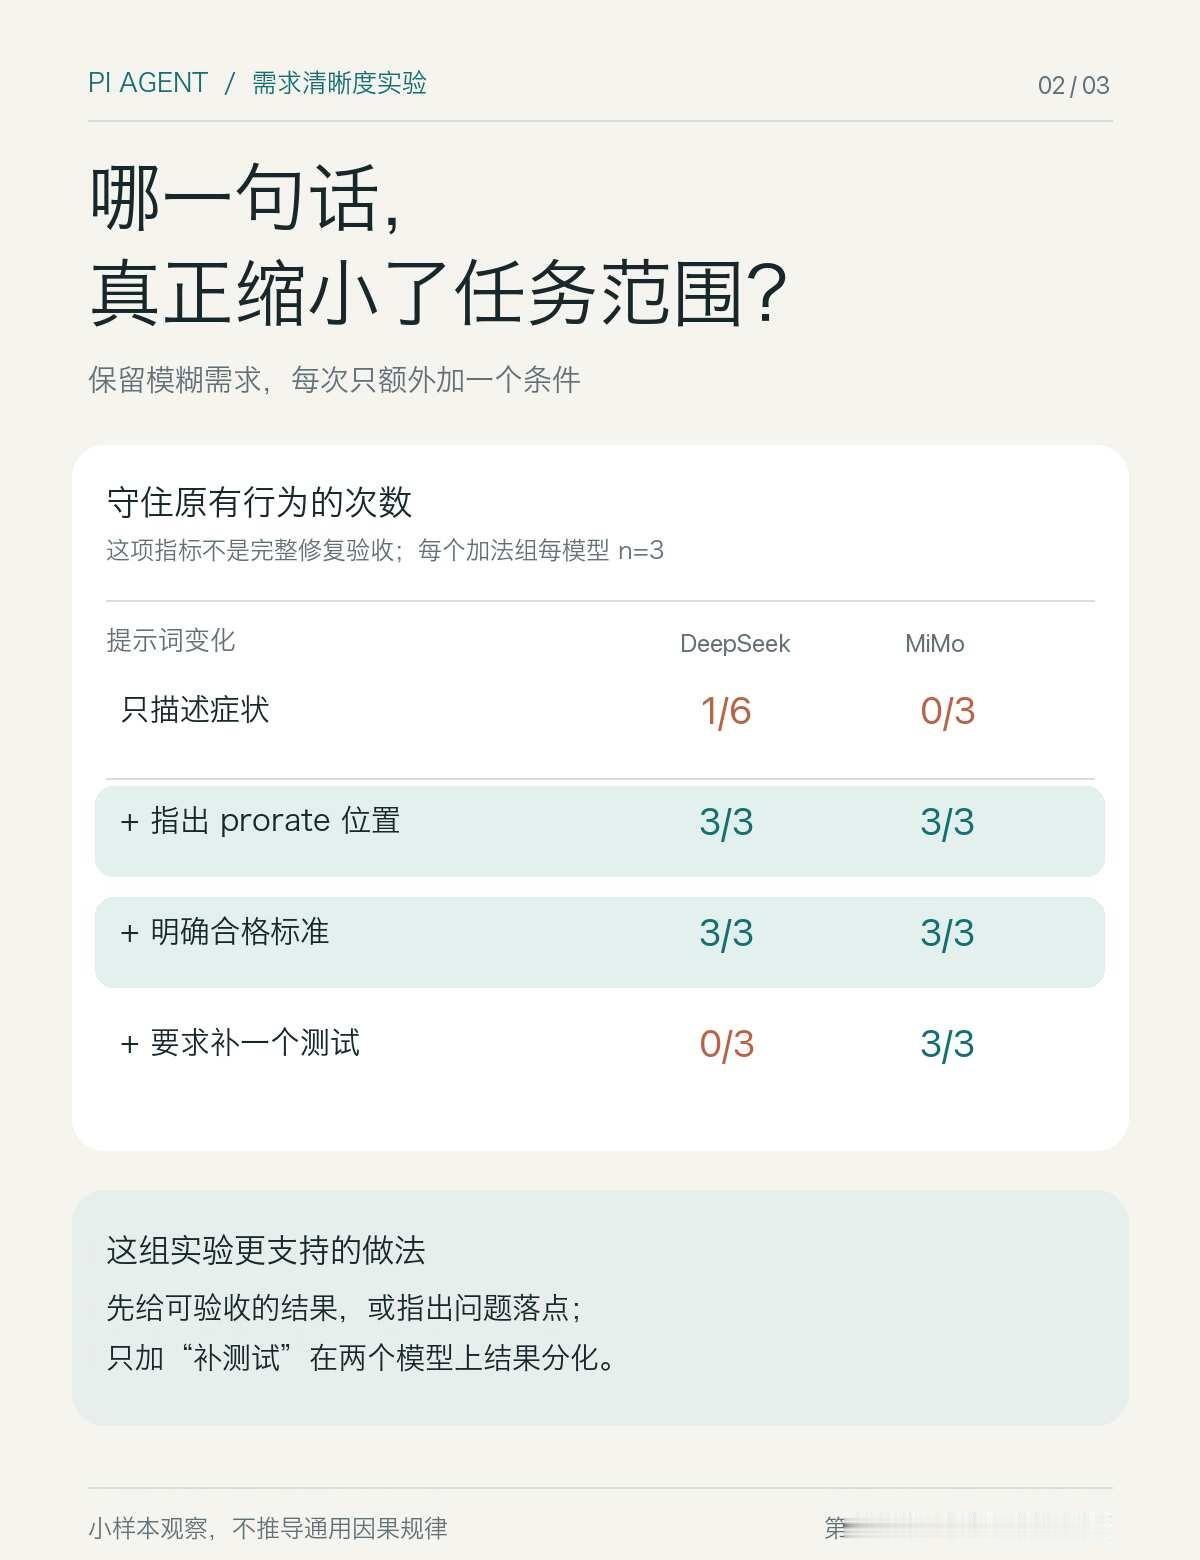
怎么测的?同一个 6 文件仓库、两个模型,跑了 102 次;剔除 9 次工具链混淆,留下 93 次有效运行。把清晰需求拆成单句后,只补验收标准或问题函数,每个单句组两模型各跑 3 次,都守住了旧行为。
样本边界:一个 Bug、两个模型,关键 A/B 对照每组 3–6 次;这组结果不能当成通用性能排名。
AI编程
Agent AI反常识howto