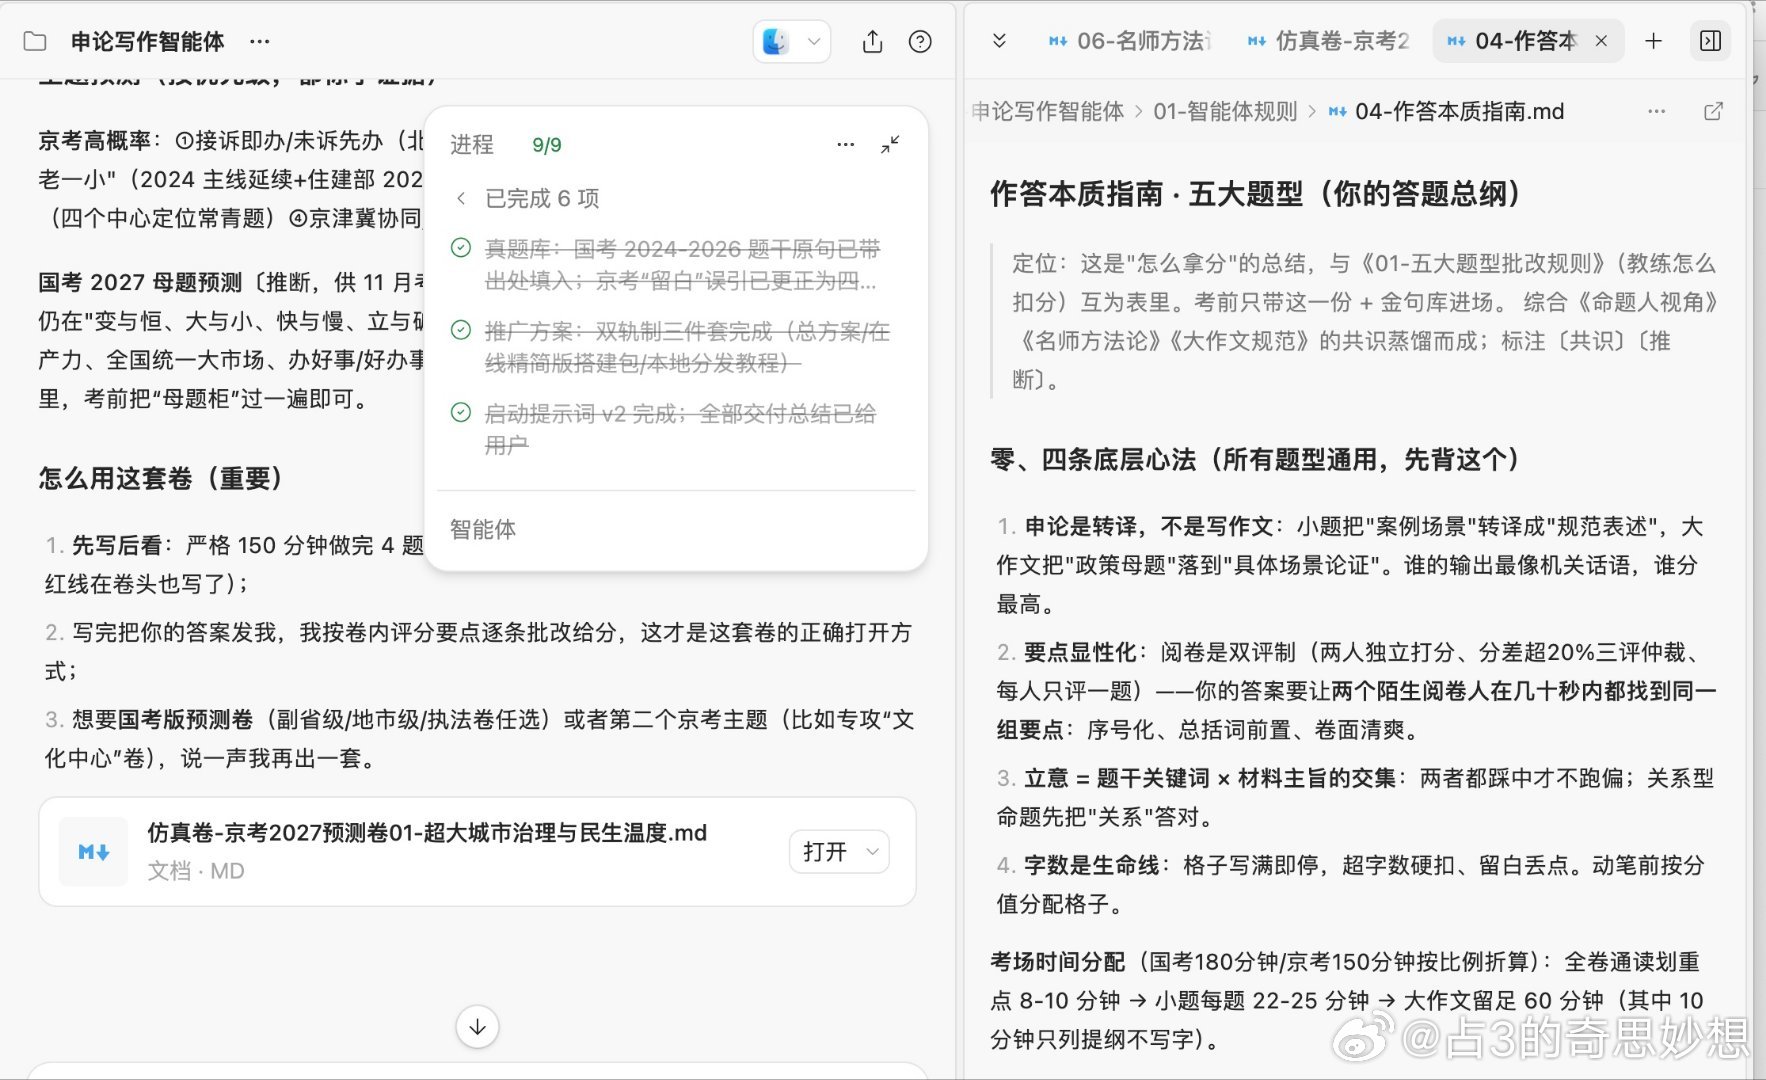
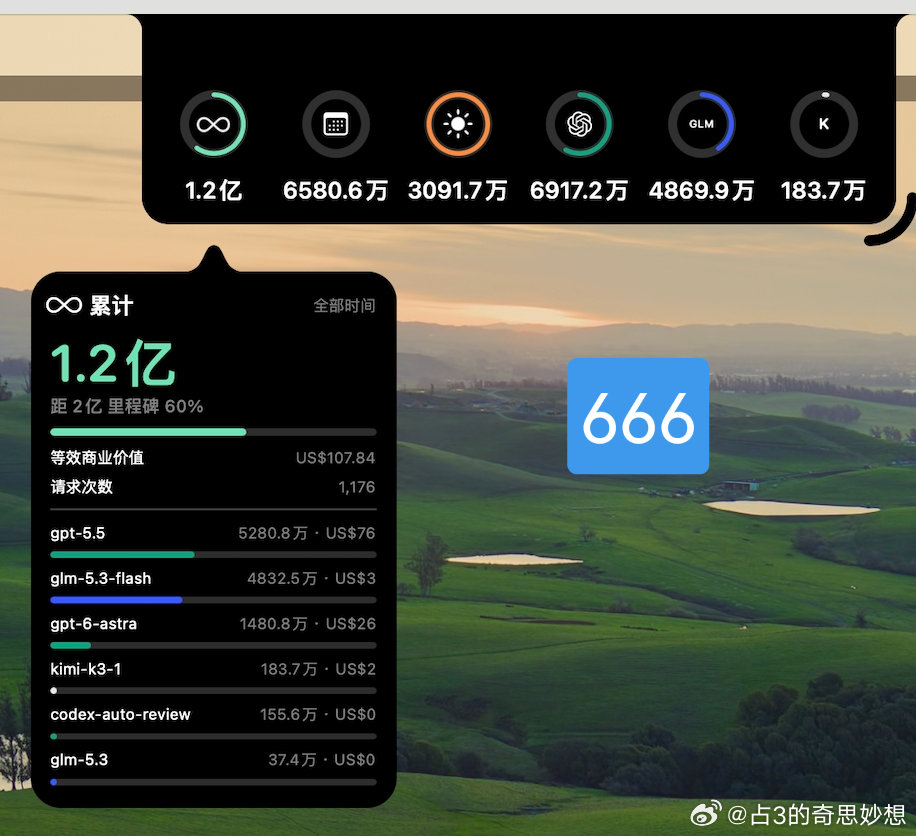
用1.2亿Token,搭建了个申论写作智能体。读博的时候,我的研究方向中就涉及到了微调大模型。23年做垂直领域的模型,要租服务器自己训,数据自己清洗,参数自己调,一训好几天,跑完一看,效果经常还不行,然后继续在调整,也是一段回忆。后来我在想,之所以能顺利毕业,也是正好赶上了大模型的研究,发论文还算是相对好发,运气好,发了几篇相关的文章,就毕业了。25年初,DeepSeek 突然爆了,紧接着各家模型井喷,到现在人人用豆包知识问答。最近,智能体的应用也很多了,特别是各大模型公司还有大厂,为了抢市场,疯狂发 token,补贴力度像极了当年的外卖大战。国庆假期呢,由于家人面临考试,也没有出去。她的申论平时训练的少,申论答题底层规则、命题人的潜在想法,应该是还没深挖到位。有天下午,我突发奇想,为什么不给她弄一个申论写作智能体,就专门来和她交互学习,让她了解申论的解答规律,修订平时她的答题结果之类的工作。也算是捡起自己的老本行了,紧接着,我就开始搭建智能体的工作。首先,要找很多素材,包括人民日报、求是、光明、半月谈、北京日报、政策文件等,每篇标好立意、结构、金句、规范词,做成能按主题秒查的范文库。还找了历年国考、省考等公开的申论题,形成原有的样本题库。接着,构建了一些学习、执行、反思、交互规则,让大模型做知识蒸馏。今天晚上,完成了申论写作智能体v1版本,测试了一下,还是OK的。后续续喂知识、蒸馏知识,再让它学会她的写作风格,慢慢看看效果怎么样。这个工作完事,看了看消耗了累计 1.2 亿 token,也是很有感慨。以后的智能时代,这个 token也是大问题,但最主要还是在人。人要有思考,要有想法,要有思想,去提出一些好的问题、好的思路,交给大模型,去和大模型不断地进行人机交互,什么时候达到人与机器的神形合一,才可能会提高输出内容的质量。当然了,这个过程,每个人是不一样的,按照自己的节奏走,就好。这个时代真的在百花齐放,将来,AI赋能机器人、无人机、无人车、无人飞机,想想这个画面还是令人所期待。所以,还得继续学习,继续实践啊,捡起来。欢迎大家一起交流,共同进步。京选 智能体大模型 效率神器 申论素材 国考 考公 北京