📰 Reflection 发布 501B MoE 开源模型 Beam:国产大模型面临哪些挑战?
你是否还记得第一次接触开源大模型时的震撼?从 LLaMA 到 Qwen,开源社区一直在推动 AI 技术的民主化。但最近,美国公司 Reflection 甩出一个"核弹级"武器——Beam,一个 501B 参数、23B 激活的稀疏 MoE 架构模型,让全球开发者都坐不住了。
今天我们就来深度剖析这场风暴背后的技术细节、对国产大模型的冲击,以及普通开发者该如何应对。
🚀 Beam 的硬核参数
总参数量:501 Billion (5010 亿)
每 token 激活:23 Billion (230 亿)
架构类型:Sparse Mixture-of-Experts (稀疏 MoE)
预训练 Token: 23.8 Trillion (23.8 万亿)
RL 训练轮次:>1 亿次 rollout
硬件投入:10.5K NVIDIA GB300 GPUs
许可协议:Apache 2.0
关键亮点:推理效率降低 3-4 倍,SWE-Bench Verified 80.9 分,对标 GLM-5.2/Qwen 3.8-Max
🧠 MoE 架构为什么这么"聪明"?
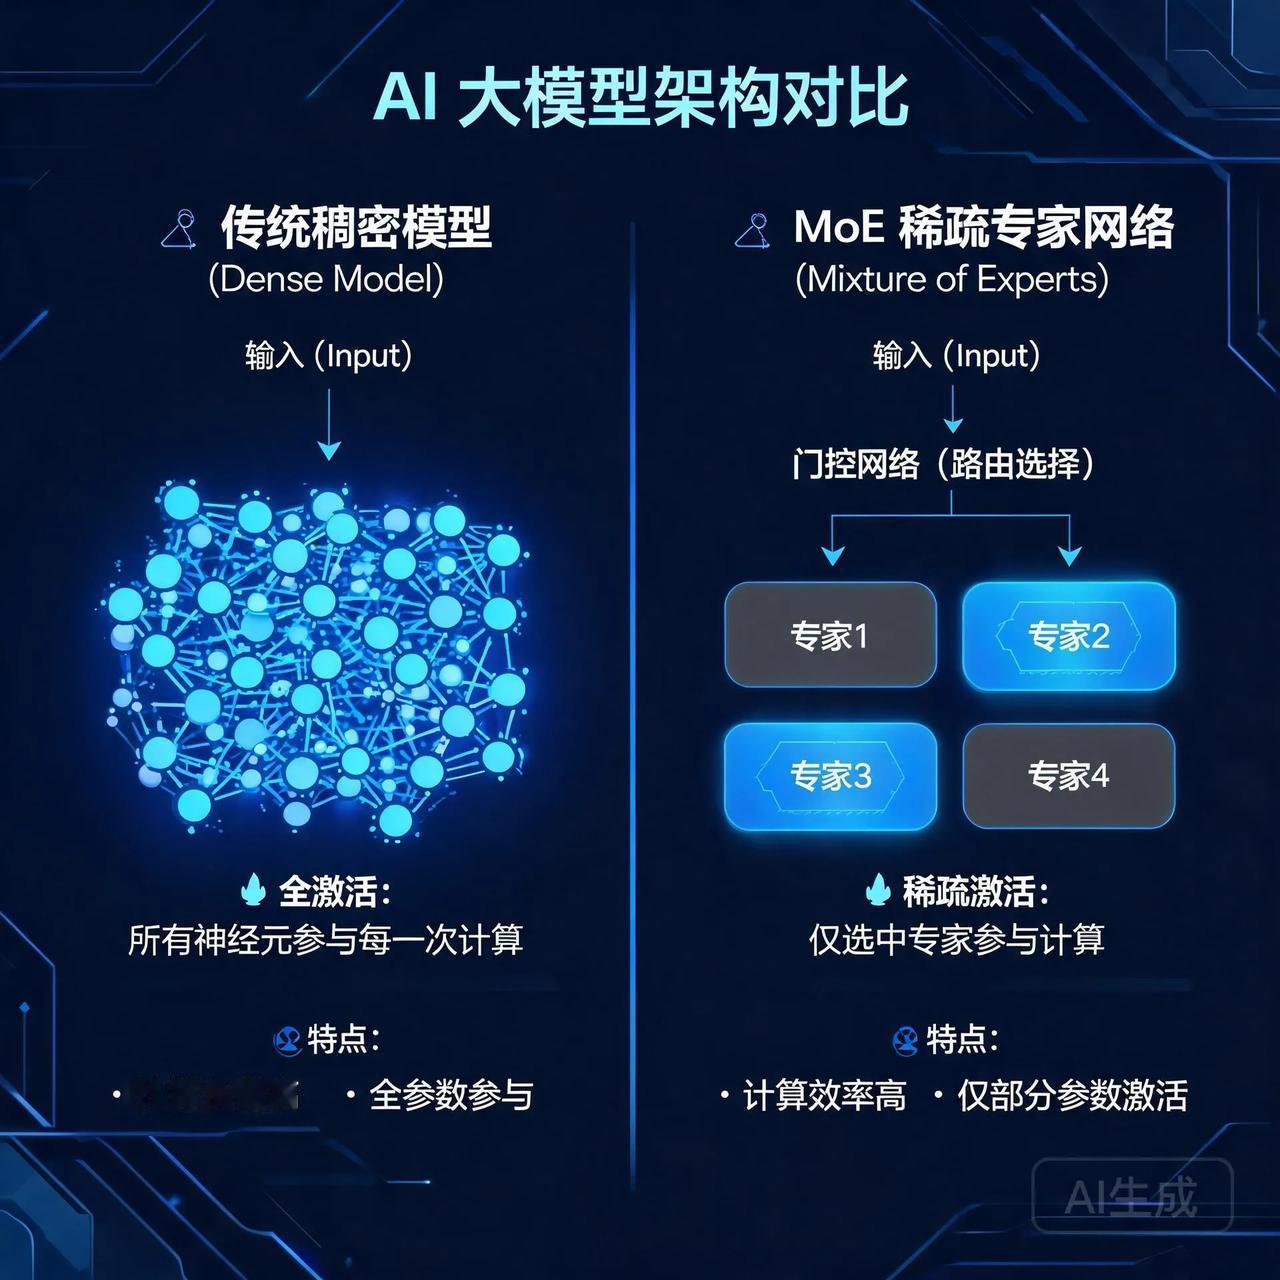
MoE(Mixture of Experts)是让模型"按需分配注意力"的技术:
• 传统稠密模型:每个 token 经过全部参数 → 计算量大、推理慢
• MoE 模型:每个 token 只走部分专家网络 → 动态路由、按需激活
Beam 的设计精髓:
1. 参数利用率超高:501B 总参数中只有约 4.6% 被激活
2. 路由效率高:智能路由算法确保不同 token 找到最适合的专家
3. 扩展性强:轻松扩展到更大规模而不显著增加推理成本
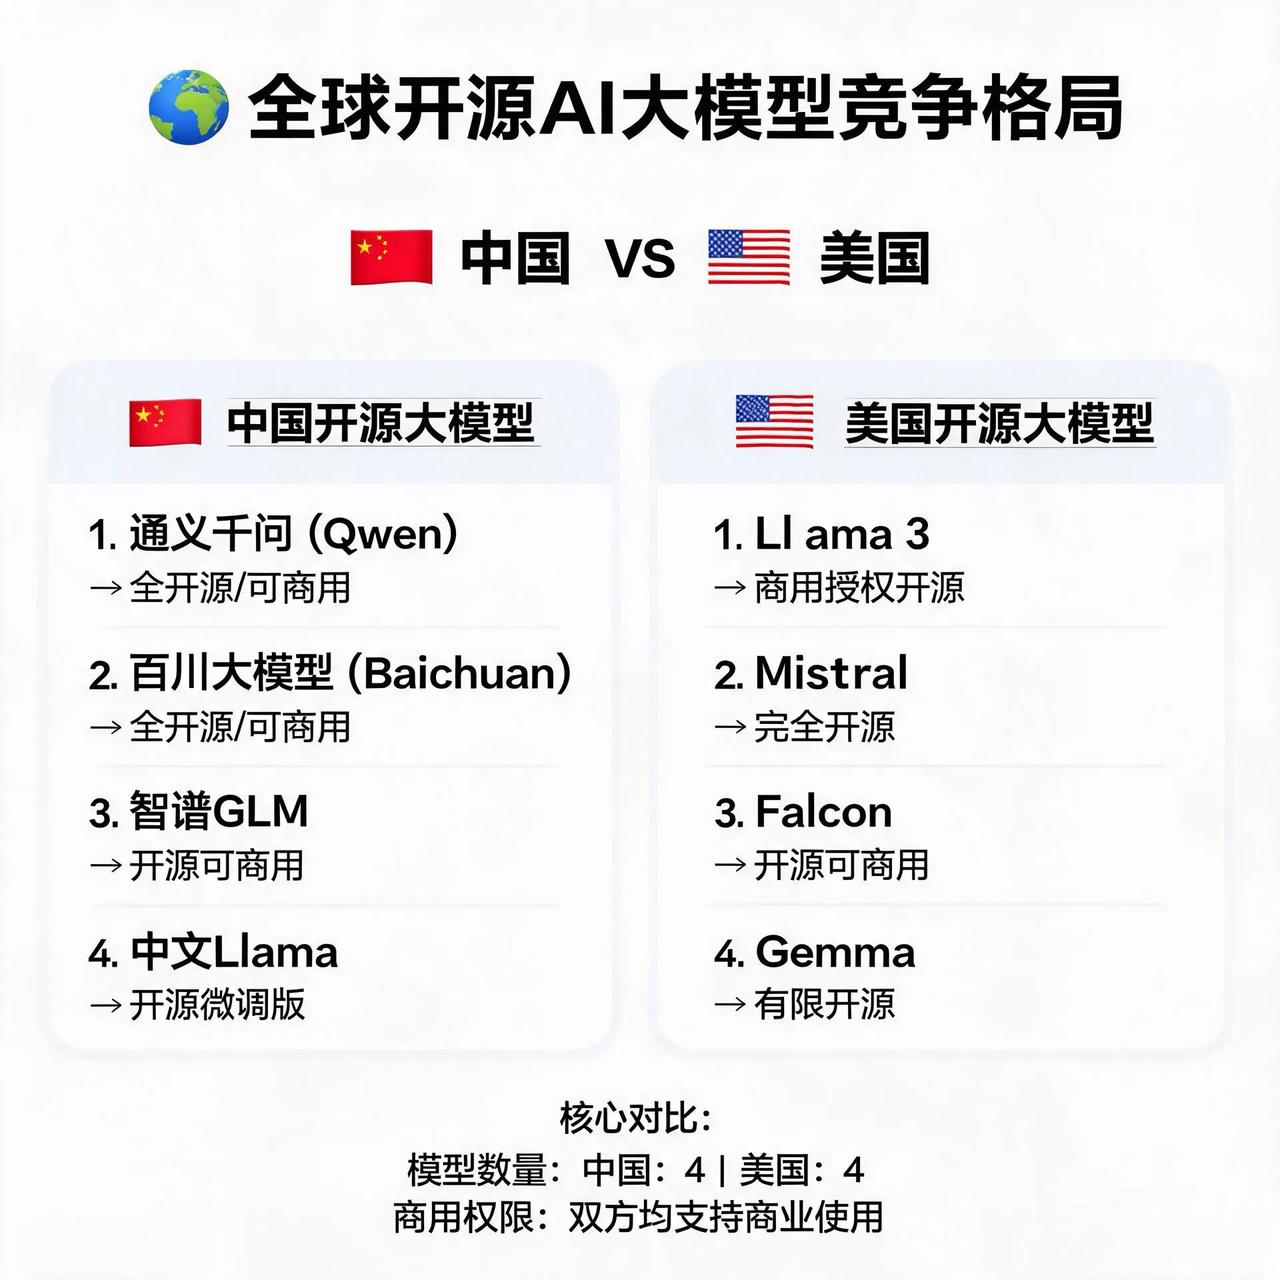
🇨🇳 国产大模型对比差距在哪?
核心差距分析:
1. 预训练数据质量与规模:Beam 使用 23.8T curated tokens;国内优势在中文数据,但英文/多语言不足
2. 推理效率优化:Beam 推理成本降 3-4 倍;国内多追求极致性能
3. 生态开放度:Beam 承诺 Apache 2.0 开源;国内大厂多以 API 为主
4. 技术前瞻性:Beam 的 RL 训练(1 亿次 rollout)展示"重强化学习"路线;国内更多依赖 SFT
💡 对开发者的实际影响
✅ 机会点
1. 本地部署成本降低:23B 激活参数可在消费级显卡运行
2. 代码辅助升级:SWE-Bench 80.9 分,代码生成/调试能力提升
3. 模型蒸馏新机会:用 Beam 作为教师网络,蒸馏出适合你业务的小模型
⚠️ 挑战点
1. 开源权重延迟释放:目前仅面向选组用户,10 月底才开源
2. 中文场景适配:Beam 主要优化英文/多语言;中文任务可能不如国产
3. 硬件门槛仍存:需 A100/A800 或双 4090 才能完整部署
🔮 未来展望
短期(1-3 个月):社区适配潮、中文适配版涌现、应用层爆发
中期(3-6 个月):国产模型反击、技术路线分化、成本持续下降
长期(6-12 个月):开源闭源博弈、行业洗牌加速、标准化落地
❓ 常见问题解答
Q: Beam 什么时候正式开源?
A: 10 月底前发布权重,Apache 2.0 协议
Q: 个人能免费使用吗?
A: 正式版开源后可本地部署;过渡期可通过平台付费试用
Q: 需要多少显存才能跑?
A: 建议使用 48GB 以上显存(如 A100/A800 或双 4090)
Q: 对国产模型影响大吗?
A: 短期有压力,但长期看会倒逼国产模型提升竞争力
📝 结语
Beam 的发布标志着开源大模型竞争进入新阶段。对中国开发者而言:机遇大于挑战,但要跟上节奏、找准差异化优势。
💬 如果 Beam 真的开源,你会选择用它做什么?评论区告诉我你的想法!我们一起探讨 AI 未来的可能性~
参考资料:Reflection 官方博客、Gate.com、alphaXiv