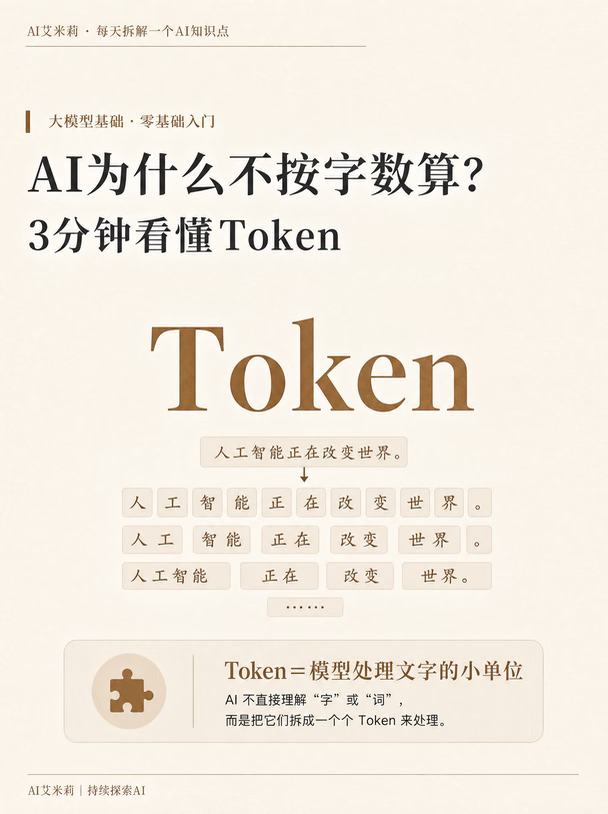
你有没有遇到过:明明只写了几句话,AI却提示“上下文超限”?问题可能出在Token。
Token就是大模型处理文字时使用的“小积木”。它可能是一个字、一个词、词的一部分,也可能是标点、空格或换行。
比如:
Unhappy可能拆成Un + happy
“巧克力”可能被拆成“巧”+“克力”
不同模型的拆分规则可能不一样
每个Token会先变成数字ID,再变成模型可以计算的向量。模型根据这些数字理解上下文,并逐步预测下一个Token,最后还原成文字。
为什么要关心Token?
✅ 上下文长度通常按Token计算
✅ 很多API按Token数量计费
✅ 长文本、代码、网址和emoji可能消耗更多Token
记住这条链路:
文字 → Token → 数字 → 模型计算 → 文字
Token不是AI真正“理解的词”,而是它处理语言时使用的基本积木。
收藏这篇,下次看到Token用量就不会懵啦~
#AI新手村 #howto用好AI #内容创作 #大模型 #Token #人工智能 #GPT #AI工具 #AI科普 #AI搞学习howto