2027年的显存,已经卖光了?
刷到这条,可能很多人还没反应过来,未来三年的AI算力,早就被提前订完了。
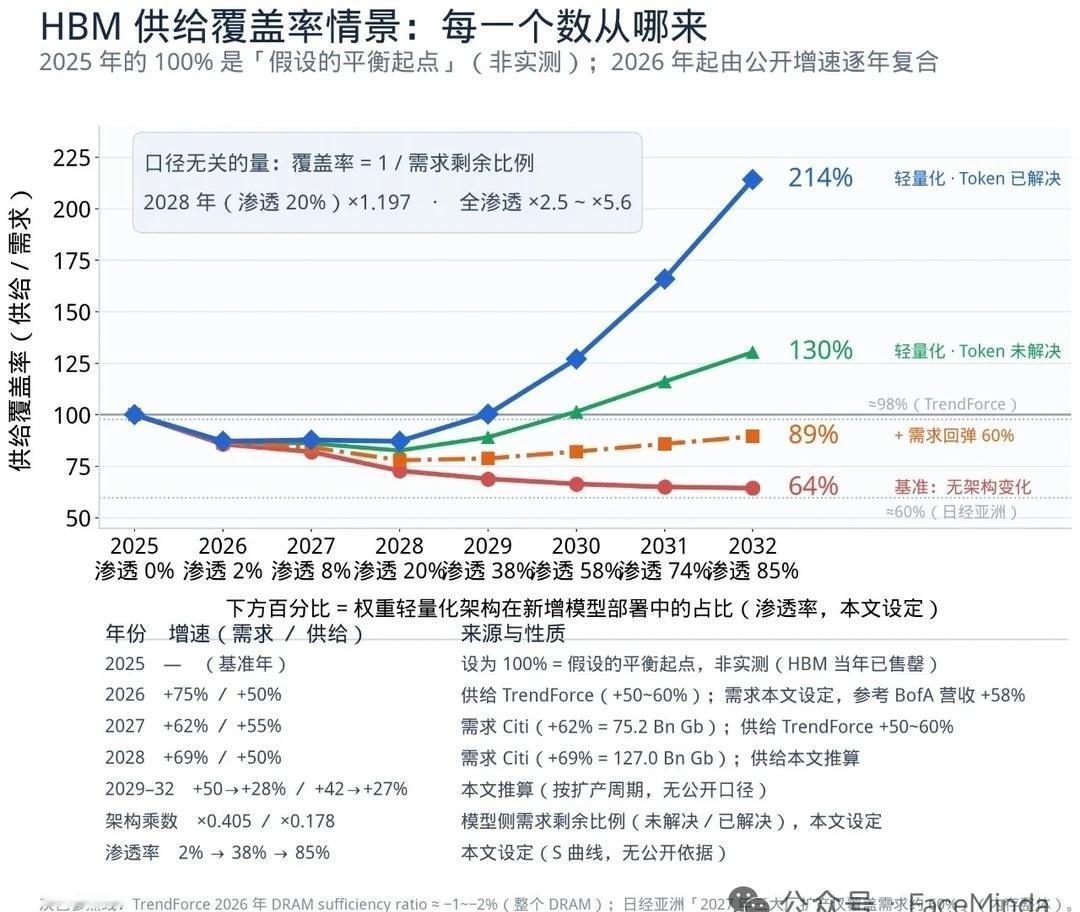
这里说的不是芯片,是显存。三星、海力士、美光手里的HBM产能,2027年的份额已经全部卖完,缺口能达到五六成,明年的平均价格估计还要再涨121%,英伟达的服务器也跟着涨了15%。
放到现实里就是,从今年开始,一味靠做大参数提升能力的路子,慢慢行不通了。模型做的再大,显卡装不下,一切都是白费功夫。
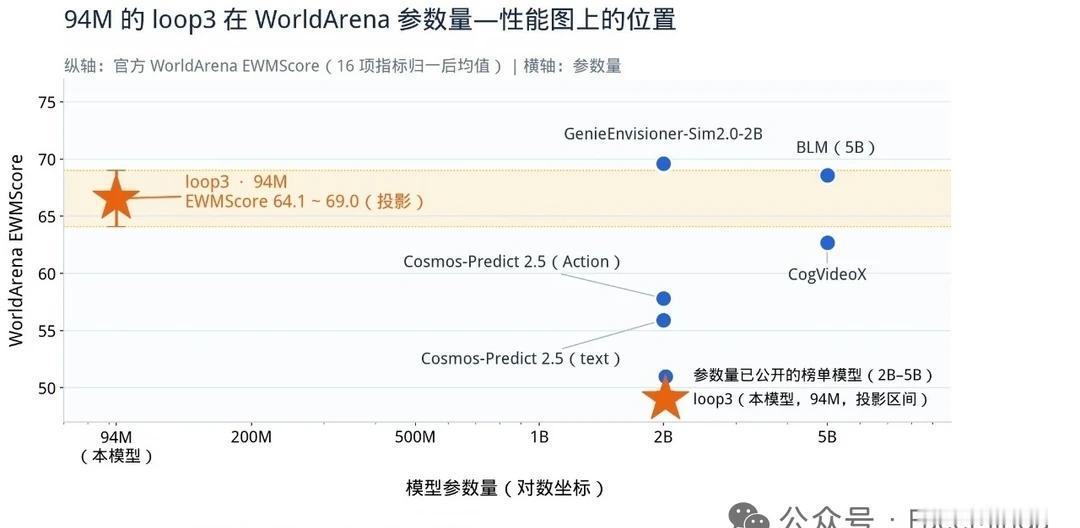
最近看到一组很能说明现状的实验。国内有个叫脸谱心智的团队,一直在做世界模型,平时很少对外宣传。他们搞出来一个只有94M参数的视频生成模型,拿来和5B参数的BWM做对比,两者参数差了足足53倍。
他们的思路和主流不太一样,不去增加参数,反倒把计算量拉高四倍,让现有的网络层反复运行,相当于间接把网络做深,但是权重部分一点都不会多占空间。
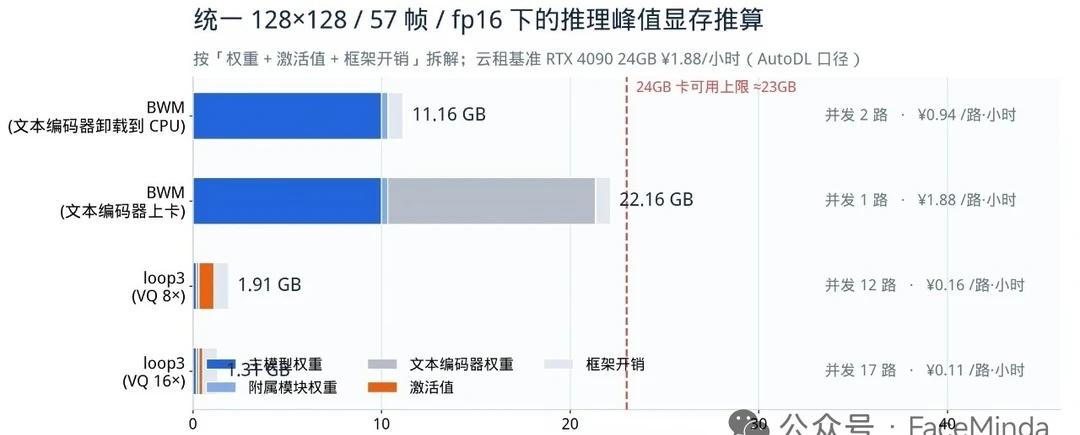
最后的评测一共十六项,有七项结果超过了这个参数大五十多倍的对照模型。实现反超的,都是轨迹精准度、深度判断、指令理解这些真正决定实际好不好用的维度。显存占用直接从10GB降到0.19GB,同一台8卡H100机器,可同时处理的任务数量,从57路提升到336路。
有个细节挺值得琢磨,OpenAI上个月推出的GPT‑6 Astra,用到的循环深度技术,和这套思路本质同源。全球顶尖实验室,和国内并不算出名的团队,在差不多时间摸到同一个技术方向,放在技术发展的历史里看,这往往就是大势所趋。
也要客观说,这个模型画面表现还有内容连贯性上还有差距,测试用的也是128×128这种保守规格,谈不上完美无敌。聊起它不是说它已经做到最好,而是它实实在在印证了一件事。
显存资源被抢空的当下,懂得权衡资源开销的模型,远比单纯堆砌参数的更有价值。
往后一年可以多留意一个新的衡量角度,看每GB显存能够换来多少实际效果。谁能把这笔账算明白,谁就能掌握市场里的主动权。
世界模型 具身智能 半导体 CPU