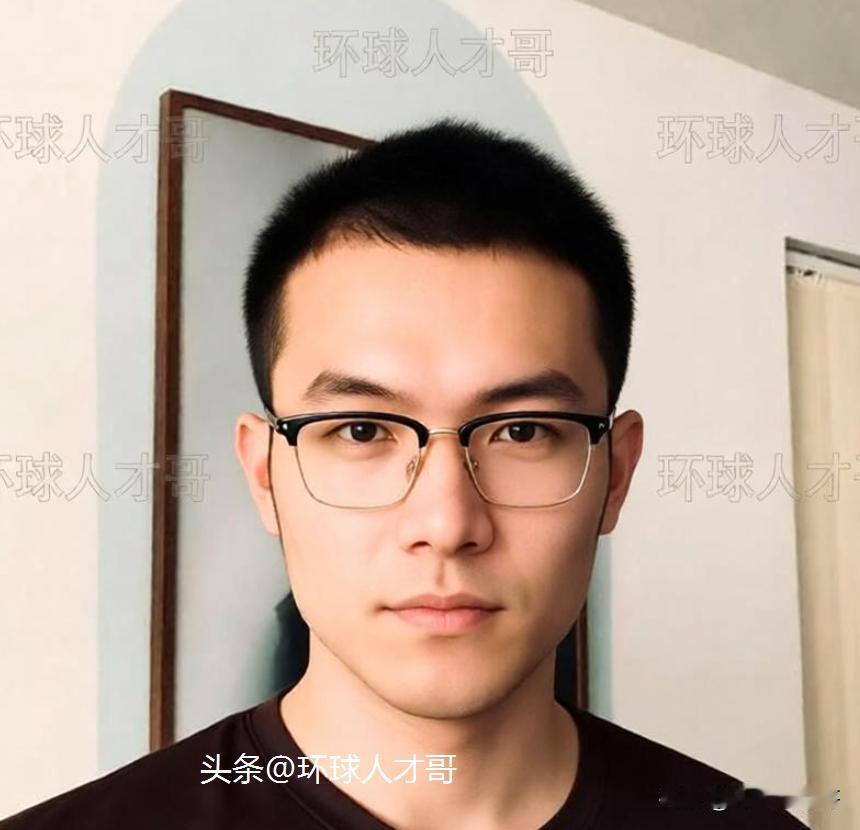
杨耀东,毕业于中科大的超级学霸,帝国理工学院硕士,伦敦大学博士,北大—灵初联合实验室首席科学家。
2025 年 7 月,国际计算语言学大会(ACL)颁出年度最佳论文。
四篇里有一篇来自中国团队,题目翻译过来就是《语言模型抵抗对齐:来自数据压缩的证据》。
结论一句话,大模型不像一张白纸,它更像一根弹簧。
你用力把它拉到"合规"的位置(这叫对齐),它在那儿待着,外力一撤,它会按近似"胡克定律"的弹力,回到预训练时形成的原始位置。
那届 ACL 收到 8000 余篇投稿、只评出四篇最佳论文,这是唯一一篇由中国科研机构独立完成的。
论文的独立通讯作者是北京大学人工智能研究院的杨耀东。
2009 年他考入中国科学技术大学,2013 年本科毕业,去伦敦帝国理工学院读硕士。
他硕士读的是生物统计与生物信息,课上那些描述种群动力学的微分方程让他觉得"竟然有规律可以用来描述动物种群的迁徙",而这恰好和多智能体系统接得上。
于是他去了伦敦大学学院(UCL),师从汪军读博,做强化学习。
他最漂亮的一招是把平均场博弈搬进强化学习,海量智能体里没人能主导全局,他干脆把百万级个体简化成"群体行为模型"。
像股票市场,把所有人看成一个整体,就能算出群体的统计行为。
这篇 ICML 2018 的论文拿到了 Oral。
2019—2021 年在华为伦敦研究院当主任研究员,之后在伦敦国王学院做助理教授。
2022 年 1 月,他选择回国,入职北大人工智能研究院。
按常理他该继续做纯算法,那时国内正热大模型。
但他判断"只将 RL 应用于游戏并非智能的最终形态,无法推动行业发展。"
于是他把方向掉到了硬件上,让强化学习去控制高自由度的机械手。
这正是著名的莫拉维克悖论,机器人下棋容易,叠衣服极难。
现在他手上有两条战线,一条是 AI 安全。
他的判断很克制,大模型很难被完全对齐,但可以"让它更安全"。
事前审核内容,事中平衡奖励与有害性,事后加"后置对齐器"修正输出,更进一步,应当转向事前可验证的价值安全体系。
另一条是具身智能。
他是北大—灵初联合实验室首席科学家。
实验室自研的外骨骼数据手套,单套每天采 5000 条手部操作数据、累计超百万条,成本只有传统真机遥操作的十分之一。
2026 年 9 月 7 日,他担任 CNCC2026 第六届网络生态治理论坛共同主席,议题是"当 AI 学会自主攻击"。
杨耀东现任职北大人工智能研究院助理教授、研究员(博雅学者)、博士生导师、院长助理。
同时获得国家级高层次青年人才等多项荣誉,入选 MIT 科技评论"AI 100 青年先锋"、福布斯中国 2025 科创革新力人物。
作为AI领域的青年学者,他持续在 AI 对齐、多智能体领域攻坚克难,在保障人工智能安全可控这条路上持续探索。
版权声明:未经本人书面许可,禁止任何平台转载、洗稿、搬运,违者不排除将被追究著作权法律责任。