现在卷AI,比的不是参数,是谁更省HBM!
最近刷到一篇很有意思的行业观察,一下子点透了现在AI圈一个很现实的困境
不知道大家有没有留意:
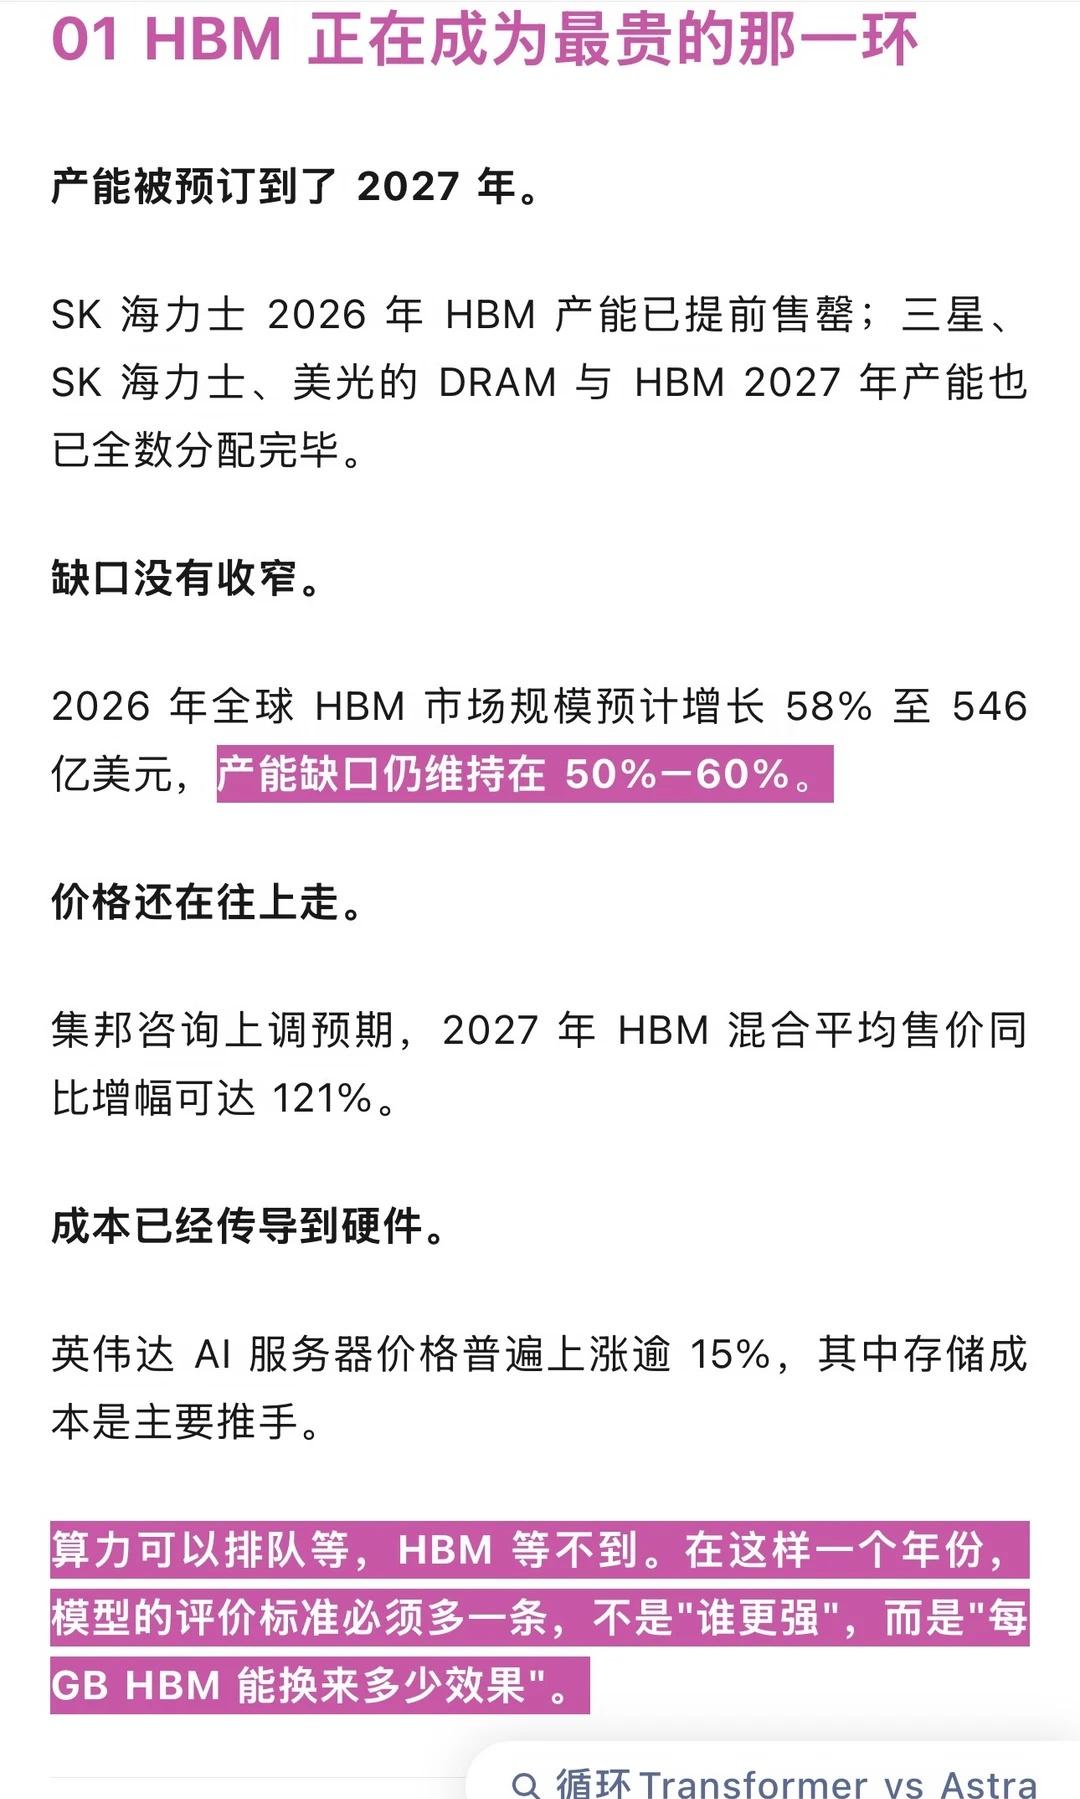
现在最卡AI脖子的,不一定是算力,而是HBM显存。
SK海力士、三星、美光的HBM产能,早就被各大厂提前订到2027年了。
2026年全球HBM市场预计涨58%,但产能缺口还有50%-60%,价格还在一路狂飙,甚至预测明年均价同比涨幅能到121%。
连英伟达的AI服务器,都因为存储成本上涨,普遍贵了15%以上。
行业里有句很扎心的总结:
算力可以排队等,HBM等不到。
每1GB的HBM,我们能换来多少实际效果?
有意思的是,头部实验室已经在往同一个方向试探了。
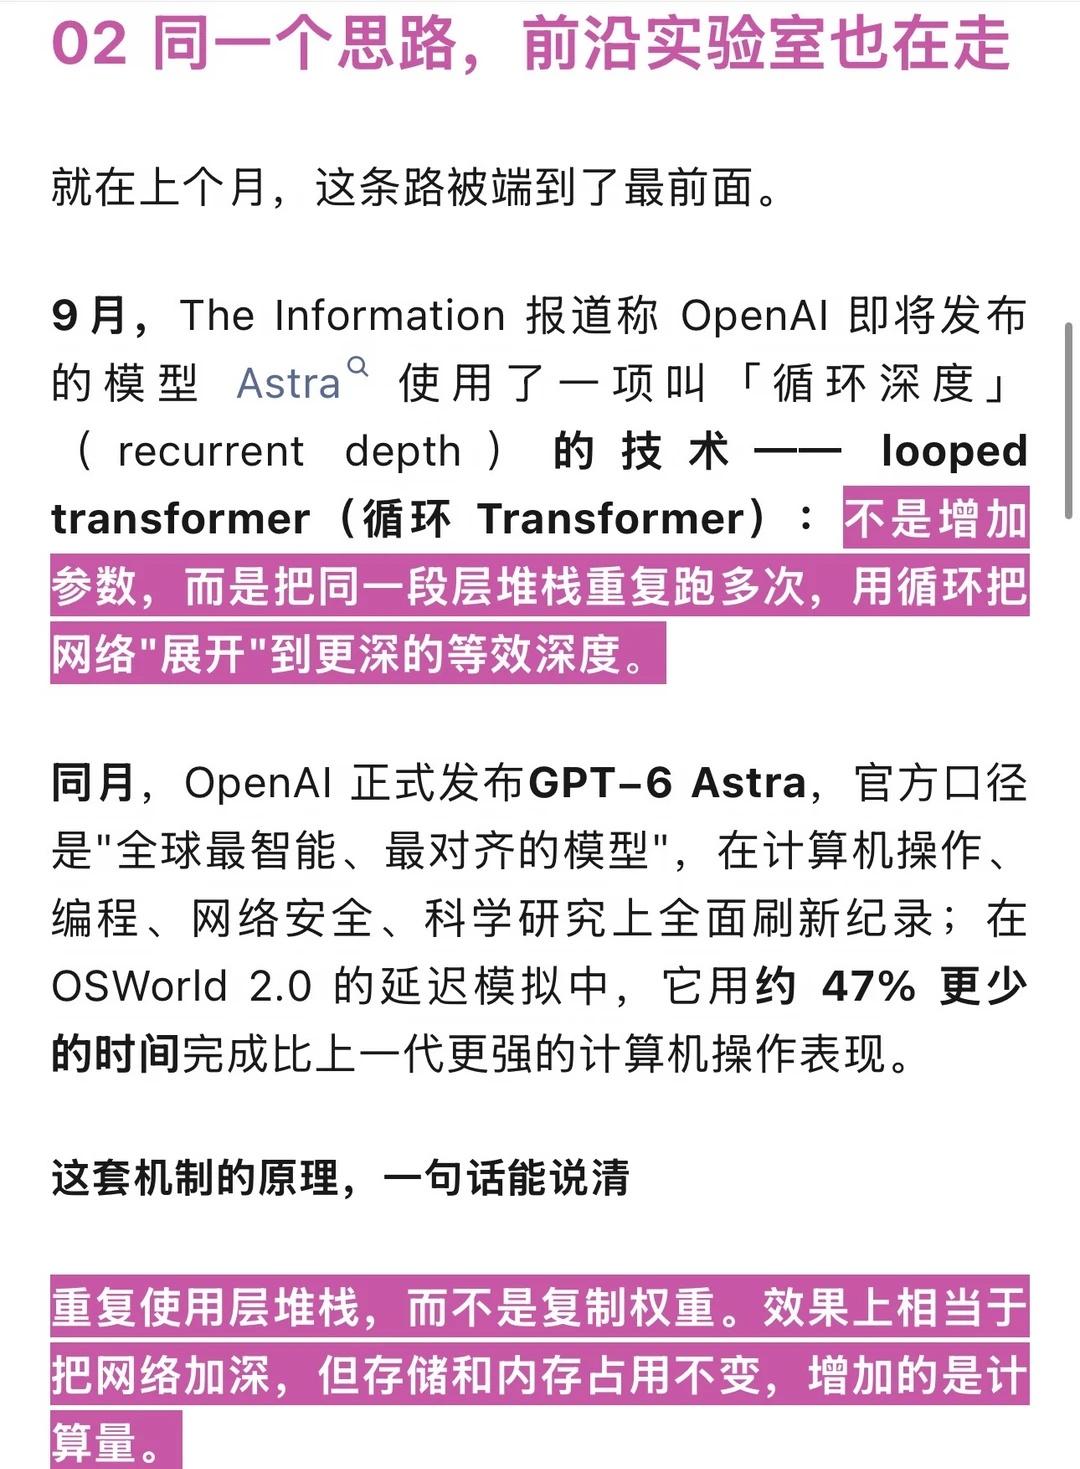
OpenAI刚出的GPT‑6 Astra,就用上了「循环Transformer(looped transformer)」:
不去疯狂增加新参数,而是把同一套层堆栈,重复跑很多次。
相当于用“反复计算”,把网络等效做深;权重不用复制,HBM占用几乎不变,只是多消耗一点计算量。
FaceMind脸谱心智最新的Loop模型,走的也是这个思路。
很多视频生成模型大家都有个体感:“论文里能跑起来”和“真的能低成本、大规模跑起来”,完全是两回事。
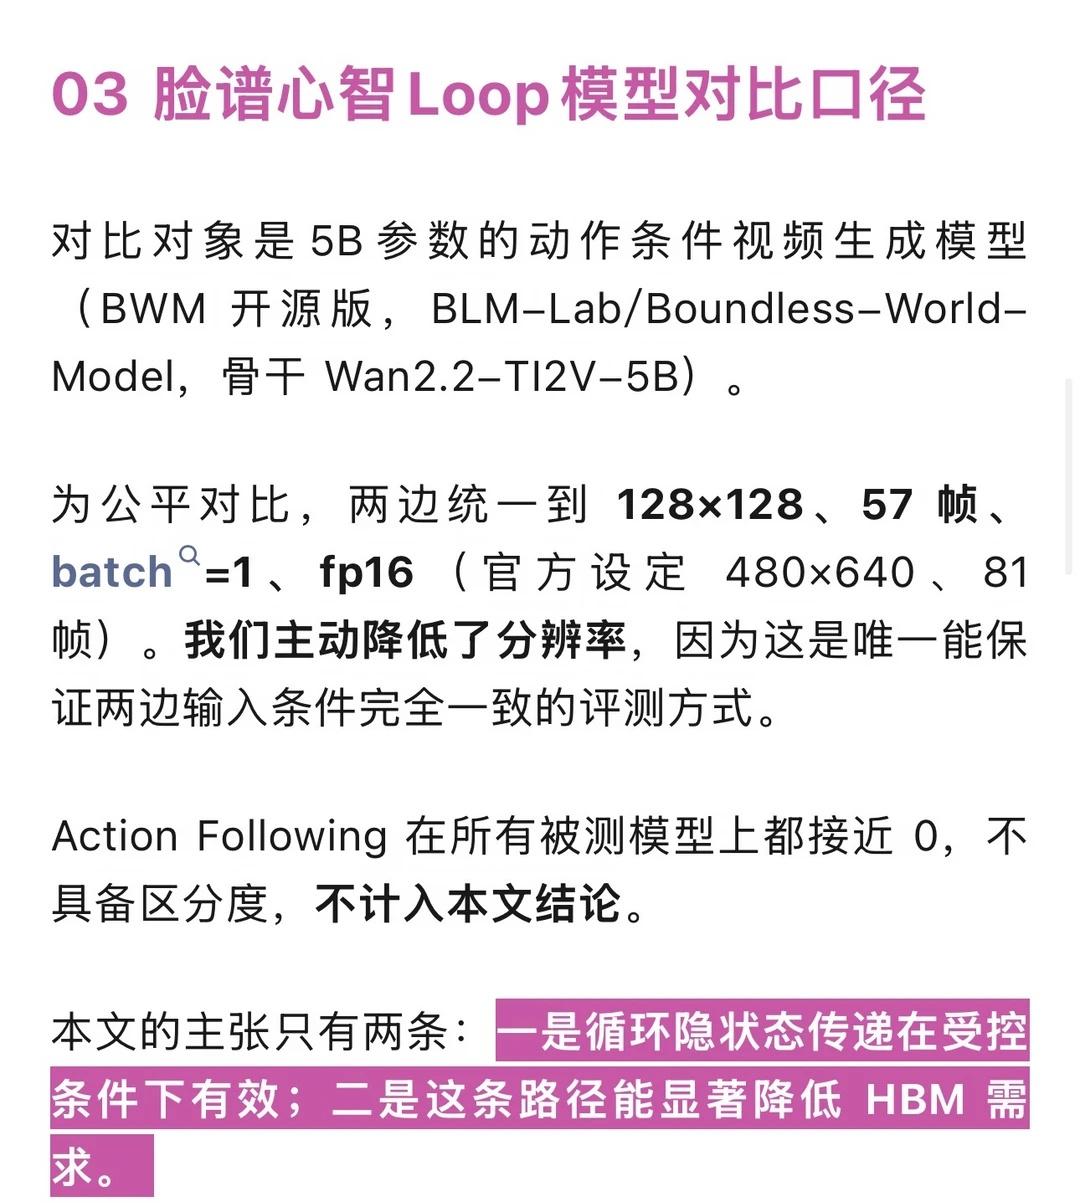
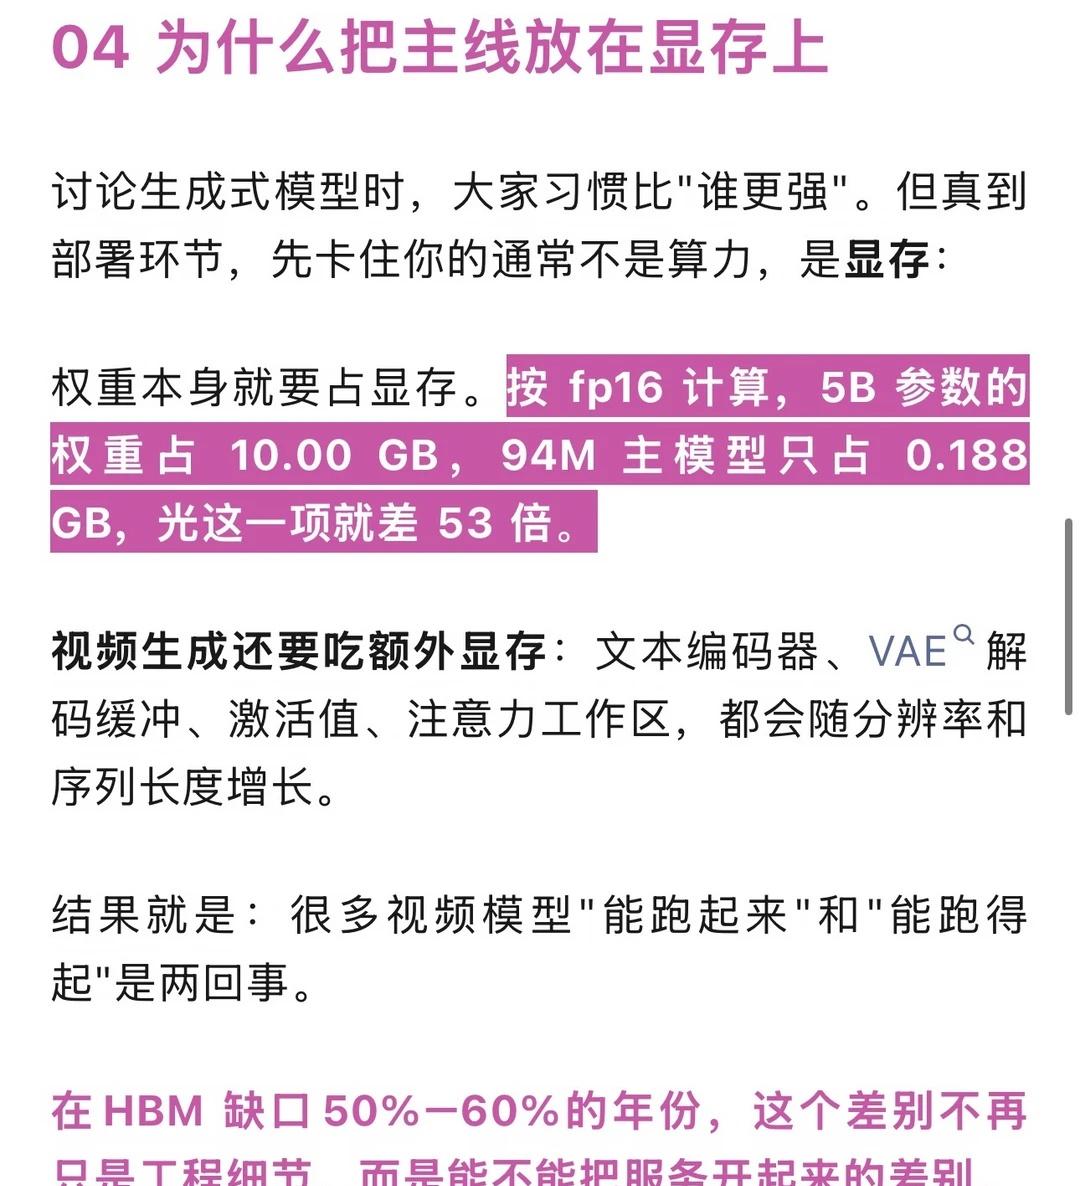
举个直观的数字:同样是fp16精度,一个5B参数视频模型,光权重就要占10GB显存;而这里这套约94M参数的Loop模型,权重只需要0.188GB,差了足足53倍。
他们做了一组对照实验:
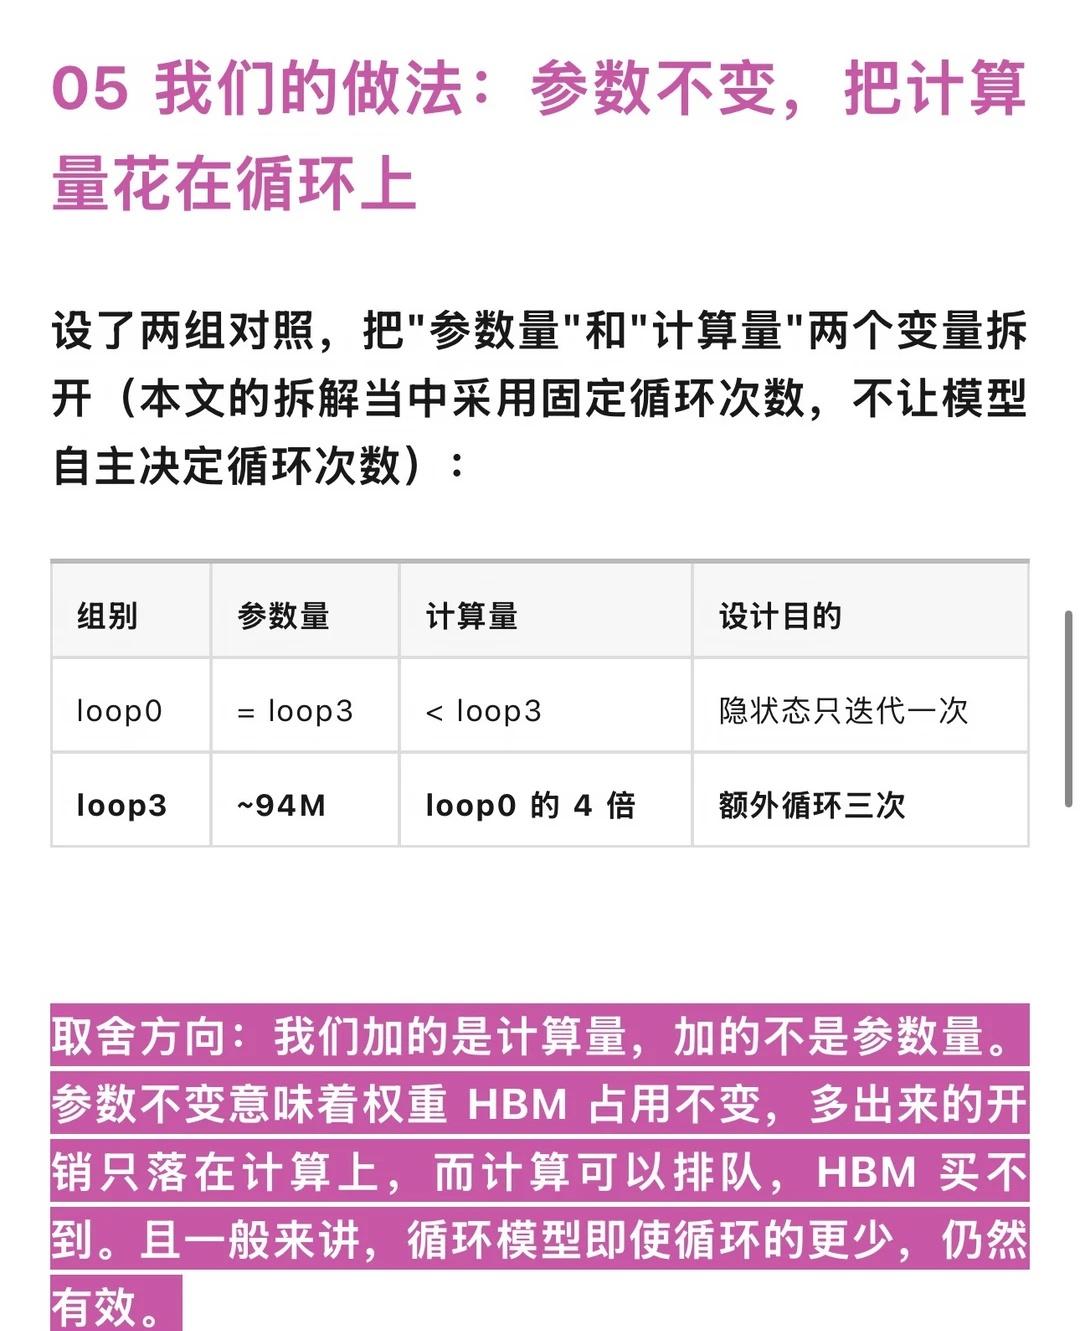
固定住参数量不变,不去堆更大的权重,只靠增加循环次数来放大能力。
Loop0和Loop3用完全一样的参数量(~94M),Loop3只是多循环了3次,计算量变成原来4倍;但HBM占用没有增加。
核心逻辑一句话:
加计算量,不加参数量
显存(HBM)是现在最稀缺、买不到的硬资源;
而计算资源,大不了慢一点、排排队,总能挤出来。
当然目前结论也很克制:在受控条件下,循环隐状态传递这条路是有效的,确实能显著降低对HBM的需求。不是说已经完美解决所有问题,但在HBM疯狂紧缺的当下,这是一条很值得跟进的路线。
感觉AI的竞赛,正在从“谁能把模型做更大”,慢慢转向“谁能用更稀缺的显存,做出更有用的东西”。
FaceMind HBM AI行业观察 循环Transformer 视频生成AI反常识howto 人工智能 具身智能 AI