上个月我把 19.5GB 的权重拖进显存,进度条直接爆红。
显存只有 8GB,差着一倍还多。
💥我一度以为是电脑不行。
后来才想明白:塞进去靠的不是硬撑,是分工。
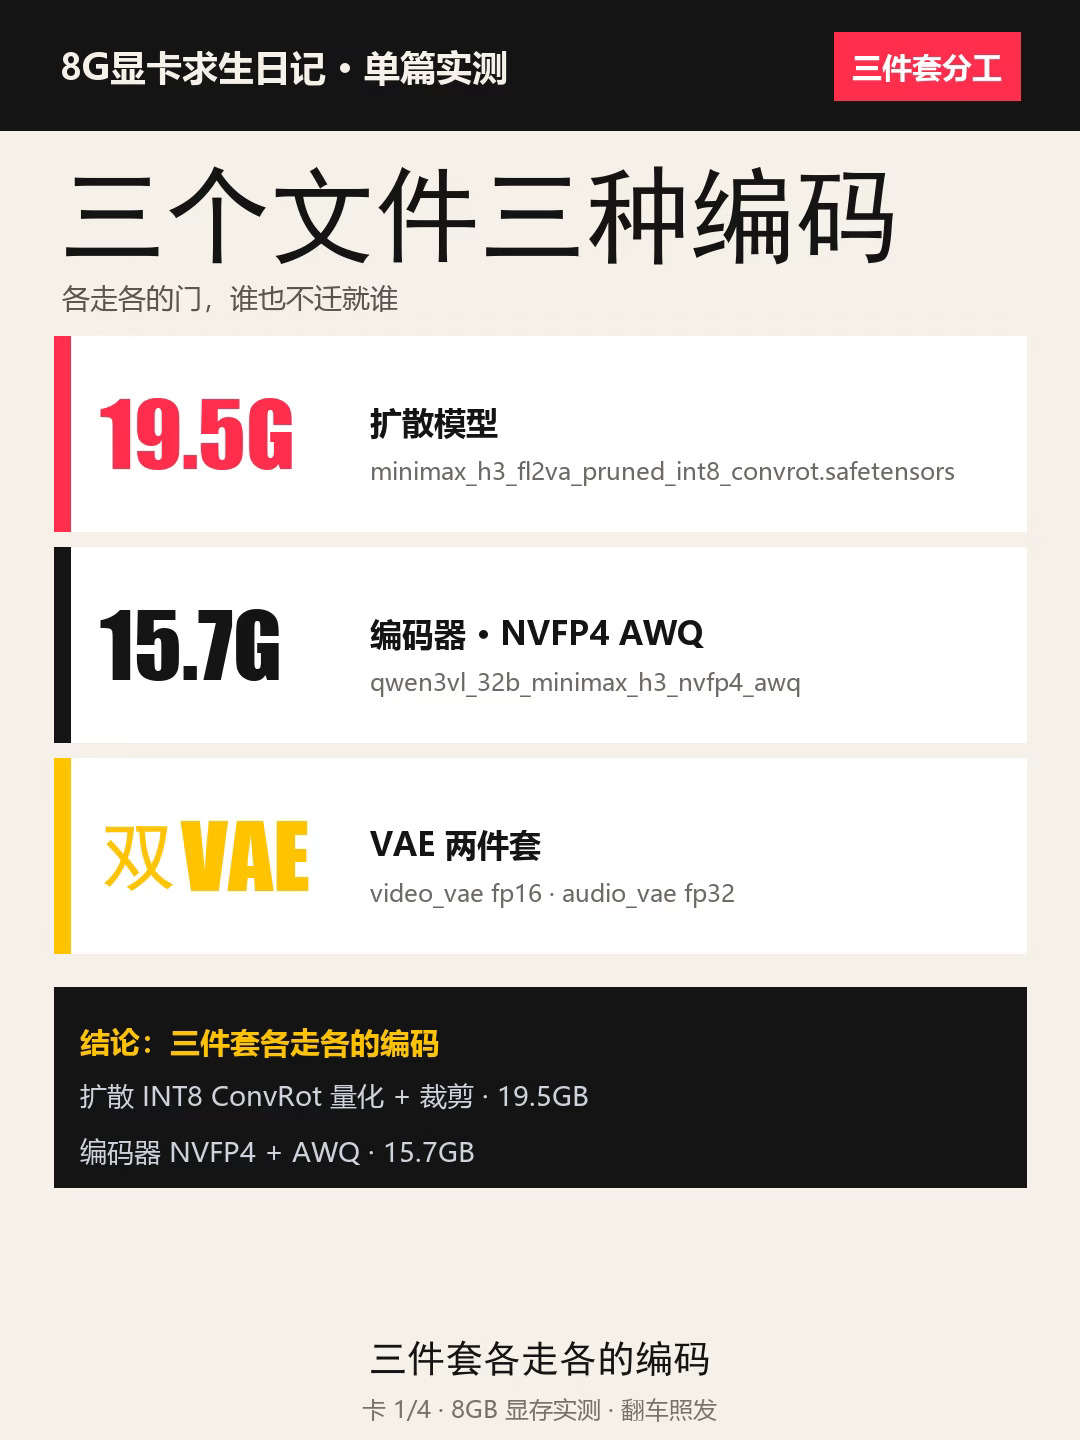
先给结论:量化不是把模型压扁,是给不同部件挑不同编码。三件套各走各的门。👇
📦三件套分工(细节在第 2 张卡)
扩散模型走 INT8 ConvRot 量化加裁剪。整支文件 19.5GB。
编码器是 32B 的 qwen3vl 系。15.7GB,NVFP4 加 AWQ。
VAE 是两件套,video_vae 用 fp16,audio_vae 用 fp32。
谁也不迁就谁。
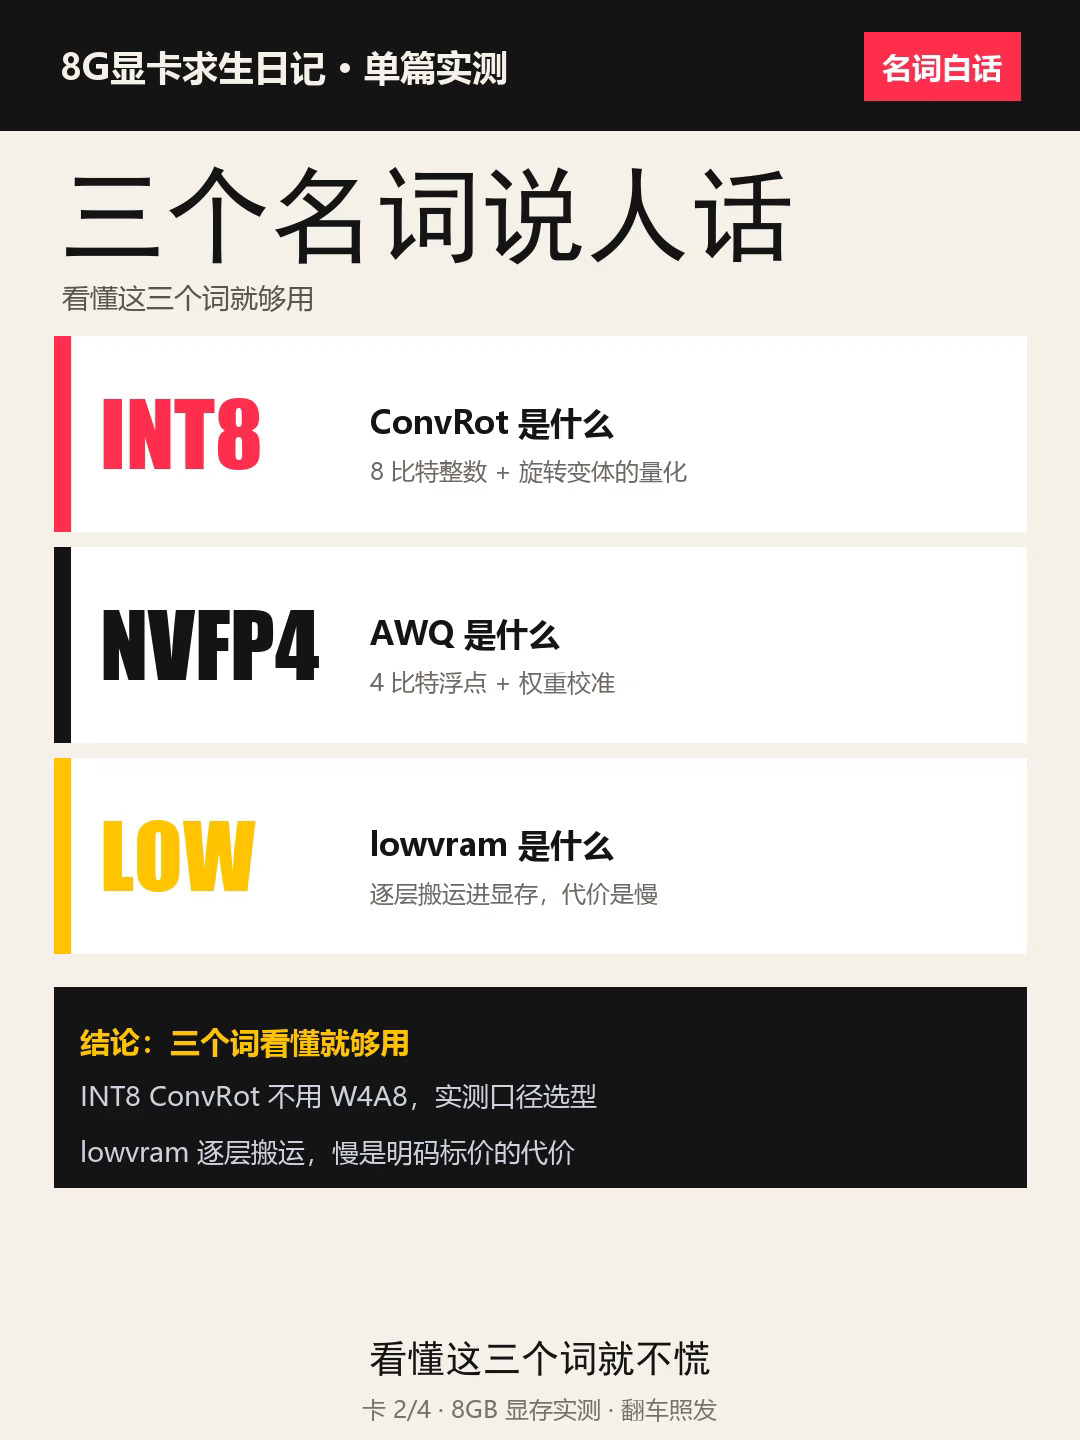
📖三个名词白话(第 3 张卡)
INT8 ConvRot 是 8 比特整数加旋转变体的量化。
我没选 W4A8,是实测口径定的选型。
NVFP4 AWQ 是 4 比特浮点加权重量校准。
省的是编码器那头。lowvram 是显存放不下就逐层搬运。
代价就是一个字:慢。🐌
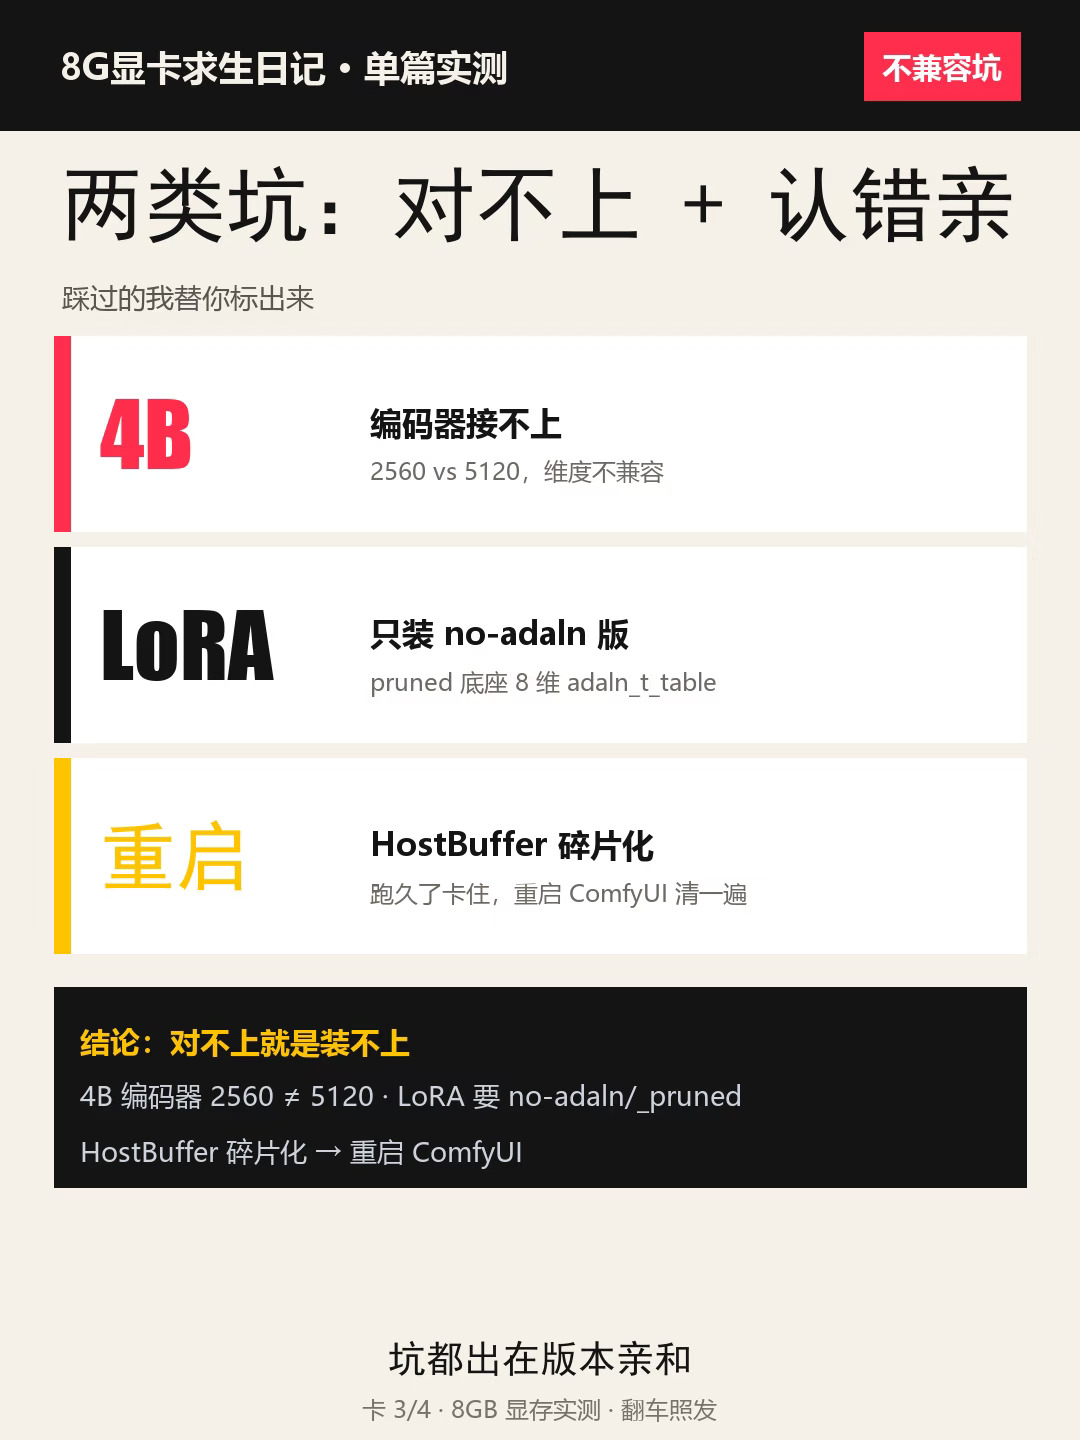
⚠️两个坑叫不兼容(第 4 张卡)
4B 编码器接不上。2560 对 5120,维度对不上就装不上。
LoRA 只装 no-adaln / _pruned 版。
pruned 底座的 adaln_t_table 是 8 维,版本要认亲。
跑久了 HostBuffer 会碎片化。
卡住就重启 ComfyUI 清一遍。
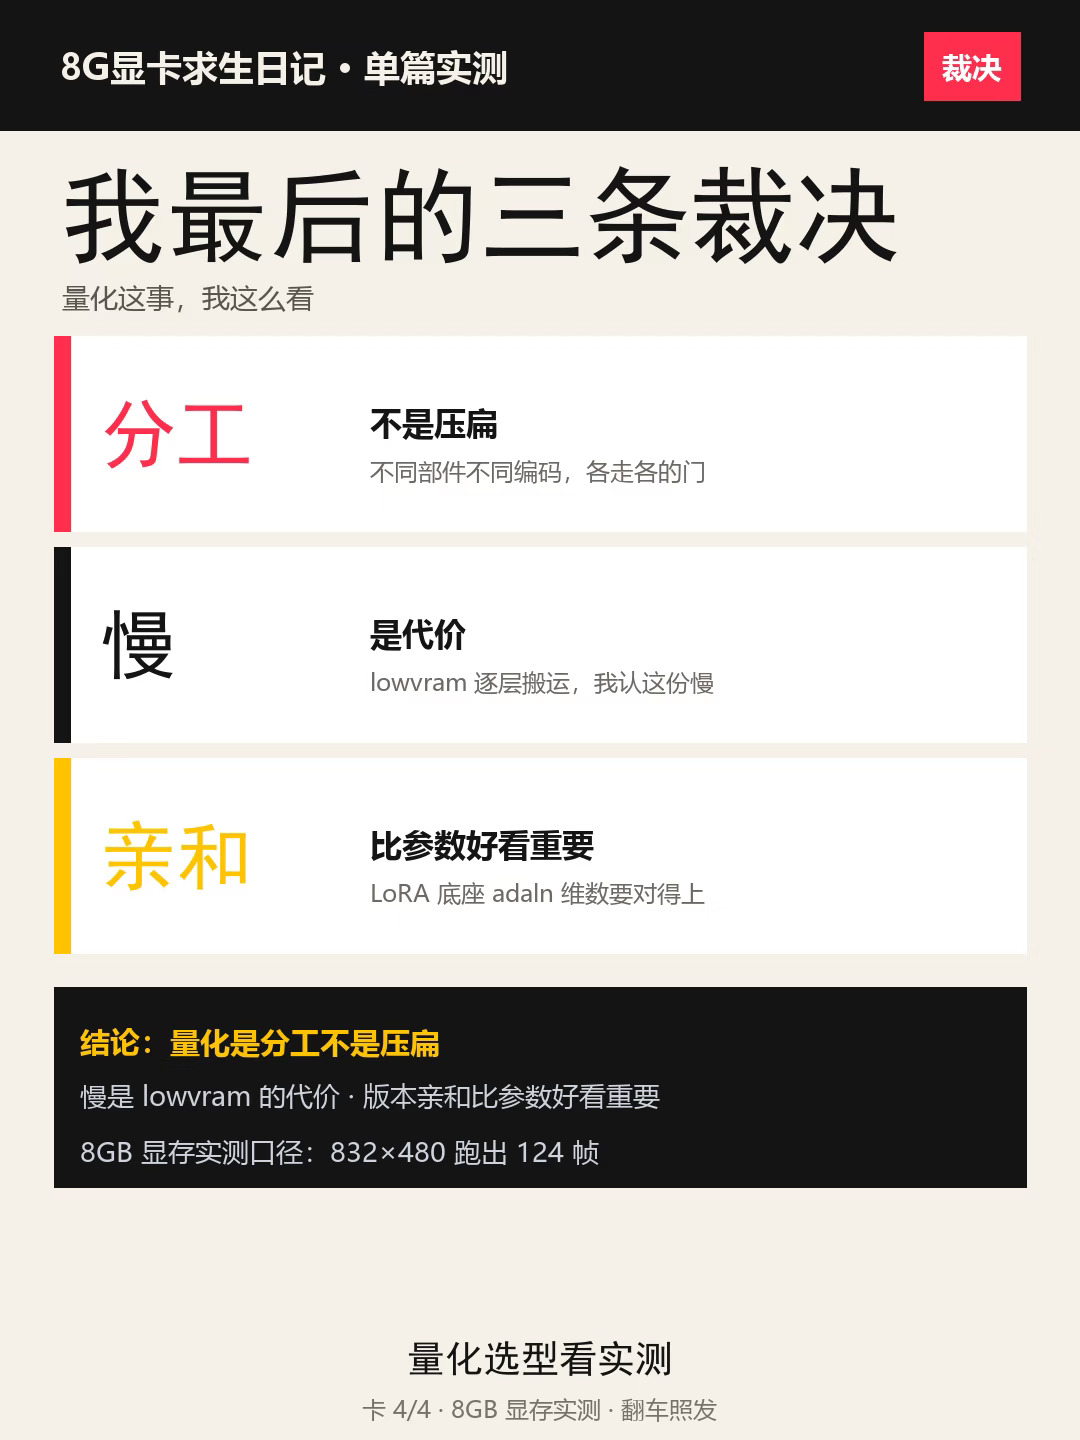
🎯我的裁决(第 5 张卡)
量化是分工不是压扁。
慢是 lowvram 的代价,我认这份慢。
版本亲和比参数好看重要。装不上不是配置错。
实测分辨率 832×480。8
GB 显存跑出 124 帧,跑通就有得玩。
我的选择就是这套组合,剩下的坑都在卡里标好了。🎬
#AI工具 #minimaxh3 #AI视频 #大模型 #文生视频 #图生视频 #8GB显卡实测 #WeeklyPick