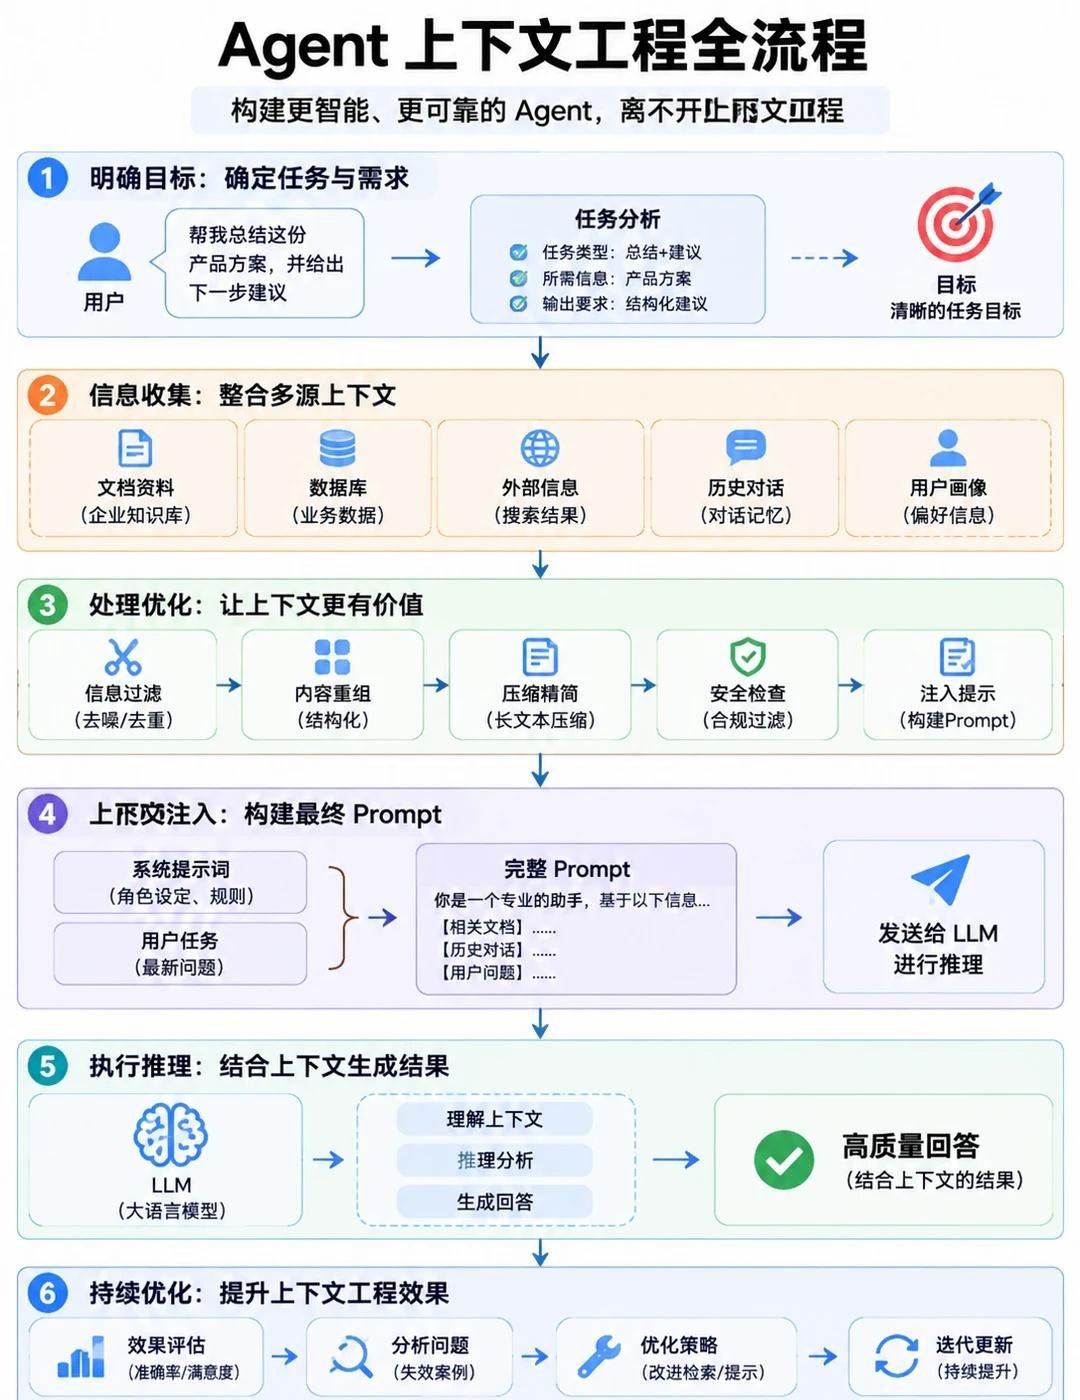
一张图看懂Agent上下文流程
Agent 不是接入大模型、写几个 Prompt 就能稳定运行的。
真正决定 Agent 能力上限的,往往是上下文工程(Context Engineering)。
简单来说,就是让大模型在正确的时间,拿到正确的信息,完成正确的任务。
整个流程可以拆成6个核心步骤👇
1️⃣ 明确目标:先搞清楚用户要什么
Agent 接收到用户请求后,不能直接把问题丢给 LLM。
需要先分析:
用户真正想解决什么问题?
当前任务需要哪些信息?
最终输出应该是什么格式?
比如用户要求总结产品方案,Agent 首先要识别任务目标、所需资料和输出要求。
2️⃣ 信息收集:整合多源上下文
上下文不是简单的聊天记录,而是来自多个渠道的信息。
📌 企业知识库:产品文档、技术资料
📌 业务数据库:订单、用户、业务数据
📌 外部信息:搜索结果、API 返回内容
📌 历史对话:用户之前说过什么
📌 用户画像:偏好、角色及权限信息
核心是按需获取,而不是把所有资料塞进上下文窗口。
3️⃣ 处理优化:让上下文更有价值
这是上下文工程最容易被忽略的环节。
主要包括:
① 信息过滤:去掉无关、重复内容
② 内容重组:按照任务逻辑组织信息
③ 压缩精简:降低 Token 消耗
④ 安全检查:过滤敏感信息和恶意指令
⑤ 提示注入:将有效上下文组织进 Prompt
注意,信息越多不代表效果越好,噪声过多反而影响模型判断。
4️⃣ 上下文注入:构建最终 Prompt
将系统规则、用户问题、检索资料、历史记忆组合起来。
重点不是 Prompt 写得多长,而是信息有没有清晰的层次。
例如:
System:定义角色与规则
Context:提供相关知识和历史信息
User:明确当前任务
Output:约束输出格式
5️⃣ 执行推理:生成高质量结果
LLM 根据上下文理解任务并生成答案。
复杂 Agent 还可能继续调用工具、补充检索、更新上下文,再进行下一轮推理。
关键是让每一步都有足够且可信的信息支撑。
6️⃣ 持续优化:形成效果闭环
Agent 上线后,还需要持续评估:
✅ 回答准确率与任务完成率
✅ Token 消耗与响应延迟
✅ 检索质量与上下文相关性
✅ Bad Case 分析与策略优化
通过真实错误案例,不断调整检索、压缩和 Prompt 组织策略。
💡 最后说一句:
以前做大模型应用,大家比的是谁更会写 Prompt。
现在做企业级 Agent,真正拉开差距的是谁能把上下文管理、工具调用、记忆系统和评测闭环做好。
会调用 API 只是入门,能把 Agent 做稳定、做可靠,才是真正的 AI 开发能力。
大模型 Agent