具身智能到底是什么?
“具身智能”听起来有点远,我们先用“拿起一个杯子”来理解。
可以先记住这个入门框架:让一个智能体借助自己的“身体”,在环境中感知、行动,并根据结果调整,去完成任务。
这里的“身体”不一定长得像人。机械臂、轮式机器人等都可以是研究载体,也可以先在仿真环境里用虚拟身体研究。
比如,把桌上的杯子移到托盘里。
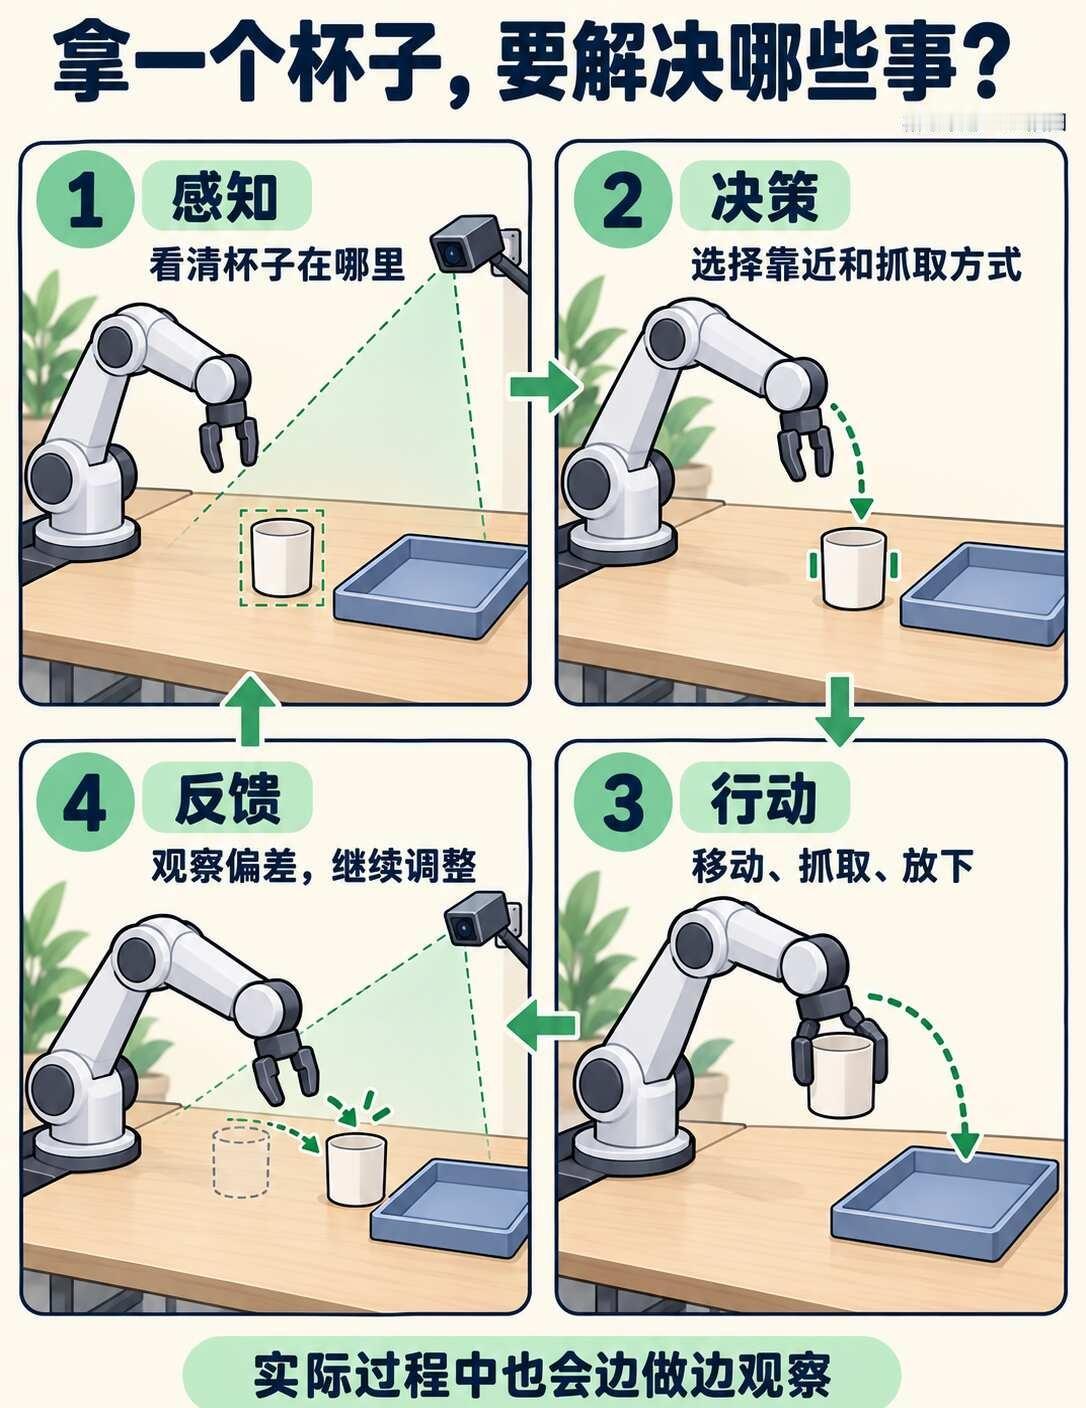
第一步是感知:杯子在哪里?托盘在哪里?中间有没有挡着的东西?可以把它理解为获取周围情况,不只是拍下一张照片。
接下来是决策:从哪边伸过去、抓哪里、先做什么后做什么?这里说的“决策”,就是选择下一步怎么做,不是说机器有了人的意识。
然后是行动:移动、抓住、放下。过程中和完成后都要观察结果,抓稳了吗、放好了吗?如果位置变了,就需要调整后续动作。感知、行动和反馈会相互影响。
所以,在只做文字问答的场景里,模型能告诉你拿杯子的步骤;要把任务真的做成,还需要身体、传感器和控制系统等一起配合。文字模型也可以参与这个系统,并不是两类技术永远分开。
看机器人演示时,也别只看外形或动作炫不炫。可以多问:它知道周围什么情况?目标是什么?环境变了会怎样?这比先记一堆缩写更有帮助。
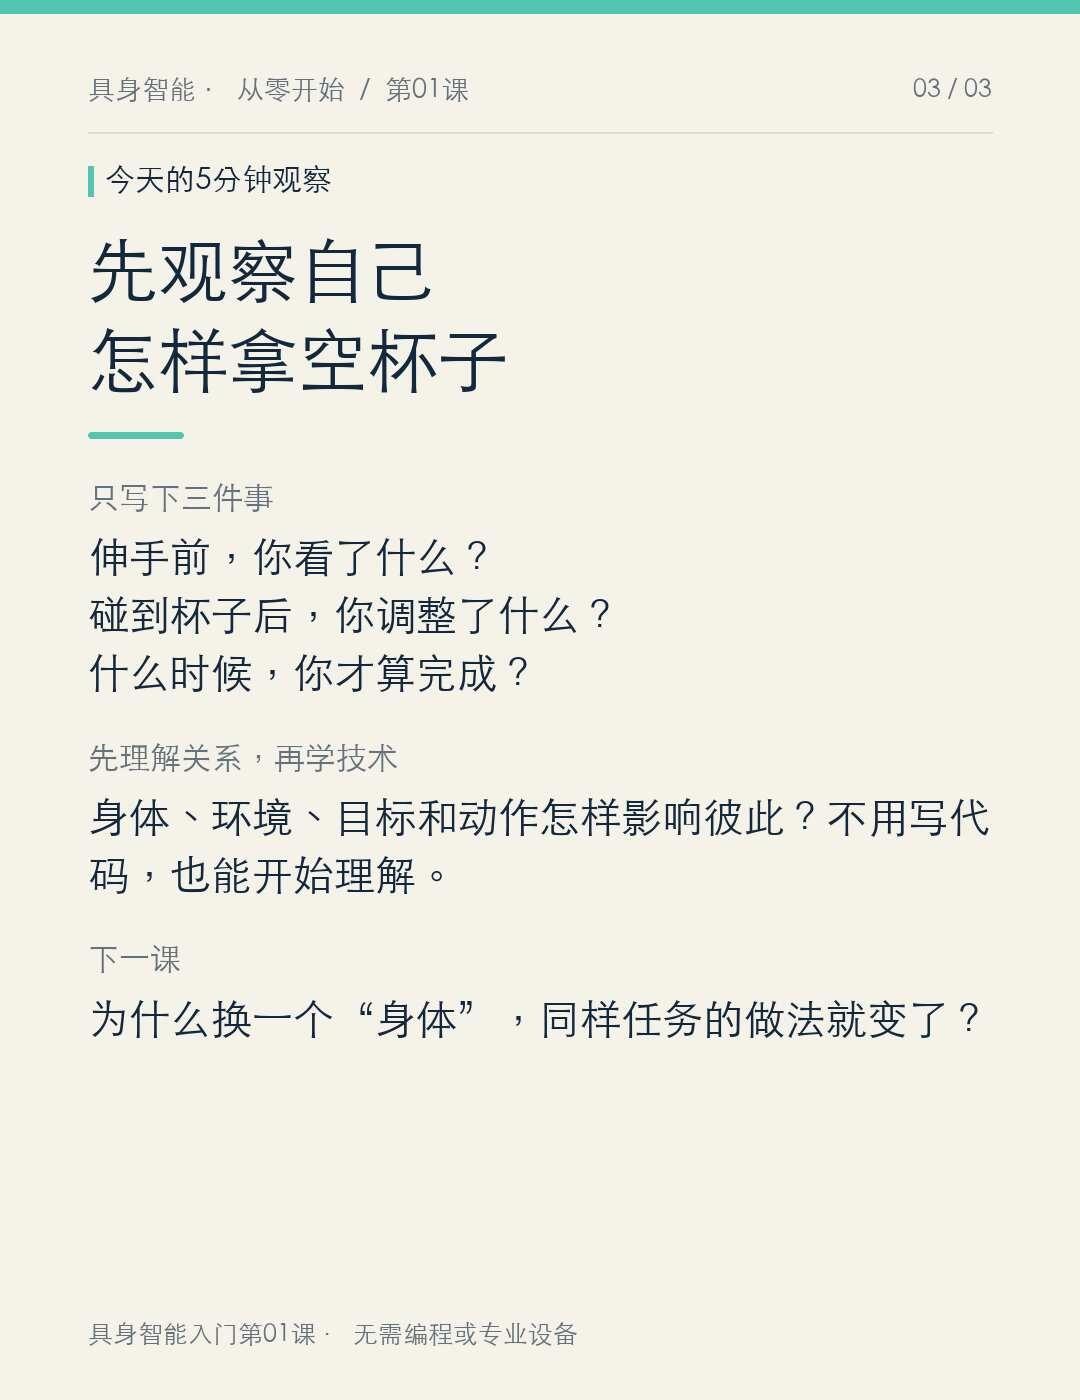
今天花5分钟,观察自己拿一个空杯子的过程:伸手前看了什么?碰到杯子后调整了什么?什么时候才算完成?先写下这三件事就好,不用代码和专业设备。
下一篇聊:为什么换一个“身体”,同样的任务做法就变了?
参考:AI Habitat概念介绍、Google DeepMind机器人研究介绍;2026-10-17查阅。本文为基础理解框架。
具身智能 机器人马拉松 人工智能