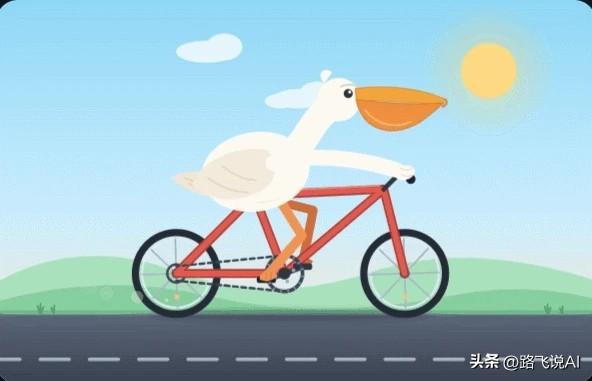
探寻人工智能,从技术到真实世界:鹈鹕测试,一个看似荒诞的小测试,照出了AI理解的真相
这几天后台被问到一个问题:网上说的“鹈鹕测试”到底是什么?今天我不讲热门项目源码,而是聊聊这个让AI圈着迷的小实验。
源头是一条看似无厘头的提示词:画一只骑自行车的鹈鹕。最初玩法来自Simon Willison分享的一个组合场景,把几种不合常理的元素叠在一起,让模型生成SVG图像。因为SVG是用代码描述的图形,这一步同时考察了模型的代码能力、空间结构和常识理解。
为什么一个“鹈鹕骑车”能成为测试?因为它没有现成题库可背。模型不仅要画出鸟的嘴、翅膀,还得让翅膀真正握在车把上、脚踩在踏板上、车架连成整体。哪一部分断裂、姿势错乱,一眼就能看出模型是在“理解”还是在“拼图”。于是它变成了一种低门槛的肉眼判断法,被不少人用来对比模型状态、感受是不是“降智”。
但Simon Willison后来也点出了它的局限:鹈鹕测试几乎触及不到当下最重要的能力——智能体的工具调用,以及随对话变长仍能稳定操作工具的能力。也就是说,它能反映模型的一部分,却远不等于全面评测。