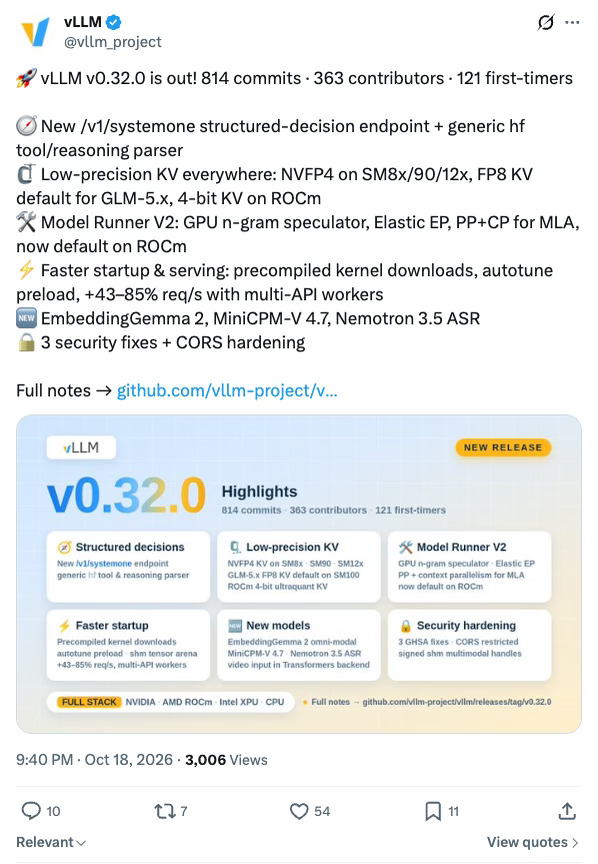
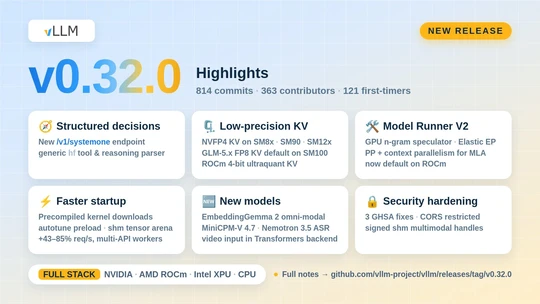
vLLM 发了 v0.32.0,814 个 commit,更新列了一长串,我主要看了两处。
一处是 KV cache 往低精度走得更狠了。NVFP4 的 KV 现在 SM8x、SM90、SM12x 都能用,ROCm 那边有 4-bit。真正要留意的是 GLM-5.x 在 SM100 上默认就开 FP8 KV。省多少显存、精度掉没掉,帖子里一个数都没给,只能拿自己的模型去测。跑 GLM-5.x 的人升级完要是发现输出和以前有点不一样,可以先从这条查起。
另一处是开多个 API worker 以后,req/s 涨了 43% 到 85%。区间拉这么宽,应该跟请求长短、并发多少关系很大吧,我猜短请求密集的场景涨得多一些,没验过。
还有个新接口叫 /v1/systemone,说是做 structured decision 的,我翻来覆去看了几遍,也没弄明白它跟现在的结构化输出到底差在哪。
#人工智能 #程序员 #AI