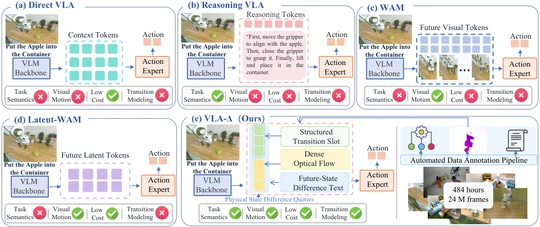
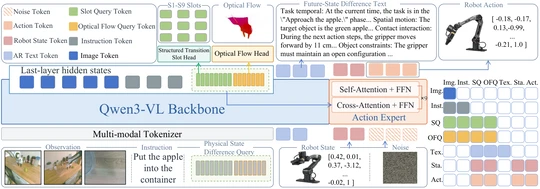
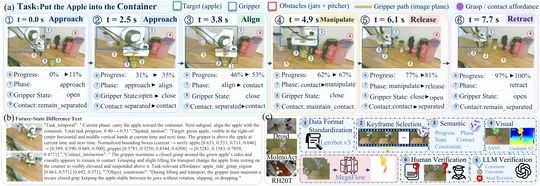
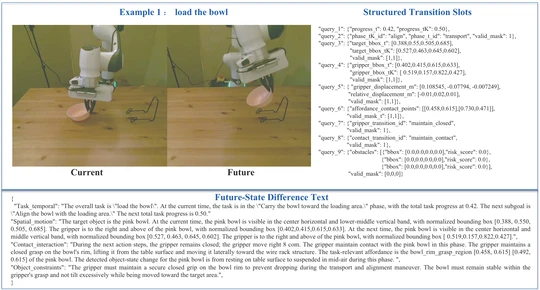
这篇的想法很直白:预训练时别只让 VLA 学“看到这个画面就出这个动作”,顺便让它预测接下来物体往哪挪、夹爪什么时候碰上东西,还有画面里的光流(每个像素往哪动)。到了微调和部署,这些辅助任务全扔掉,只留动作,推理不多花算力。
我主要看的是消融表。LIBERO 本身已经刷到 97、98 了,主表里各家挤在一起,看不出什么。
不用 query、不做预训练是 95.70,加上 query 到 96.25。同样的数据只拿动作做预训练,96.45,基本没动。在这个基础上单独加差异文本、结构化槽位、光流,分别是 97.20、96.90、97.35,三样一起上是 98.40。
作者想说的是数据本身帮助不大,涨点来自这三种监督。这个逻辑我认。可整张表从头到尾也就差 2.7 个点,单项之间只差零点几,文中没写跑了几个种子,LIBERO 一共才 40 个任务,零点几个点到底能不能算数,我心里没底。
还有一处我没想通。三样单独加,各涨不到一个点,合起来却比单项里分数高的光流(97.35)又多出一个点。光流和槽位明明都在管夹爪往哪走,监督有不少重叠,这一个点是从哪来的?
论文:https://arxiv.org/pdf/2610.21306
代码:https://github.com/ZJU-OmniAI/VLA-Delta
#机器人马拉松 #具身智能 #论文 #人工智能 #深度学习