IEEE | Mamba如何做好多模态融合?
论文标题: M3amba: Multi-Modality Mamba for Image Fusion
期刊:IEEE TIP
🔬 一、研究背景
红外图像擅长突出行人、车辆等热目标,可见光图像则包含丰富的纹理、颜色和边缘信息。如何将两者的优势结合起来,同时避免细节丢失和信息冗余,是多模态图像融合的重要问题。
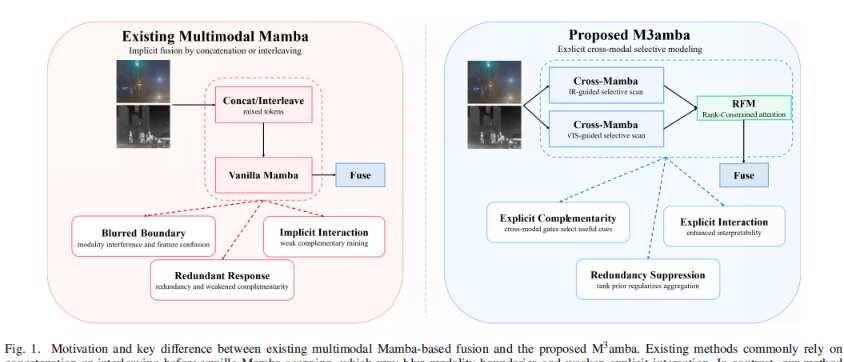
现有部分Mamba融合方法通常先拼接不同模态的特征,再进行统一处理,容易混淆不同模态的特征边界,无法充分挖掘互补信息
🧠 二、研究提出了什么?
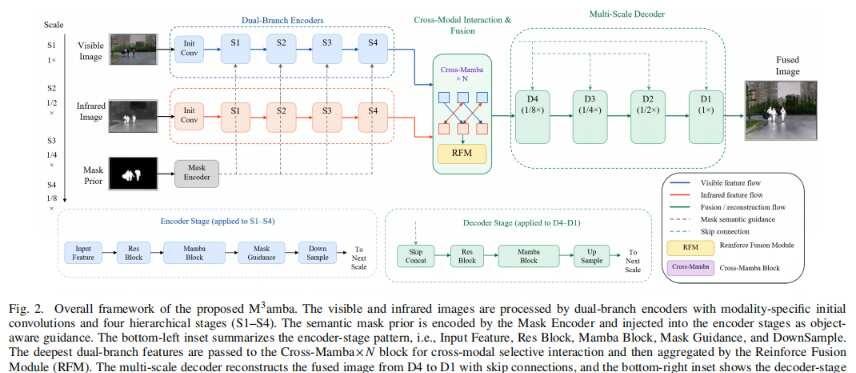
研究提出M³amba框架,核心是将Mamba扩展为支持显式跨模态交互的结构,并设计了三个关键机制:
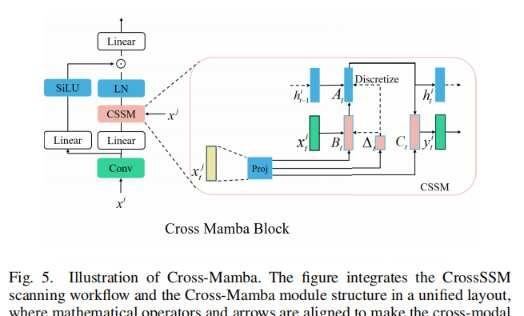
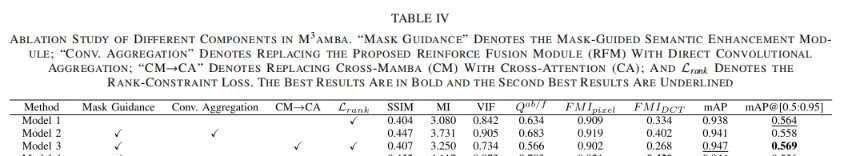
① Cross-Mamba: 借鉴交叉注意力机制,让一种模态的信息参与另一种模态的选择性特征提取,实现双向信息交互
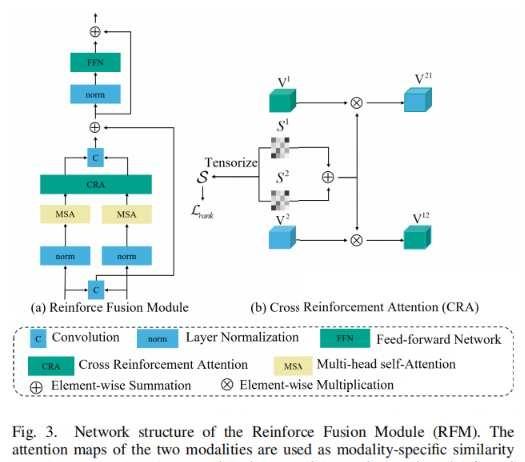
② RFM强化融合模块: 引入张量低秩约束,突出不同模态的互补特征,同时抑制冗余响应,让融合信息更加精炼
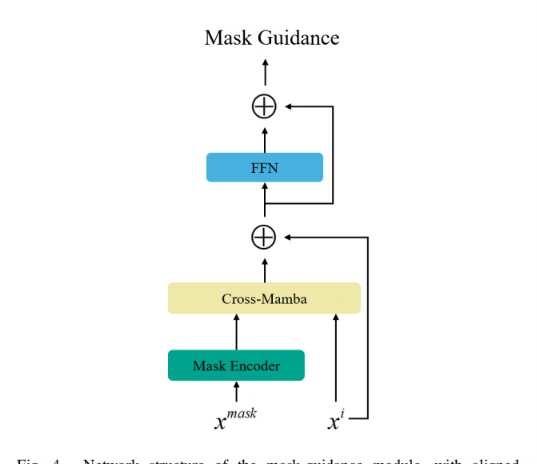
③ 掩码引导机制: 将语义分割得到的目标区域信息引入网络,增强行人、车辆等显著目标的表达,使融合结果更好地适配后续视觉任务
📊 三、实验结果如何?
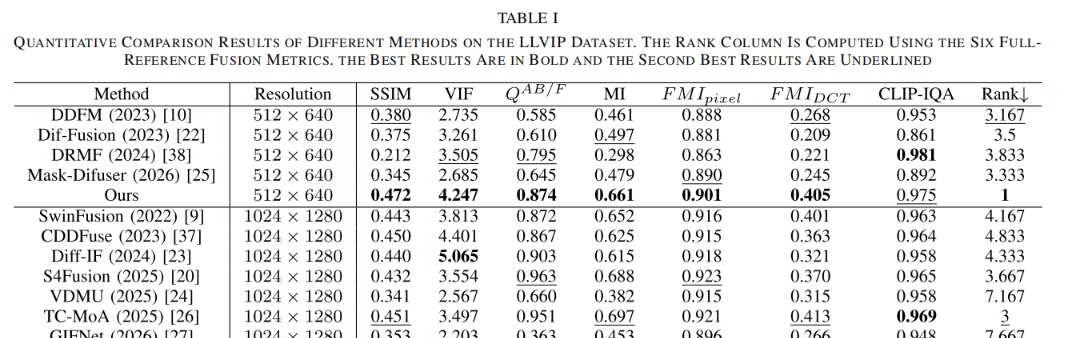
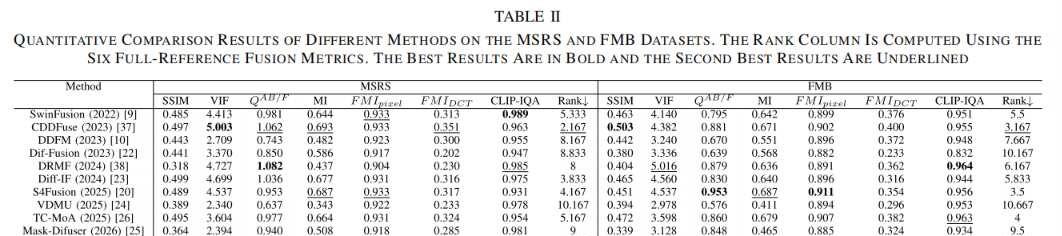
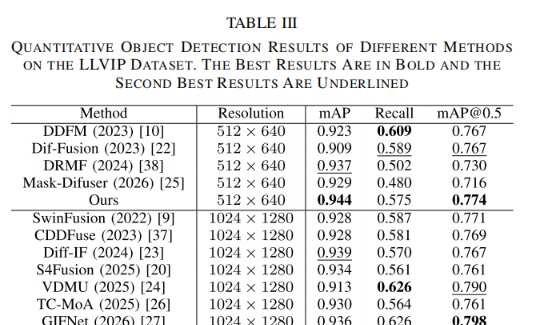
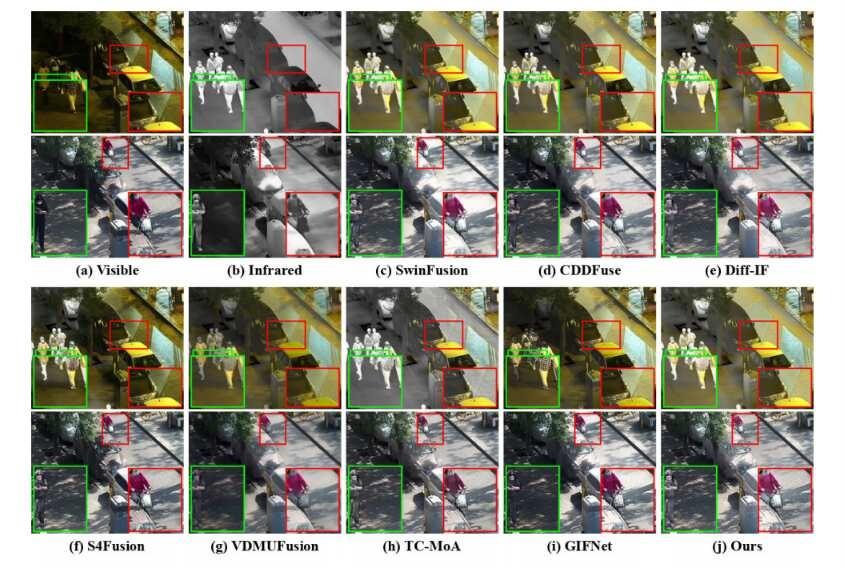
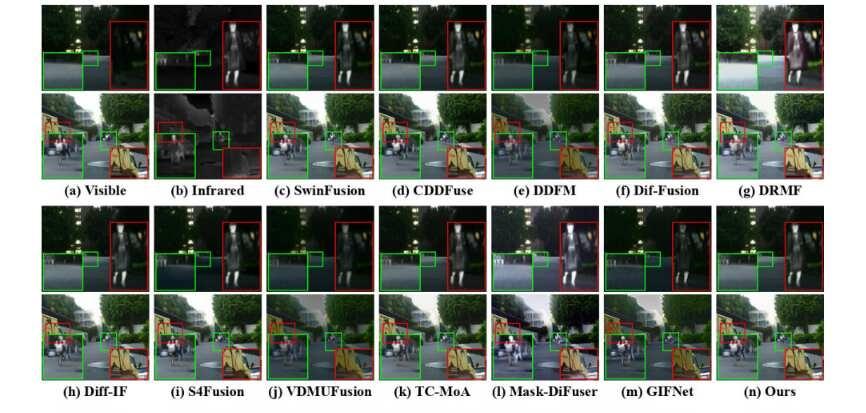
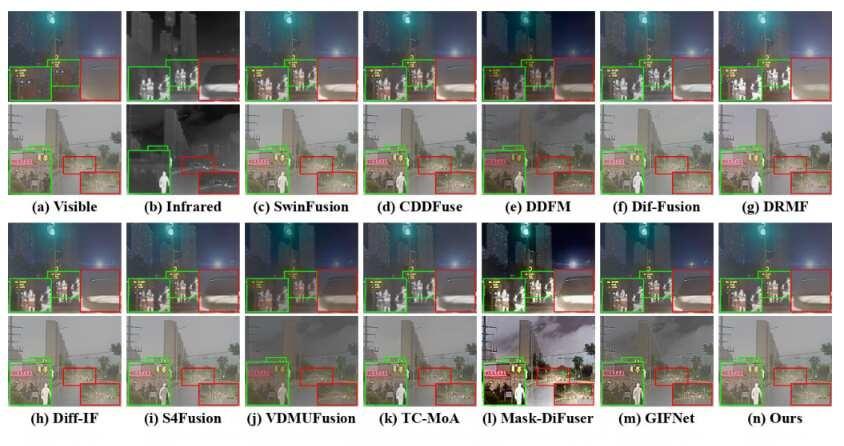
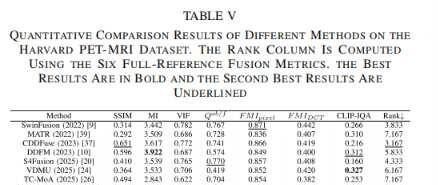
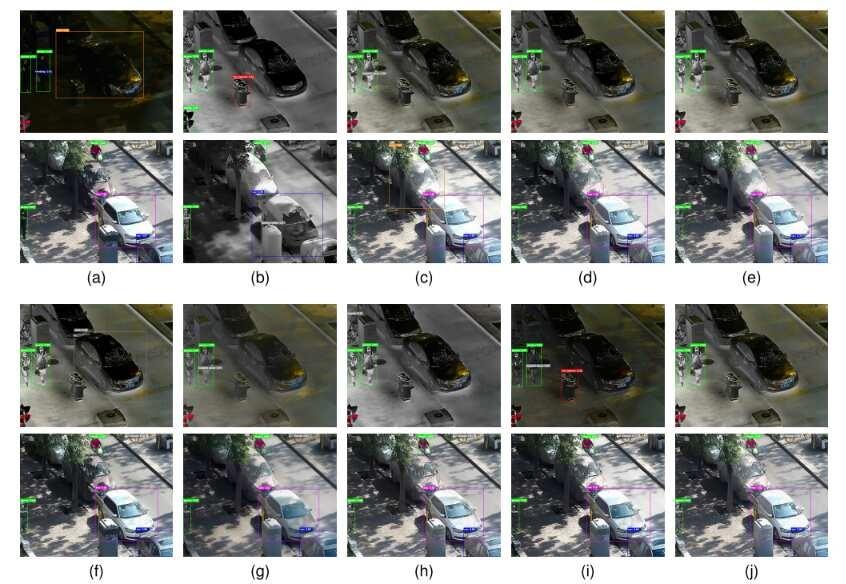
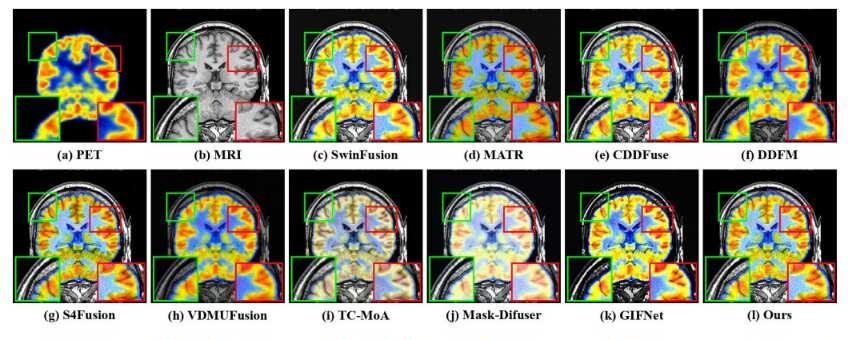
研究在LLVIP、MSRS和FMB三个可见光—红外融合数据集上进行实验,并在Harvard医学图像数据集的PET-MRI子集上开展额外验证,结果显示,该方法在多数融合质量指标上取得较好表现,能够保留可见光图像的纹理细节,同时突出红外图像中的显著目标。在低照度及复杂场景中,融合结果也表现出较好的细节保留能力,研究还使用预训练YOLOv8开展目标检测实验,结果显示,该方法在所测试的不同分辨率下取得了有竞争力的检测表现,在医学图像实验中,融合结果能够兼顾PET的功能信息与MRI的结构细节,提示该框架具有向其他多模态融合任务拓展的潜力
💡 四、研究启示与局限
这项工作的重点不只是把Mamba用于图像融合,而是重新设计跨模态信息交互、冗余抑制和语义引导机制,使融合过程更加有针对性
不过,医学图像验证仅随机选取20对PET-MRI图像,尚不足以证明其在更广泛医学场景中的稳定性。融合指标和目标检测表现的改善,也不能直接等同于临床诊断效益
📌 总结: M³amba为多模态图像融合提供了一种新思路:先保留各模态的独特信息,再显式交换互补特征,最后抑制冗余并利用语义信息引导融合。对于红外—可见光融合及医学多模态影像研究,这种设计值得进一步关注
多模态人工智能 计算机视觉 机器学习