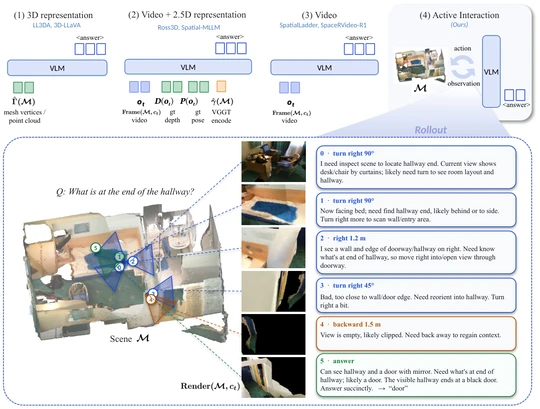
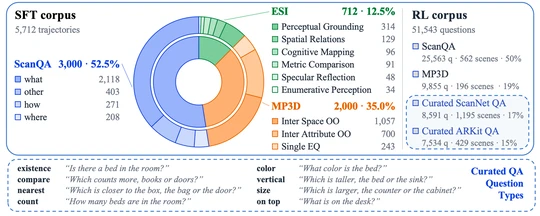
点开是因为标题里那个 explore。现在做 3D 问答,大多是把点云、多视角图或者视频整个塞给模型。这篇反过来,模型每次只看眼前一张渲染图,想看别处就自己发动作,往前走一米、左转 30 度,环境再渲染新图回来,看够了再答。Qwen3.5-9B 先做轨迹 SFT,再上 GRPO,奖励主要看答案对不对。
六个 benchmark 平均 53.2%,同一套交互协议下 Gemini 3.6 Flash 是 52.2%,没训过的 base 只有 31.2%。
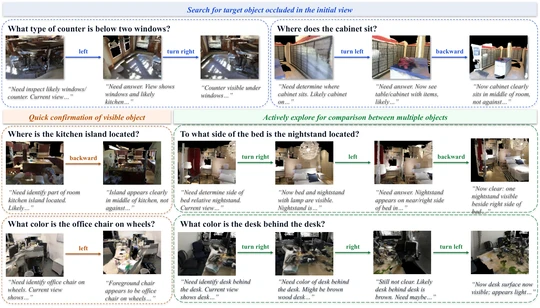
让我挺兴奋的是他们把 ScanQA 的题按“得走多远才看得到目标”分了组,这个距离按几何算,跟模型实际怎么走没关系。初始画面就能答的题,SFT 加 RL 一共只涨 0.6%;需要大范围探索的那组涨了 16.3%,其中 RL 单独贡献 10.9%。它确实学会了该多走的时候多走几步 😄
交互奖励的设计也挺巧。只有答对才给,只要某个视角里出现了题目问的那个物体,直接给满,之后再走不加分,钱只付给证据。拿掉这项奖励对比,交互次数从九到十次降到五六次,held-out 的 SPBench-MV 掉 6.4%,训练域倒是略高 0.3 到 2.3 个点。
另外相机不做碰撞检测,可以直接穿墙。
论文:https://arxiv.org/pdf/2610.21783
#人工智能 #大模型 #论文 #强化学习 #计算机视觉