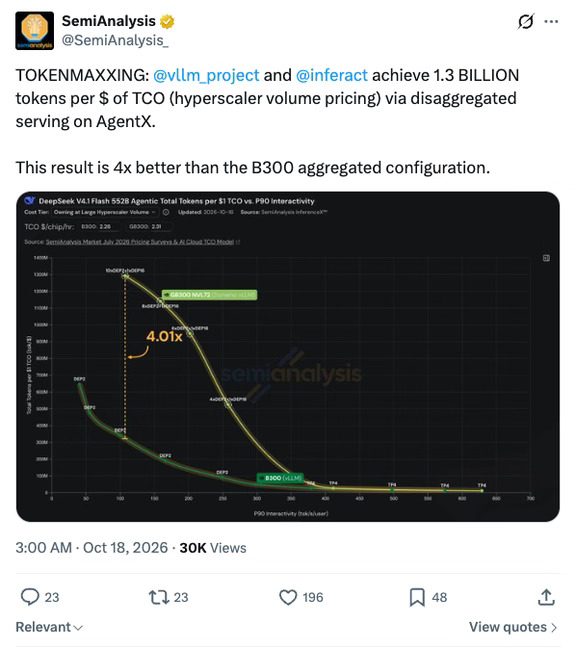
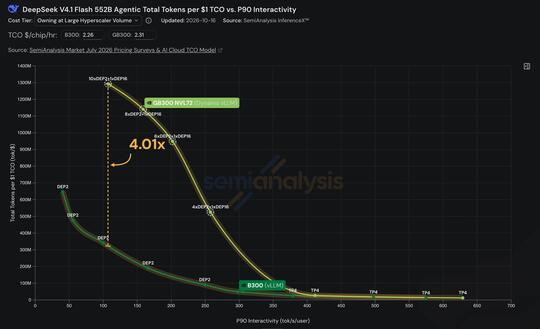
4.01x 那条虚线画在横轴 107 附近,也就是每个用户 P90 大约 100 tok/s 的位置。
图来自 SemiAnalysis 的 InferenceX,模型是 DeepSeek V4.1 Flash 552B,跑的是 agentic 负载。上面那条线是 GB300 NVL72 用 Dynamo vLLM 做分离式部署,最高点的配置是 10xDEP2+1xDEP16,每 1 美元 TCO 大约能出 13 亿 token。下面那条是 B300 单独跑 vLLM,同样的交互速度下只有 3 亿出头。成本按大型云厂商自持的价格算,B300 每卡每小时 2.26 美元,GB300 是 2.31,跟我们平时调 API 的价格对不上。
往右看就是另一回事了。GB300 那条线在 200 到 300 之间掉得很陡,到 4xDEP2+1xDEP16 只剩 5 亿出头。过了 400,两条线几乎贴在一起,标的都是 TP4。
#人工智能 #大模型 #DeepSeek #英伟达 #GP