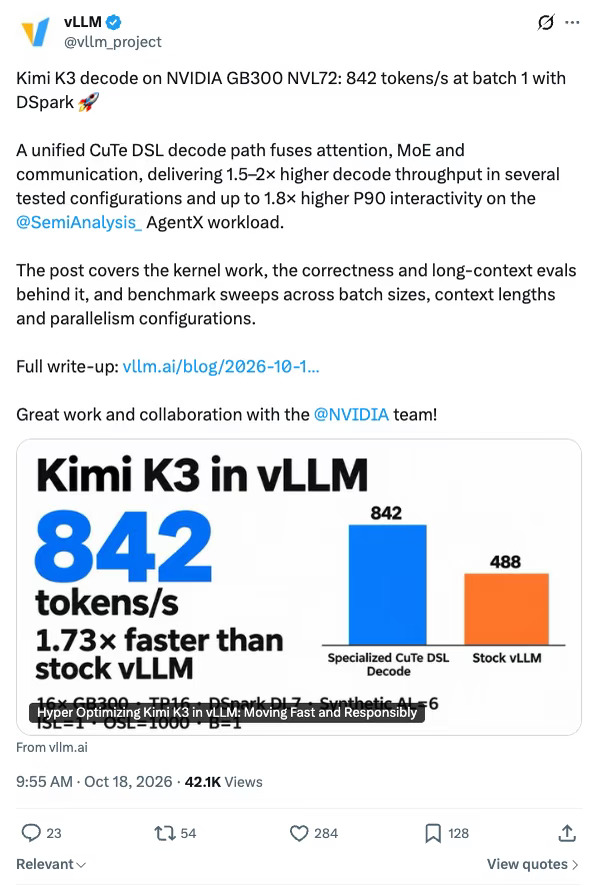
842 这个数我先打了个折,原因在配图底下那行小字里。
vLLM 发了 Kimi K3 在 GB300 NVL72 上的解码优化,用 CuTe DSL 写了一条统一的 decode 路径,把 attention、MoE 和通信融到一起。配图里 batch 1 跑到 842 tokens/s,原版 vLLM 是 488,快 1.73 倍。
小字里的配置是 16 张 GB300、TP16、DSpark DL7,后面跟着 Synthetic AL=6。AL 我理解成投机解码的平均接受长度,加了 Synthetic,看着像人为设定的。下半截被链接卡片挡住了。
另外两个倍数得分开看。1.5 到 2 倍是几种测试配置下的解码吞吐,1.8 倍是 SemiAnalysis AgentX 负载上 P90 交互性的上限。
kernel 融合的提速我不怀疑。可真实对话里接受长度够不到 6 的时候,这 1.73 倍还剩多少?
#大模型 #人工智能 #英伟达 #AI