用深度强化学习模拟竞争者的共址策略
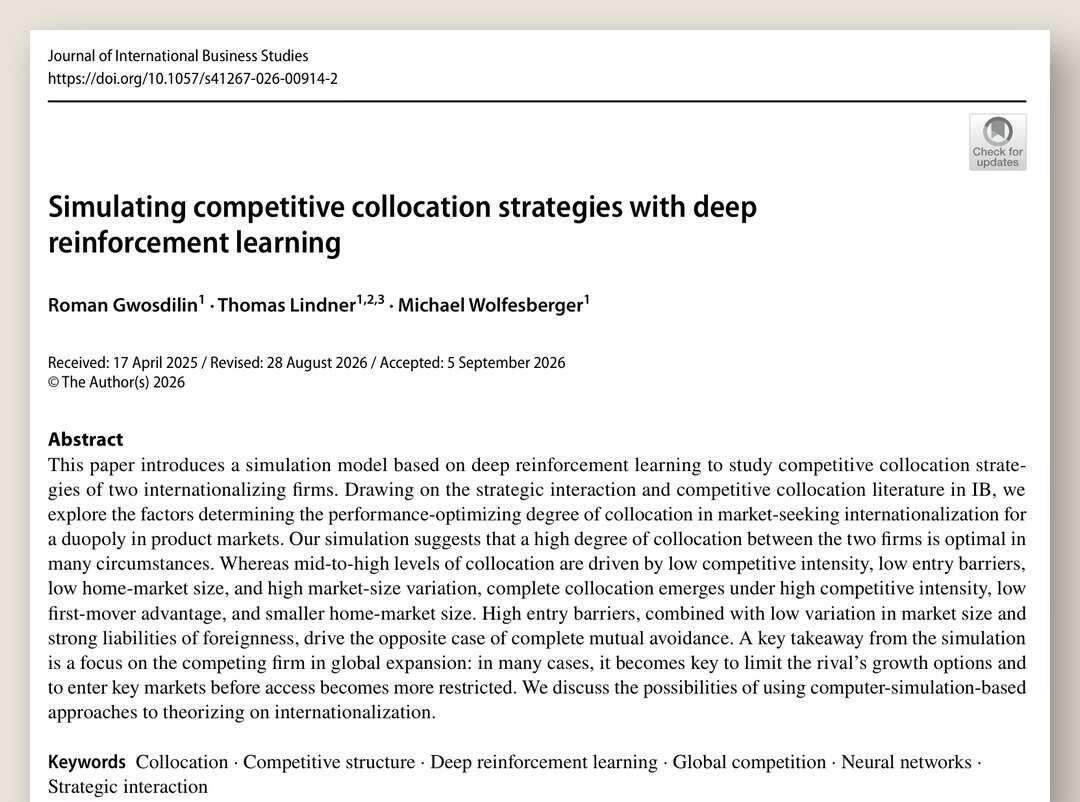
Gwosdilin, R., Lindner, T., & Wolfesberger, M. (2026). Simulating competitive collocation strategies with deep reinforcement learning. JIBS. Advance online publication
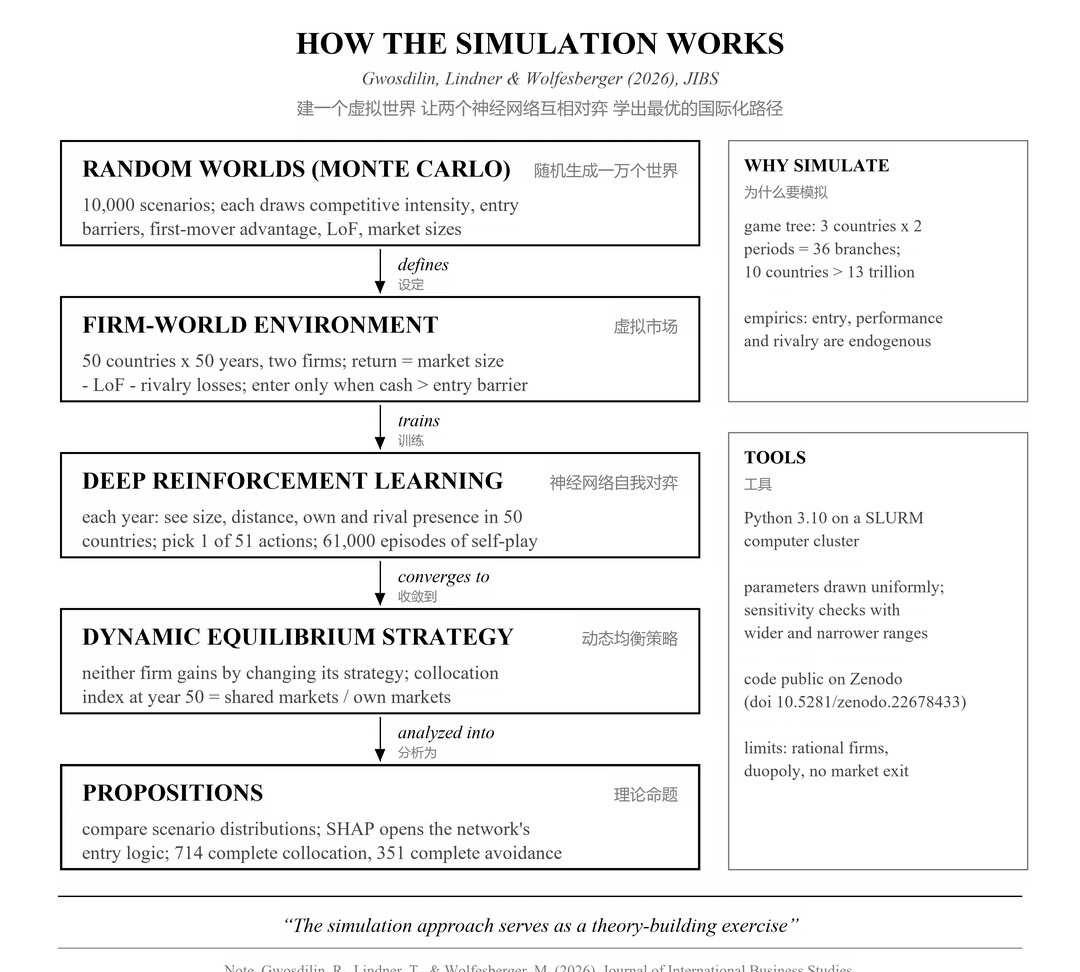
两家竞争的跨国企业应该进入同一批国家 还是互相避开 这就是 collocation 问题 实证研究很难处理其中的内生性 博弈论模型又会因为组合爆炸而无法求解 只有 3 个国家和 2 个时期的模型 博弈树已有 36 个分支 换成 10 个国家就超过 13 万亿种组合 所以过去的模型只能分析两三个国家
这篇的方法是建一个虚拟世界 有 50 个国家和 50 年 两家企业从各自的母国出发 每个国家的市场规模随机生成 并且逐年波动 企业在外国的收益要扣掉 liabilities of foreignness 这个成本随经验下降 两家企业进入同一国家时 收益按 competitive intensity 打折 先进入者的优势会在若干年后消失 累计现金超过 entry barrier 才能进入新市场 进入后不能退出
企业怎么决策不由研究者规定 而是交给两个神经网络 每一年它们观察 50 个国家的市场规模 距离 自己是否已进入 对手是否已进入 然后选择进入哪个国家或者等待 目标是累计收益超过对手 两个网络互相对弈 每个场景训练 61000 轮 直到谁改变策略都得不到更多好处 作者再把竞争强度 进入壁垒 先发优势持续年数等参数随机组合 生成 10000 个场景 用 Python 在计算集群上运行 并用 SHAP 打开神经网络看它每次进入时依据的是什么
结果 多数场景下最优的是中高程度的共址 完全共址出现在竞争激烈 先发优势弱 自己母国市场较小的情况下 完全回避出现在进入壁垒高 市场规模差异小 外来者劣势强的情况下 可以借用的是把模拟作为构建理论的工具 输出的是命题 再交给实证检验 代码在 Zenodo 公开 局限是模型假设企业完全理性 而且只有两家企业 模拟不能代替数据 但能告诉我们在收集数据之前应该去找什么 很少在 JIBS 上见到 simulation study
读论文