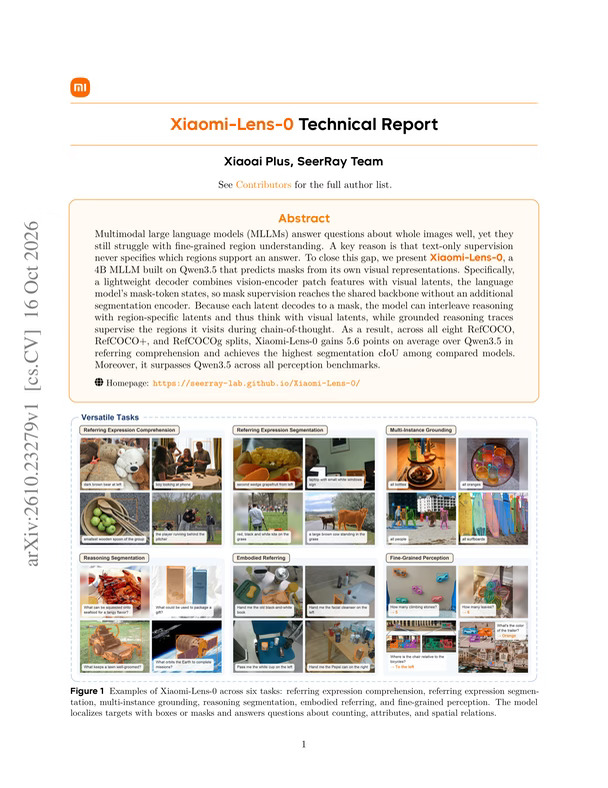
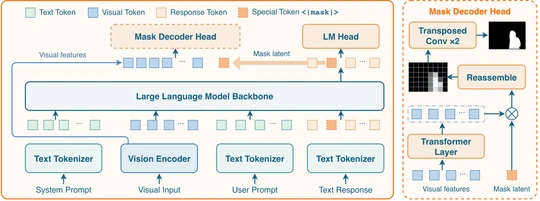
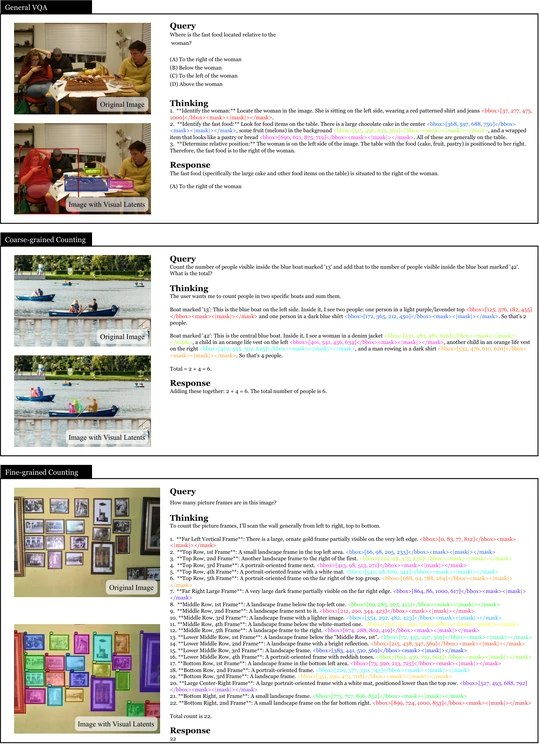
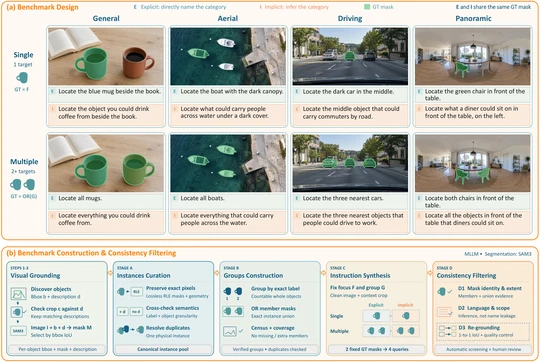
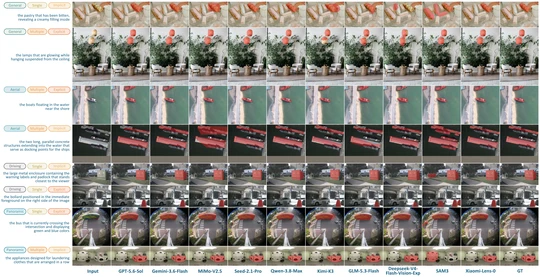
这篇的想法说白了就是:让多模态模型自己画分割 mask,直接用它自己 ViT 的 patch 特征来画,不外挂 SAM 那类分割编码器,这样 mask 的 loss 能一路传回主干,顺带把看细节的能力练上去。模型叫 Xiaomi-Lens-0,4B,基于 Qwen3.5。
摘要里那句“所有感知 benchmark 都超过 Qwen3.5”看着挺唬人,翻到消融表我才把账算明白。他们做了个 BBox-only 版本,Stage 2 数据一样,只把 mask loss 关掉。结果这个只学框的版本已经把 MME-RealWorld 中文从 60.3 拉到 66.1,CV-Bench 从 85.4 拉到 87.9。再加上 mask loss,分别是 67.5 和 88.1。
也就是说感知上涨的大头来自 grounding 数据和框监督,mask 自己贡献 0.2 到 1.4 个点。CV-Bench 那 0.2,我不太敢算成 mask 的功劳。
REC 这边 mask 的作用倒清楚些。RefCOCO+ 上比 BBox-only 多 2.4,RefCOCO 只多 1.1。RefCOCO+ 不让用“左边那个”这类位置词,只能靠外观和轮廓把目标从旁边几个里分出来,框给的信息确实粗,这个解释我买账。
mask 监督我信它有用,只是有用的范围比摘要写的窄不少,主要落在要靠形状分开邻居的那类题上。
#人工智能 #多模态 #大模型 #论文