MemT-1.0 值得留意,重点不在它多了一个模型名,而在它把“持久记忆”放进了模型计算本身,目标是让对话和 agent 复用历史信息时,不必每次重载原始上下文。🧠
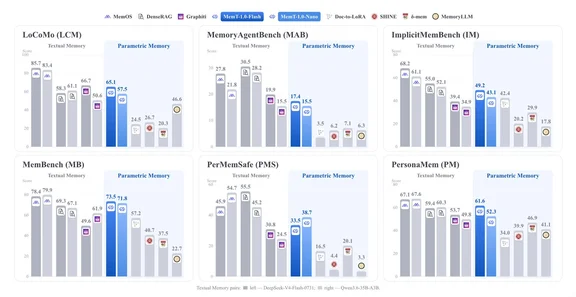
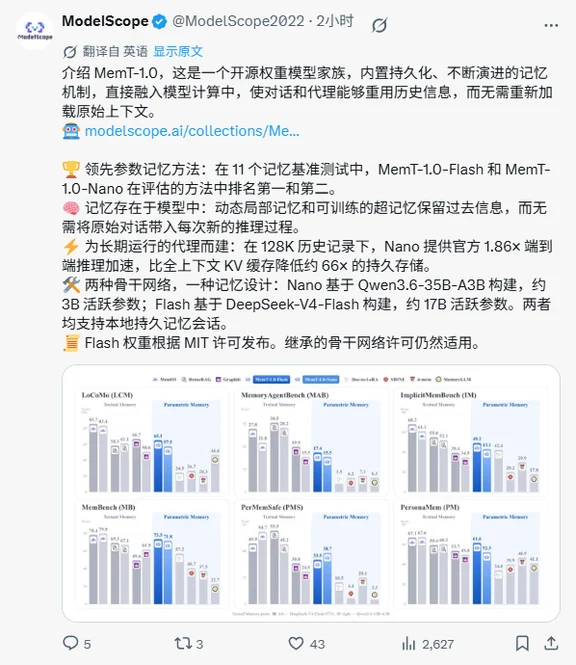
根据发布信息,MemT-1.0 是一个开放权重模型家族。官方称在 11 个记忆基准上,MemT-1.0-Flash 和 MemT-1.0-Nano 在参与评估的方法中分列第一、第二。这个成绩指向参数化记忆路线,但仍是官方基准结果,实际表现还要看更多场景。
它的记忆设计有两个关键词:动态本地记忆、可训练超记忆。按素材说法,历史信息留在模型侧,不需要把原始对话带进每一次新推理。对长期运行的 agent 来说,这可能比“反复塞上下文”更省事。
效率上,官方给出:在 128K 历史下,Nano 的端到端推理加速为 1.86 倍,持久化存储约为全上下文 KV cache 的 1/66。⚡ 两个主干也分得清楚:Nano 基于 Qwen3.6-35B-A3B,约 3B 激活参数;Flash 基于 DeepSeek-V4-Flash,约 17B 激活参数,二者都支持本地持久记忆会话。
我的看法:我倾向于把它看作“记忆内化”的一次产品化尝试,而不是简单的外挂记忆库。对读者可能的影响是,长会话助手和常驻 agent 的上下文成本、存储成本有机会下降;但基准排名不等于真实任务里的长期记忆准确率,遗忘、更新和本地部署门槛仍要观察。另外,Flash 权重以 MIT 发布,继承的主干许可证仍适用,商用前需要看清许可边界。
你更在意长期记忆的准确率,还是部署与存储成本?
#AI新鲜事