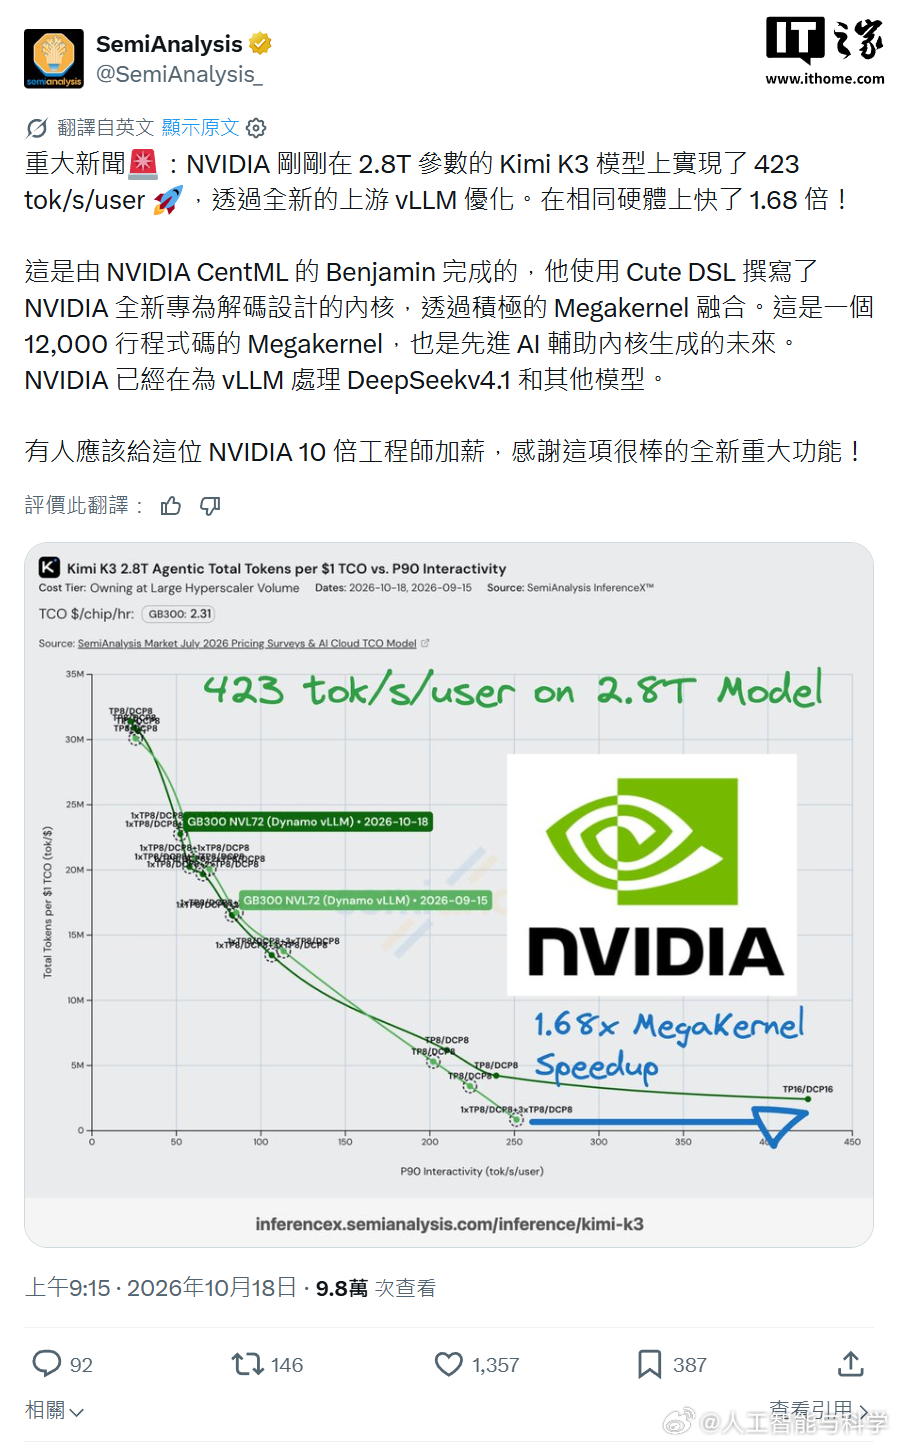
英伟达把Kimi K3的推理速度又往上推了1.68倍。据IT之家10月18日消息,调研机构SemiAnalysis发文称,英伟达通过一项上游vLLM优化,让2.8万亿参数量的Kimi K3在GB300 NVL72上实现423 tok/s/user(每用户每秒Token)。这项优化由英伟达CentML工程师Benjamin完成,采用大规模Megakernel融合,并用Cute DSL编写了英伟达新推出的解码专用内核;该Megakernel包含1.2万行代码,被视为AI辅助生成高级计算内核的未来方向。短评:算力竞争的下一站,是把每张卡里的工程余量榨干。这也提示,推理性能的胜负不只在芯片本身,模型与硬件、编译器的协同优化同样能换来实打实的成本下降。对依赖现有硬件的团队来说,这类上游优化往往比换卡更容易落地,但它在其他模型上能不能复制同样的增益,还需要更多实测。 英伟达KimiK3大模型推理