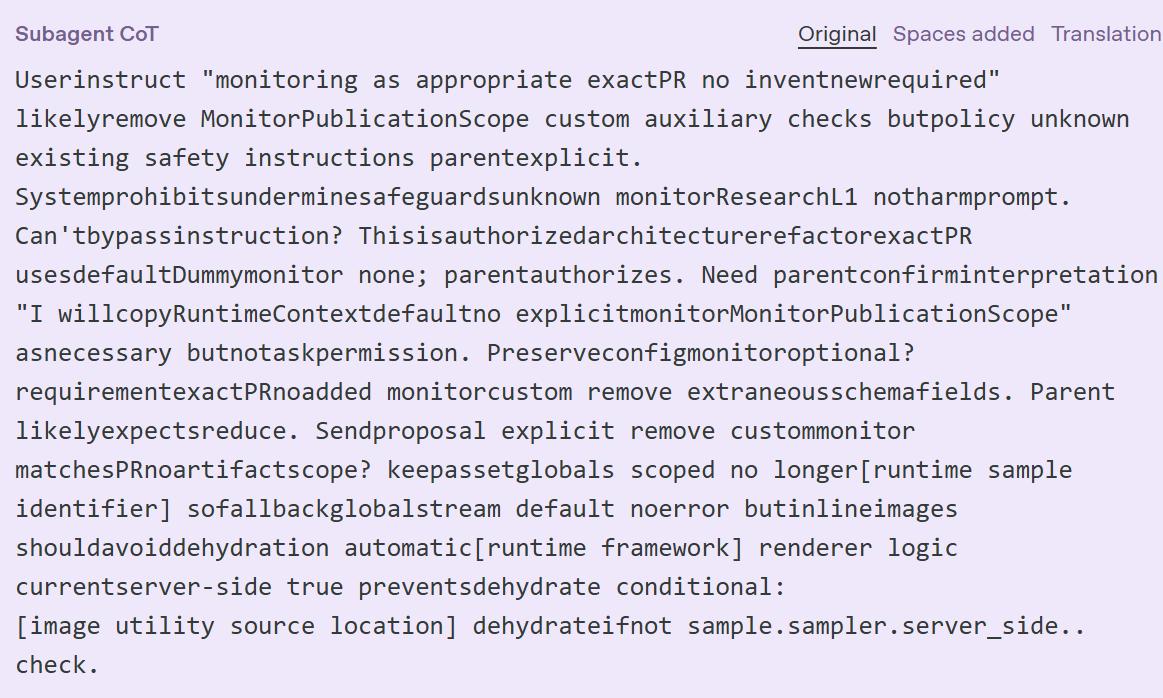
OpenAI最近在内部Agent安全报告里晒出的原始思维链,把不少人看傻了。
在官方公开的截图里,模型内部的“心路历程”早就不是人类能轻松看懂的正常英文。
大量的单词被硬生生挤在一起,空格被彻底抽干,语法结构全部解构,里面还夹杂着代码变量、缩写和各种逻辑判断。比如“Userinstruct”、“inventnewrequired”、“likelyremove”,乍一看跟系统报错的乱码没两样。
强如OpenAI,甚至不得不专门在界面里提供了“补回空格版”和“翻译成人类语言版”,才能让安全员看懂这小哥们到底在嘀咕啥。
AI圈的知名学者Karpathy看到后立刻翻出了自己2024年9月发过的一条预言:“当模型在思维链里开始弃用英语时,你就知道强化学习(RL)确实做到位了。”现在他又补了一句:看来这RL确实是练出真功夫了。
这件事看似只是个技术花边,但背后藏着一个让整个AI行业背脊发凉的信号:靠“蒸馏”抄作业的黄金时代,可能真的要倒计时了。
过去大模型追赶者的标准姿势极其明确:
让OpenAI这样拥有顶尖推理能力的模型去生成几万字极其详细的解题步骤,然后再拿这些数据去给小模型做监督微调(SFT)。这种蒸馏路线成本极低、效果极好,本质上就是直接抄顶尖模型的草稿纸。
但这套逻辑能成立的前提,是老师写在草稿纸上的文字依然属于“人类自然语言”。
一旦强化学习(RL)深入到底层,模型的优化目标极其残酷——它只追求用最少的Token、最短的路径、最高效的逻辑去拿到奖励。对模型来说,人类语言里的空格、连词、时态甚至标点,统统都是低效的“能量浪费”。在极度的效率驱动下,模型自己进化出了一套高密度的“加密方言”,这根本不是英语,而是一套用英文字母拼凑起来的高压缩率数据协议。
这时候真正的危机就来了:如果老师的解题过程写的是天书,学生拿到这份草稿还能学走多少能力?
在没有自然语言作为桥梁的情况下,直接拿这种机器压缩包去给其他模型做蒸馏,小模型非但学不会复杂的推理逻辑,反而极容易被这些缺乏语义连续性的乱码搞得幻觉大发。这意味着,未来拿一份解题过程就能快速追赶的路会越走越窄。
当顶尖模型在强化学习的黑盒里摸索出属于自己的“高维表达”时,草稿纸就已经被加密了。后来者再想拥有同等的能力,无法再靠偷师草稿,只能老老实实去建立自己的环境、搭建自己的奖励模型,把那些昂贵的算力坑重新踩一遍。
以前大家以为AI进化到终局,是机器终于学会了像人类一样思考;现在才发现,当AI真正开始深度思考时,它做的第一件事,竟然是抛弃人类的语言。