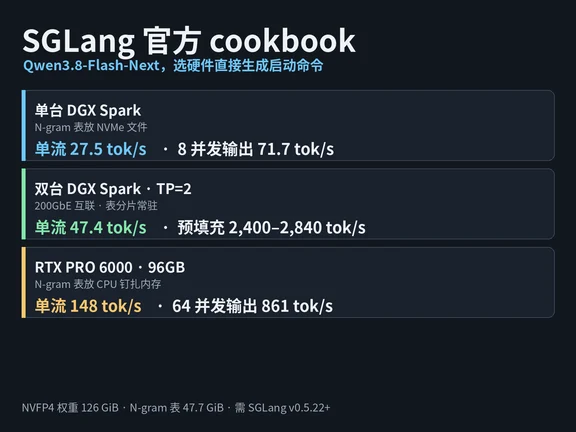
SGLang 发布 Qwen3.8-Flash-Next 官方 cookbook,需要 v0.5.22 或更高版本。页面按硬件和量化精度生成完整的 docker 启动命令,只给 SGLang 团队验证过的组合,每种配置都附实测数。模型 176B 总参数,其中 51B 是 N-gram 嵌入表,每 token 激活 6B。
最大的约束是体积。NVFP4 权重共 126 GiB:专家和稠密权重 78 GiB,FP8 的 N-gram 表占 47.7 GiB。单台 DGX Spark 的 128GB 统一内存装不下整表常驻,把表放主机钉扎内存也不行,GB10 上那是同一个内存池。
单台 Spark 的解法是把表文件化放 NVMe:表常驻内存为零,热页走页缓存、上限 8 GiB。官方实测,开 MTP 单流 27.5 tok/s、8 并发输出 71.7 tok/s,并发被钉在 8;关 MTP 单流 15.9 tok/s、24 并发 83 tok/s。有个启动坑:已填充的表文件每次启动要整表重写,约 17 MB/s,一次约 55 分钟,官方办法是启动前删掉旧表文件,新建约 10 分钟。
两台 Spark 走 TP=2,经 ConnectX-7 200GbE 互联,表分片常驻、每台约 65 GB 权重。实测 100K token 预填充 2,400–2,840 tok/s,单流 47.4 tok/s。跨节点要注意 NCCL 版本:2.28.x 有 decode 死锁,cookbook 的镜像用 2.29.7 和 2.30.7。
单卡 RTX PRO 6000(96GB)也能跑,条件是表放 CPU 钉扎内存,主机至少留 64GB 空闲内存。实测 1024 进 256 出:单请求开 MTP 每 token 5.9 毫秒、148 tok/s,16 并发 613 tok/s;无 MTP、64 并发 861 tok/s。各配置 GSM8K 在 96.9% 到 97.8% 之间。
精度版本各有仓库:BF16 和 FP8 跑 H200、B200、B300 和 AMD MI350X、MI355X;两个 NVFP4 版本只支持 Blackwell,其中英伟达版是 ModelOpt 混合精度,需要新镜像,启动时不要手动指定 quantization 参数。