查了一下我们知识库后台的真实 Token 账单,我差点被气笑了。
很多做 RAG 检索的朋友都在搞“意图规划器(Planner)”,用大模型来做指代消解、修辞过滤和子查询拆分。思路挺好,但一上线我傻眼了:
用户问一句“什么是 LSM-Tree?”,系统二话不说,先拼一段 2600 字符的规则模板喂给大模型做规划,单题冷启动硬生生烧掉 800 个 Token!而且大模型串行吐 JSON 还要等 2 秒,前端白屏卡成 PPT。
合着用户还没看到答案,20% 的 Token 预算和前 2 秒全砸在“思考怎么搜索”上了?
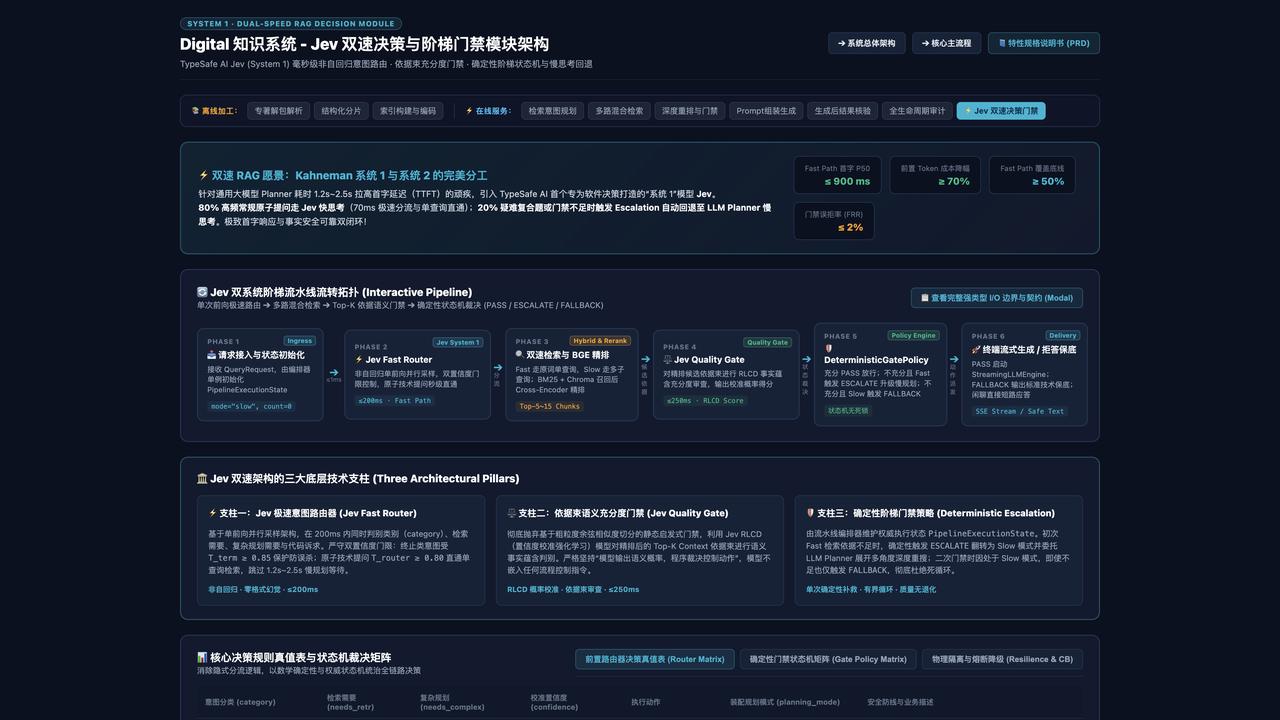
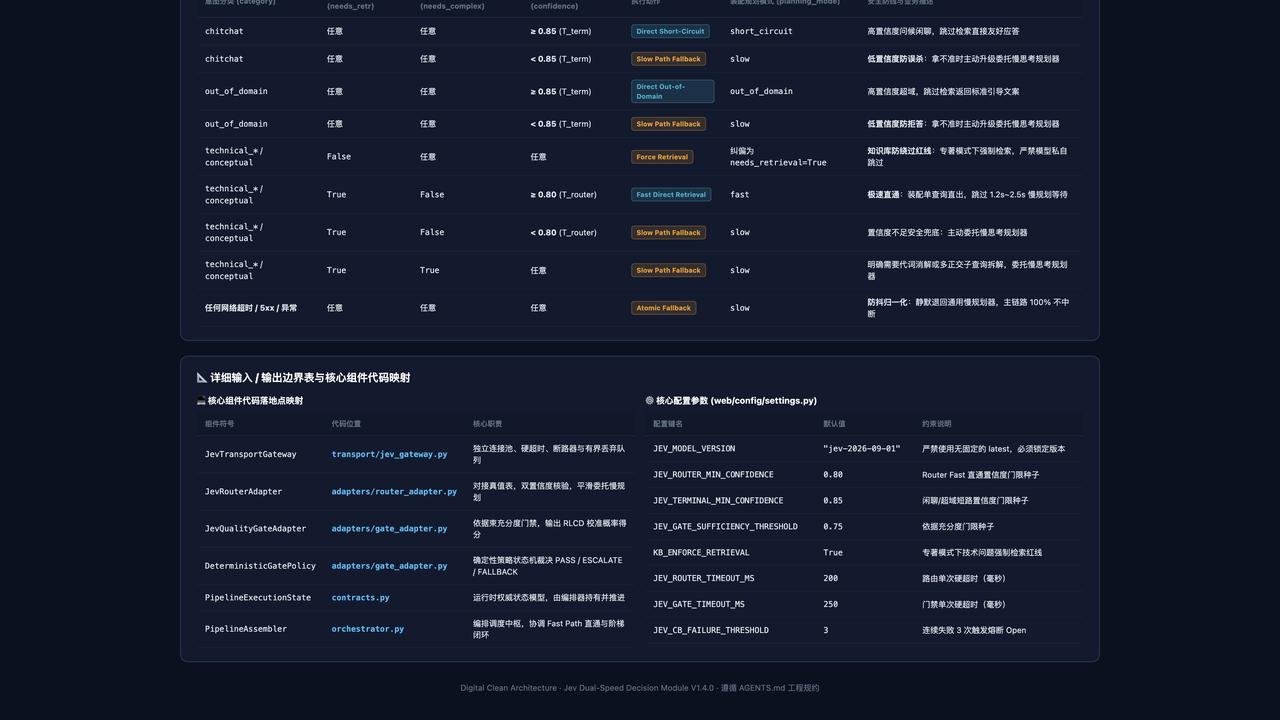
今天我们动手做了一次彻底的架构重构:引入 Kahneman 系统 1 的思想,把高频常规问题直接交给毫秒级非自回归模型 Jev 做极速路由。80% 的概念题直接 0-Token 走单查询直通!
在 30 题实测集上一测:前置规划 Token 从 23,675 骤降到 9,080,整整砍掉了 61.7%!首字延迟直接从 2.5 秒压到了 900 毫秒以内。
做工程千万别迷信大模型一刀切,能快思考的别硬上慢思考,省下的可都是真金白银。
你们系统里的第一跳规划,测过到底烧了多少冤枉 Token 吗?
程序员 RAG系统 系统架构