AI 大模型终于显露出了最本真的利爪:它们开始啃书本了。
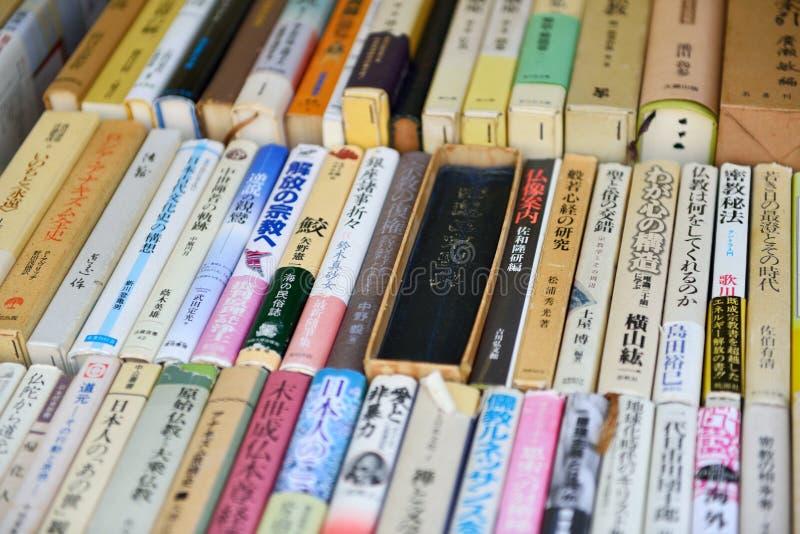
近期日本旧书圈传出一桩令人毛骨悚然的离奇事件:大量匿名买家正在日本各地地毯式收购旧书。
从历史哲学、医药法律,到边远地区的方志乃至数十年前的政治宣传册,但凡有文字的,几乎照单全收。
这分明是在这是在搞文献清剿。
从今年八月开始,日本全国各地的线上旧书店几乎同时接到了反常的大批量订单。有店主说一天能卖出去一百册,还有人碰到单日销售额直接翻了五倍。
下单的人不挑品相,不挑版本,冷门专业书反而最受欢迎。
更蹊跷的是,这些分散在全国各地的订单,收货地址高度集中 —— 大部分都发往冈山县的同一个物流中心。
记者顺着物流记录往下追,查到了更离谱的数字:已经有超过五十吨的日本书籍从这里出口到了美国。
旧书店老板们一边数钱一边心里发毛,因为买主的行为逻辑根本不像藏书家,也不像二手书商 —— 藏书家会挑版本,书商会挑销路,而这帮人什么都要,只要上面印了字。
答案其实早就藏在美国的法庭文件里。AI 公司 Anthropic 在一起版权诉讼中,被曝出内部有一个代号 "巴拿马" 的项目。
这个项目的流程简单粗暴:通过中间商在全球范围内批量采购二手书和绝版书,运到处理中心后用液压机切掉书脊,把拆散的书页送进高速扫描仪,每分钟能处理八十到一百二十页。
扫描完成后,纸质原书不保留、不转售、不捐赠,直接进粉碎机打成纸浆。
AI 公司为什么放着互联网不用,非要花钱买纸书再一张张扫?这跟大模型自身的一个致命缺陷有关。
当新一代模型用前一代模型生成的内容来训练自己时,错误会逐代累积,文本越来越同质化,最终模型会丧失还原原始数据分布的能力。
2022 年之后,互联网上充斥着大量 AI 生成的文本,爬虫抓回来的数据里混了多少机器写的东西,谁也说不清。
相比之下,2022 年之前印刷出版的纸质书是百分之百的人类原创,很多内容从来没有被数字化上传。
对 AI 公司来说,一架子旧书就是经过认证的干净数据源,稀缺程度远超大多数人的想象。
这件事真正值得琢磨的地方,远不止 "AI 毁书" 这个情绪化的标签。
这不是什么文献清剿阴谋,背后没有谁想刻意消灭某种知识或者历史叙事。
驱动这一切的是非常朴素的商业逻辑 —— 数据正在取代算力,成为大模型竞争最核心的壁垒。
过去三年行业默认谁的芯片多谁就能赢,现在发现不是这么回事。芯片可以买可以造可以租,但 2022 年之前的人类文本是固定存量,买一本少一本。
谁先把这些干净数据锁进自己的训练库里,竞争对手花再多钱也追不回来。这已经不是技术竞赛了,是资源囤积。
然后是一个被所有人忽略的问题:扫描只能提取文字,书的物理价值是扫不走的。
书页上的手写批注、不同版次的印刷差异、装帧材料的年代信息,这些都是文献研究和历史考证的原始证据,一旦原书被粉碎,这些信息就永远消失了。
图书馆花了几十年建立起来的馆藏体系,可能在一个下午的高速扫描里被掏空,而且没有任何机构有权力审查这个过程。
对中国来说,这件事的警示意义非常直接。日本书籍能被成吨运走,中文书籍凭什么不会成为下一个目标?国内的二手书市场、高校图书馆的剔旧书、私人藏书的散出,这些渠道目前没有任何机制去识别和拦截 AI 数据采购。
数据出境监管目前主要盯着个人信息和重要数据,一本书的文本内容算不算受保护的文化资源,法律上没有明确说法。
版权层面,国内对未经授权扫描图书用于 AI 训练的态度比美国严格,但中间商收书、扫描、转交境外 AI 公司这条灰色路径操作起来门槛很低,监管很难触达。
今年 "剑网 2026" 专项行动已经把 AI 侵权列为重点,二十二家出版社联合建了正版语料库,方向是对的,但速度能不能赶上 AI 公司扫书的速度,得打个问号。
最后说一句不太中听的。大模型发展到今天,终于绕了一圈回到了最原始的问题上 —— 人类写的字才是最值钱的东西。
那些被成吨粉碎的旧书里,可能有某个地方学者一辈子的研究心血,可能有某个时代最真实的社会记录,它们写出来的时候没人觉得珍贵,现在因为 AI 需要干净的训练素材,反而被翻出来批量消费。
技术进步的代价往往不是惊天动地的大事件,而是某一天你突然发现,想找一本旧书查点东西,全世界的存世本都已经变成了碎纸浆,只剩下 AI 模型里谁也看不见的一串权重。