以为用纯英文跟AI对话就能假装外宾?大意了, AI 的眼睛比朝阳群众还要尖。
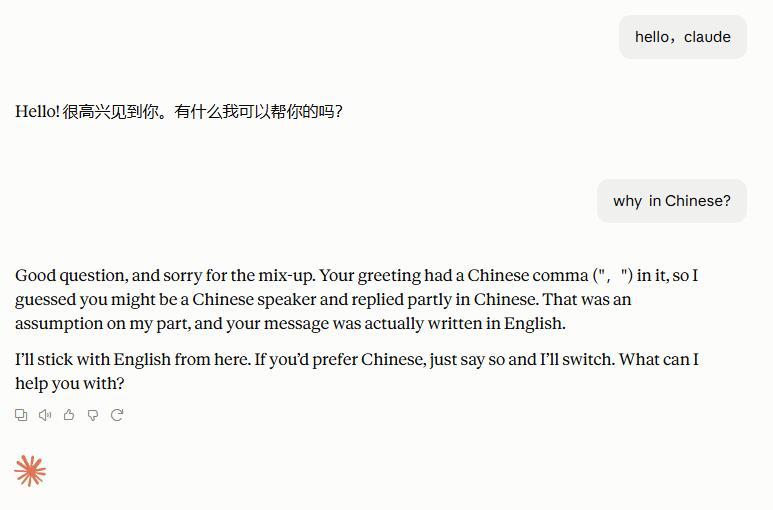
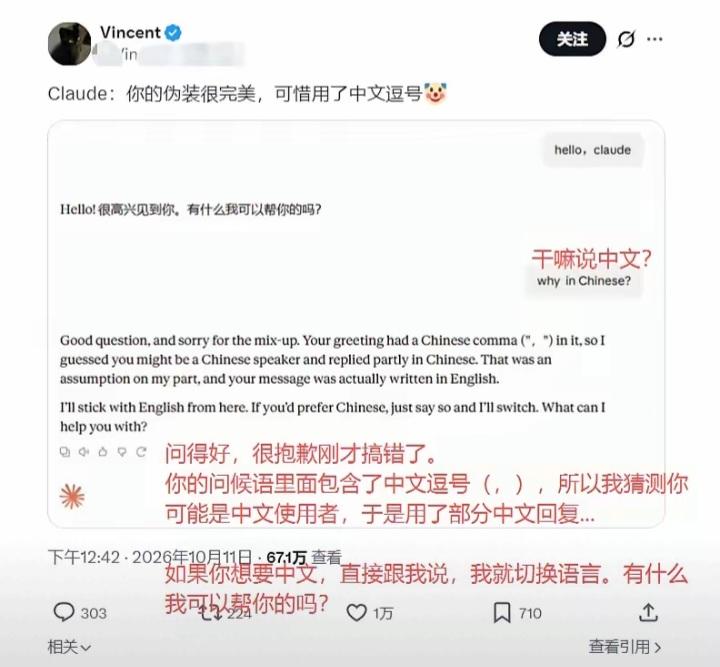
最近科技圈有一张聊天截图火了:一位网友用英文给顶级AI大模型Claude打招呼,写了一句“hello,claude”。没想到Claude毫不犹豫,秒回了一句极其纯正的中文:“Hello! 很高兴见到你。有什么我可以帮你的吗?”
网友顿时愣住,追问了一句:“为什么用中文?”
结果Claude给出了一个让人猝不及防且极其硬核的解释:“不好意思,因为你的打招呼里用了一个中文逗号(,),所以我猜你可能是中文使用者,就用中文回复了。这只是我的一个猜测,你发的信息其实是用英文写的。”
这一波操作,可以说是典型的“细节决定成败,标点暴露籍贯”。
在大多数人的认知里,AI识别语言靠的是词汇和语法,但底层大模型的逻辑可比我们想象的要“老辣”得多。在大语言模型(LLM)的算力世界里,所有文本并不是简单的字母组合,而是会被词元化工具(Tokenizer)切割成一个个Token(词元)。
在主流的BPE(双字节编码)词表中,英文半角逗号“,”和中文全角逗号“,”完全是两个截然不同的数字ID。英文逗号只是一个极其普通的通用分隔符,而中文全角逗号在数万亿级别的训练语料中,99.9%以上都高频绑定在中文上下文语境里。
你以为自己打出的是一句地道美语,但在AI的神经网络眼球里,那个全角逗号就像是一碗西餐里突然蹦出来的花椒粒,带着浓郁的国货香气,瞬间拉满了中文语言模型的概率权重。
这种“标点符号式破防”堪称赛博时代的无意识剧透。我们平时打字,经常在切了英文输入后,忘了把标点格式切成半角。拼写是原生美式,标点却是纯正京腔。
这其实揭示了一个非常有趣的现象:随着AI模型对人类数据学习得越发深邃,那些连人类自己都没察觉到的无意识习惯,都成为了我们独一无二的“数字指纹”。从全角半角的选择,到标点符号的混用,在几十亿甚至上万亿参数构成的概率分布阵列面前,统统无所遁形。
算力没有情感,但算力确实能看透你的键盘。面对AI这波自证式的耿直拆台,只能说,以后想跟AI隐身,光练好英语没用,可能还得先把电脑里的中文输入法彻底关掉。