很多人都想不通,为何AI大模型只有中美两家在玩,德法日韩这些发达国家却“集体消失”了?其实,这根本并不是技术高低的问题,而在于这些国家手里压根没有入场券。
德国有顶尖工业,日本有机器人,韩国有半导体,法国更不缺数学和计算机人才。按常理说,这几个国家怎么也该在大模型舞台上坐前排。
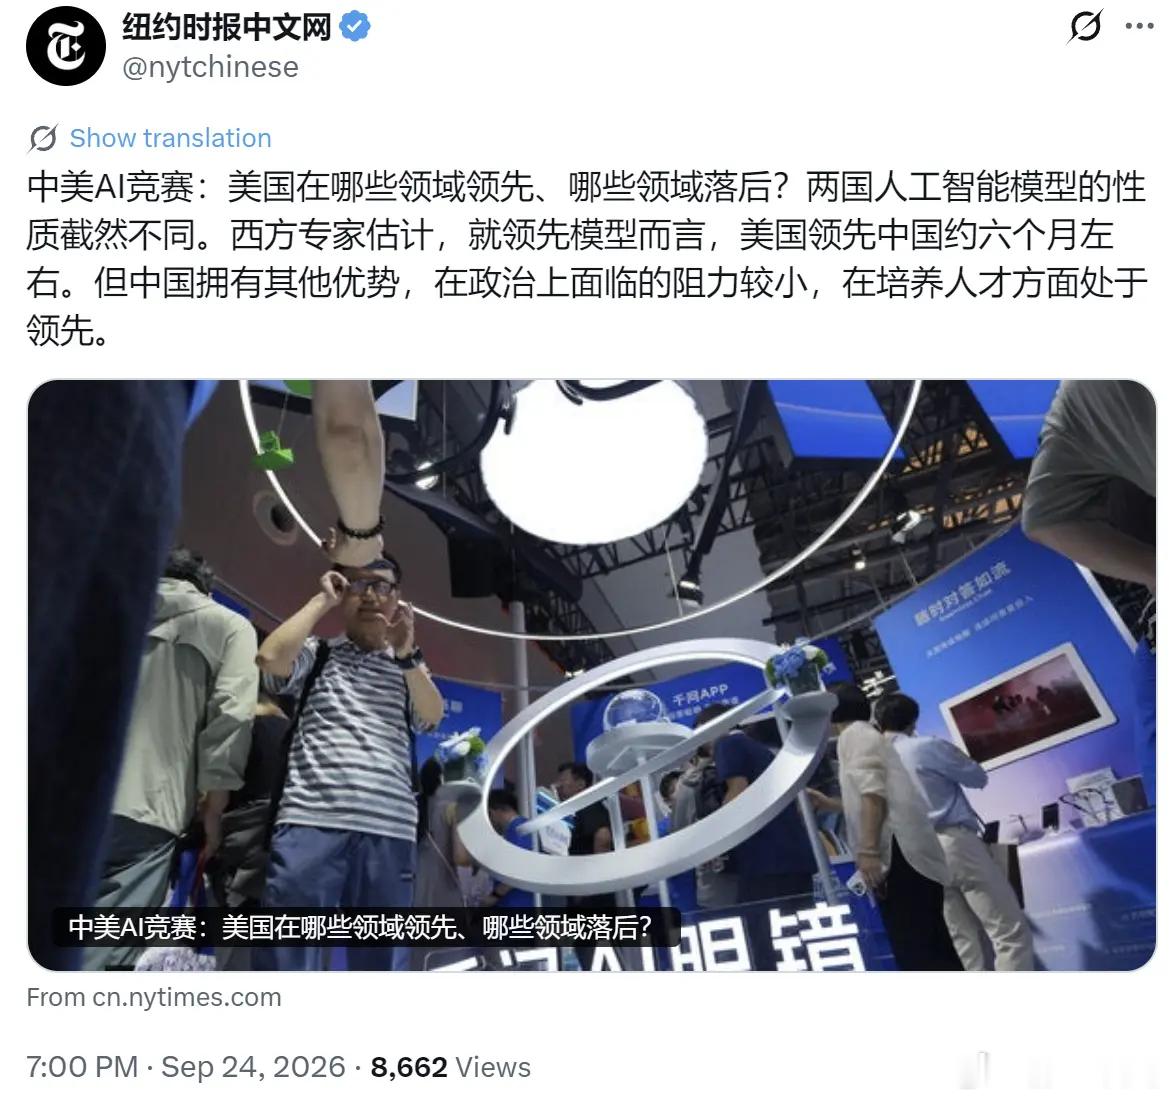
可真正到了全球通用大模型竞争最热闹的时候,聚光灯却越来越集中在中国和美国。
原因并不神秘。如今的大模型早就不是几个程序员关在办公室里敲代码那么简单了。
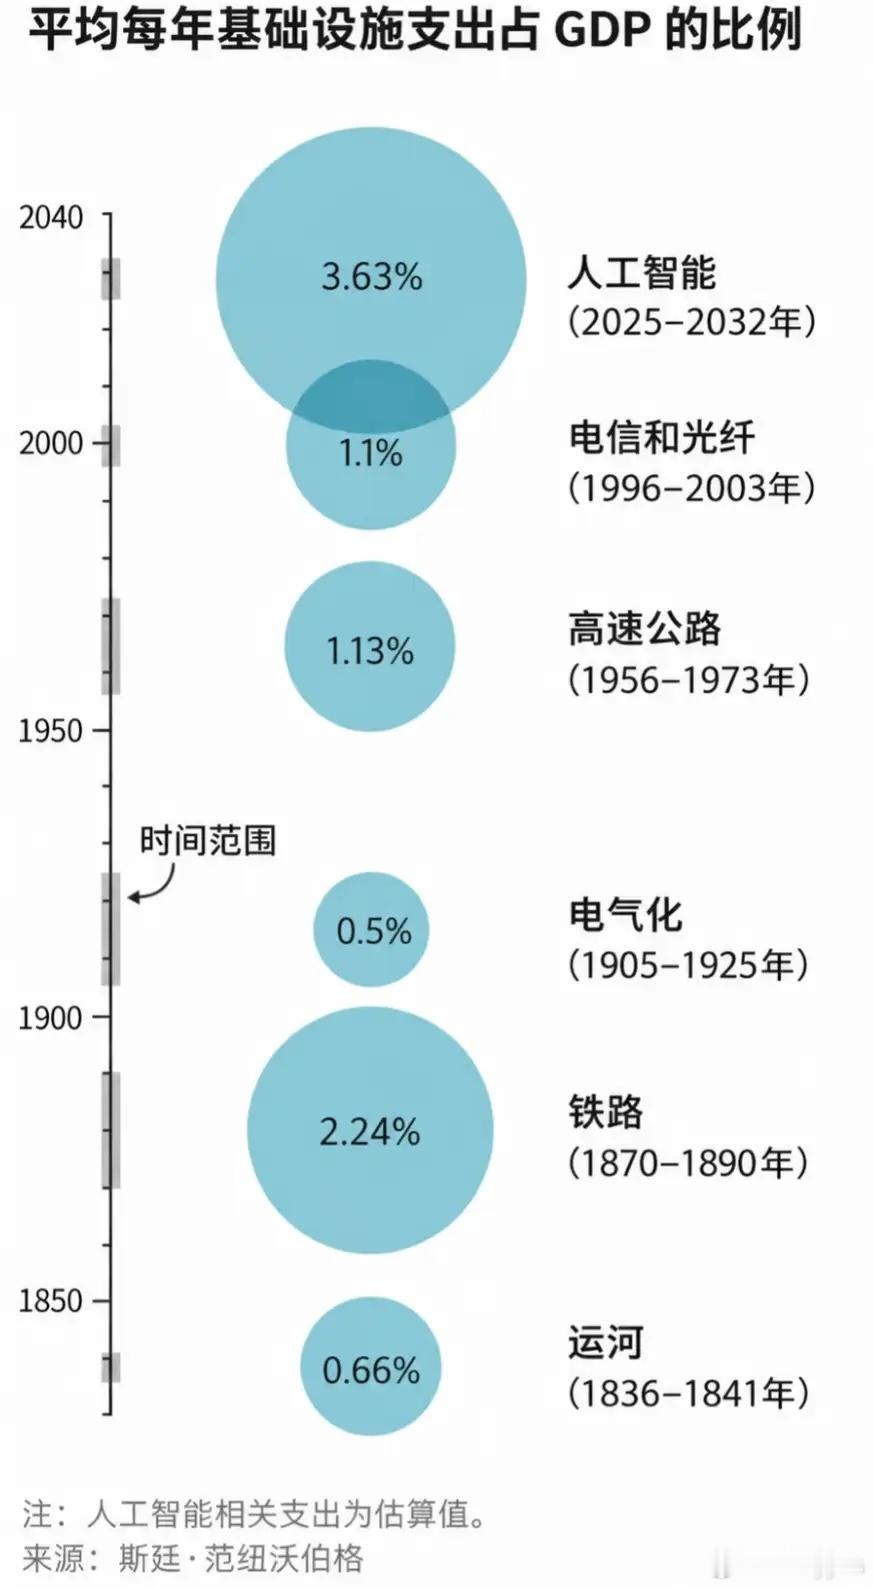
它更像一场重工业竞赛,芯片、算力、电力、资本、数据、人才、市场一个都不能少。少一样还能补,少一串,就只能眼看着门票越来越贵。
首先摆在桌面上的就是算力。先进模型需要庞大的计算资源,数据中心又是名副其实的“电老虎”。
机器买回来只是开始,此后的训练、推理、升级都在持续花钱。
美国长期拥有强大的芯片设计、云计算和软件生态,科技企业又能在全球市场回收研发成本。
中国的特点则是产业链完整、数字基础设施规模大,还有巨大的应用市场。
国务院部署深入实施“人工智能+”行动时,也明确提出发挥我国数据资源丰富、产业体系完备、应用场景广阔等优势。
这些条件单独看似乎都不神奇,拼在一起就不一样了。模型训练出来以后,可以很快进入制造、汽车、金融、物流、电商、办公、科研等场景。
产品一边使用,一边获取反馈,再继续迭代。技术和产业于是形成循环,不必一直待在实验室里烧钱等结果。
截至2026年8月底,我国累计已有1112款生成式人工智能服务完成备案。
这个数字真正有意思的地方,不是谁家的模型更多,而是国内已经形成相当丰富的模型供给和应用生态。
大模型正在从聊天窗口往工厂、手机、汽车和各种生产工具里走。
再看欧洲,故事就复杂了。法国并没有退出人工智能竞争,2025年还宣布吸引1090亿欧元人工智能相关投资。
欧洲联盟同样在补算力基础设施,截至2026年已形成19个人工智能工厂体系,并继续推动规模更大的人工智能超级计算设施。
德国也明显开始加速。2026年的国家数据中心战略提出,到2030年将国内数据中心能力至少扩大一倍,高性能计算和人工智能相关计算能力至少扩大到原来的四倍。
这些动作反过来说明了一个现实:欧洲最着急补的,恰恰是大模型时代最昂贵的基础设施。
传统工业强,并不会自动变成通用人工智能强。过去修一座汽车工厂很厉害,现在还得能养得起成片的数据中心。
欧洲还有另一个难题。它虽然是一个庞大经济体,却由多个国家、语言和市场组成。
德国企业的数据、法国用户的市场、西班牙的应用环境,并不像一个单一超大市场那样天然打通。
法规、资本体系和语言环境也存在差异,模型想快速形成统一商业生态,并不轻松。
日本和韩国面临的情况又不一样。日本当然没有放弃生成式人工智能。
日本有关部门从2024年开始推动生成式人工智能发展项目,到2026年第四期仍在支持16个基础模型项目,重点之一就是为企业提供开发模型所需的计算资源。
这句话其实已经把难题写在脸上了:算力太贵,企业自己扛起来很吃力,需要公共力量帮忙搭梯子。
韩国同样在推进自主基础模型。2026年相关项目继续筛选团队,企业也在开发自己的模型。
但韩国本土市场规模有限,即使拥有很强的半导体制造能力,也不等于自动拥有全球通用模型生态。
芯片会造和模型能养大,本来就是两回事。
所以真正的“入场券”,从来不是会不会写算法,而是能不能长期支付这场比赛的全部账单。
先进芯片只是第一张票,后面还有电力、数据中心、软件工具、资本、数据、开发者、用户和应用市场。
少了其中一两项,还可以选择工业模型、机器人模型、汽车模型或者其他垂直领域。
可要冲击全球通用大模型第一梯队,就必须把一整套体系同时转起来。
这也是德法日韩今后很可能继续强化工业人工智能和专业模型的重要原因。德国的制造业、日本的机器人和精密工业、韩国的半导体、法国的科研人才都仍然很有竞争力。
他们不是不会做人工智能,而是在选择自己更有把握的战场。
中国的优势则在于可以把人工智能直接放进庞大的实体经济中检验。制造业门类齐全,网络应用丰富,新能源汽车、机器人、物流、金融、电商等场景又能不断产生新需求。
一个模型真正有价值,不在于排行榜上的几个数字,而在于能否进入生产流程,提高效率,解决现实问题。
人工智能竞争走到今天,越来越像一场体系能力的长跑。某个实验室突然做出一个亮眼模型,当然值得注意,但决定最后位置的,是谁能连续多年提供算力、人才、资本和市场。
中国真正值得重视的地方,也正在这里。不是靠某一家公司唱独角戏,而是依托完整产业体系、超大规模市场和不断完善的数字基础设施,把人工智能和实体经济结合起来。