韩国这次是真进来了!
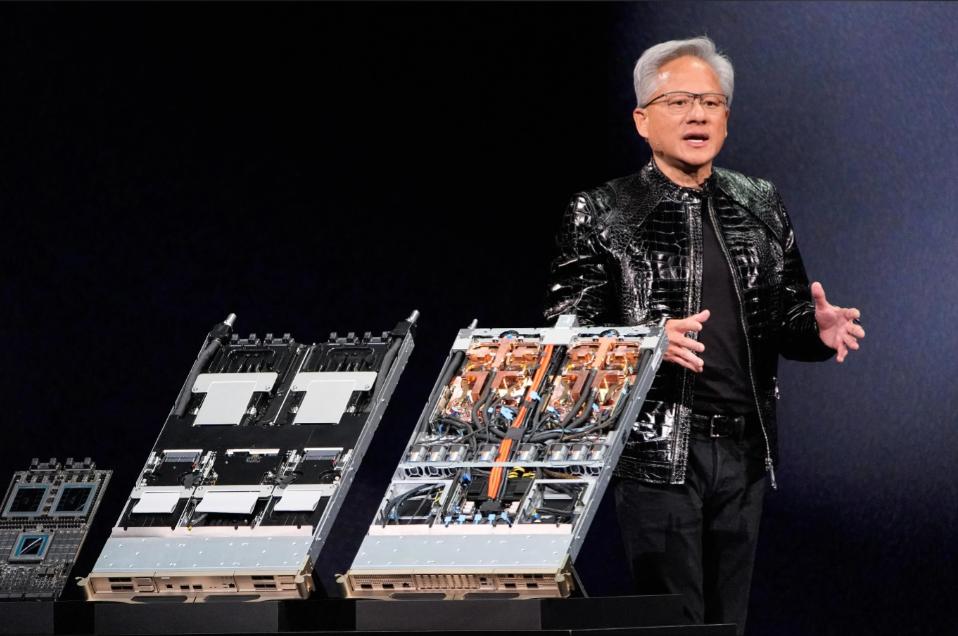
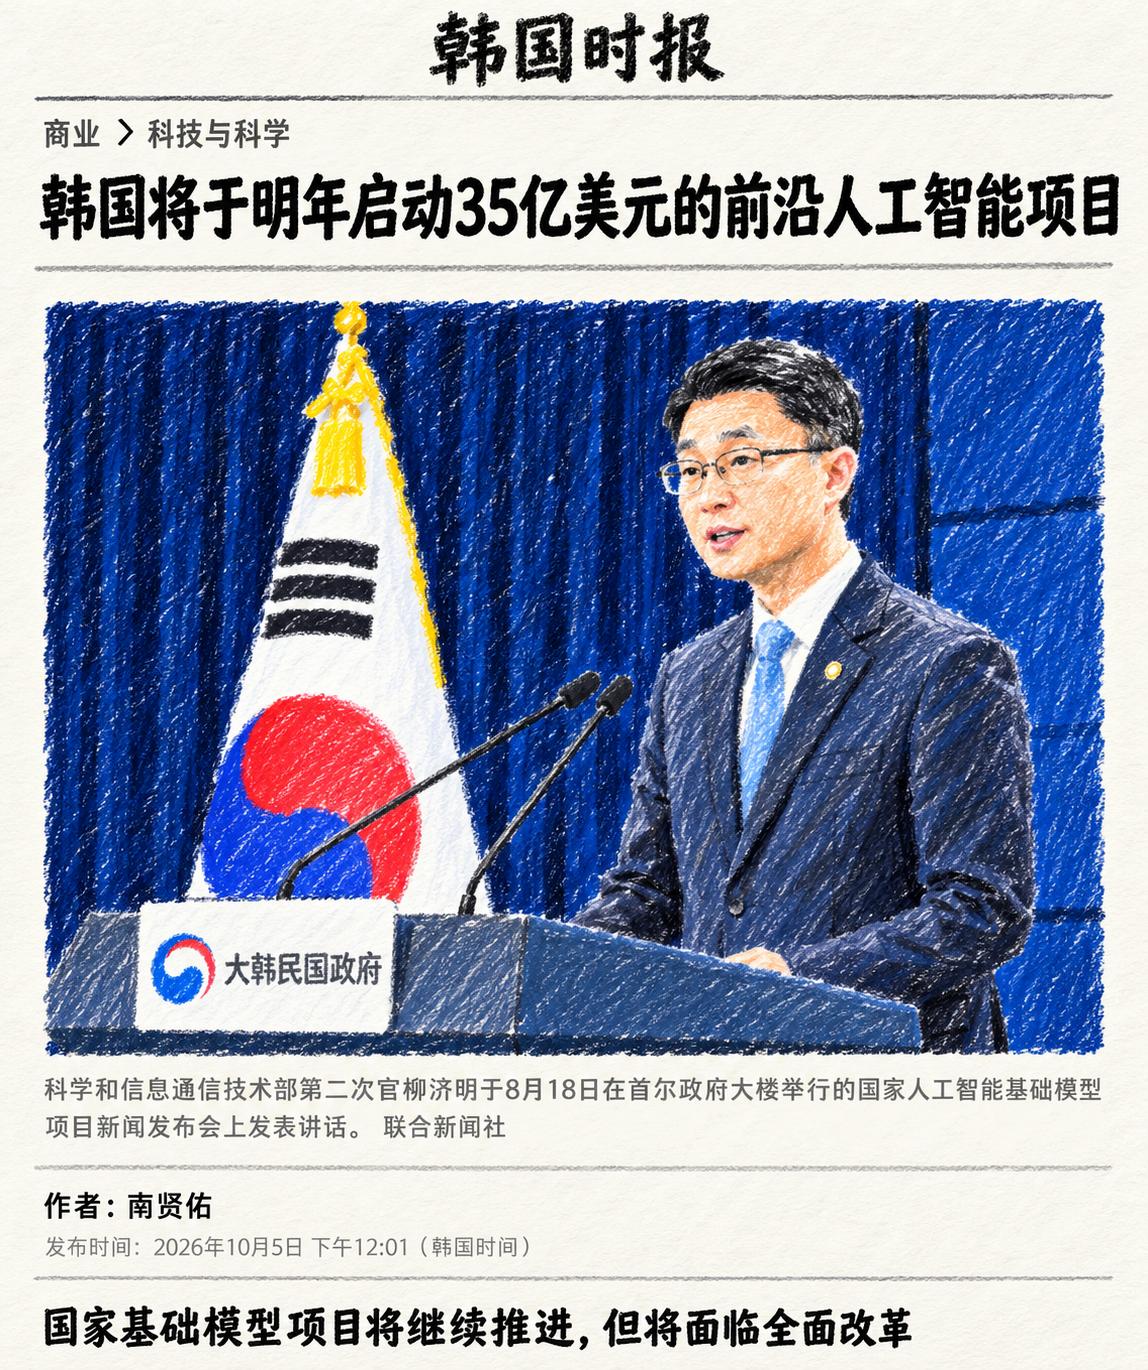
直接砸下 4.7 万亿韩元(约 35 亿美元),准备给国家级 Frontier AI 项目单独安排 1 万张英伟达下一代 Vera Rubin 架构战卡,再加上整个 AI 生态规划的 2.9 万张 B200 等效算力。最绝的是韩国官方的表态,直白得甚至有点扎心:追美国不现实,先做到中国顶尖开放模型这一档。
以前大家聊 AI 竞赛,默认是中美双雄打对台戏。没想到韩国这次带着自家家底,准备硬生生挤上主桌下注了。
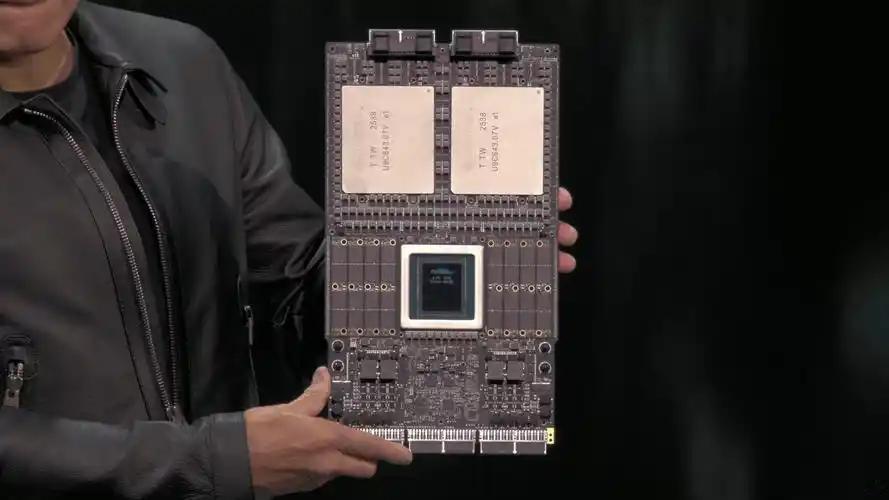
Vera Rubin 是英伟达继 B200 之后的新一代 AI 芯片,显存更大,算力更高,专门用来训练超大模型和智能 Agent。在全球高端 AI 芯片一卡难求的当下,韩国直接预定一万张,这个手笔本身就足够震撼。
另外配套的 2.9 万张 B200 等效算力,是给整个 AI 生态铺路,不只是训练一个国家级大模型,还要给国内企业、高校、初创公司提供算力,把整条产业链喂起来。
韩国官方看得很清楚,美国 OpenAI 这类顶级闭源模型,门槛太高,差距太大,硬追就是白白烧钱。
所以他们调整目标,不跟美国死磕,把对标目标锁定在国内顶尖的开放大模型。
这句话看着简单,其实是认清现实后的战略取舍。开放模型的好处是可以自主部署,企业拿来二次开发,不用完全受制于海外厂商。韩国的制造业底子很强,半导体、机器人、汽车行业都等着 AI 落地,他们需要能自己掌控的基础模型。
但理想很丰满,现实里面坑一点都不少。
首先第一个难题,芯片交付。Vera Rubin 属于下一代新品,产能有限,全球各国都在抢。就算合同签了,能不能按时足额拿到一万张,这是最大的未知数。
之前很多国家规划 AI 算力,画了宏大蓝图,最后卡在芯片到货慢,项目延期。韩国这次能不能避开这个老问题,还需要持续观察。
第二个短板,就是数据。
大模型说到底,拼的不只是显卡数量,还有高质量本土语料。韩国人口五千多万,韩语的优质文本、多模态素材总量,和中文、英语根本不在一个量级。
就算算力拉满,没有足够丰富、多元的本土数据,模型上限会被死死卡住。单纯堆卡,最多堆出一个硬件好看,但实际能力平平的模型。
第三点,人才缺口。韩国在半导体人才储备很强,但顶尖大模型训练、对齐、多模态研发的核心团队规模有限。
现在 Naver、Upstage、SKT 几个团队已经入选国家级项目,可想要同时支撑超大模型训练,还要搭建配套生态,人才压力不小。不是光买芯片就能一夜之间补齐团队。
很多网友会疑惑,韩国凭什么觉得自己能追上国内顶尖开放模型?
核心优势其实就两点。一是雄厚的硬件产业,三星存储、半导体供应链,能在硬件配套上降低成本;二是政企联动的模式,韩国擅长集中资源办大事,当年存储芯片就是这么杀出来的。
而且他们不是闭门造车,一边采购英伟达高端算力,一边同步推进国产 AI 芯片研发,两手准备,防止未来被海外芯片卡脖子。
聊到这里,说说我自己的看法。
很多人下意识觉得,韩国想对标我们的开放模型,有点不自量力。但我们不能小看这次布局。
韩国非常懂得避开强敌正面硬碰,找准一个可以追赶的目标集中砸钱。它不追求一步登顶全球第一,而是稳扎稳打,先拿到第二梯队的前排位置。一旦他们成功做出对标国内水平的开放模型,叠加自身制造业优势,会直接在机器人、智能汽车、工厂自动化领域形成竞争力。
不过,我们也不用过度焦虑。
国内开放模型的优势,不单单是模型本身,是海量中文真实数据、庞大应用场景、完整上下游开发者生态共同堆出来的。这不是单纯靠砸几十亿美元、买几万张显卡,短短两三年就能复刻的。
AI 竞赛不是一场一次性的冲刺,而是漫长的马拉松。算力只是其中一环,应用场景、数据、开发者生态、落地案例,每一项都需要长年积累。
韩国这次入局,最大的意义,其实是把全球 AI 竞争格局彻底改写。
以前大家讨论 AI 赛道,眼里只有中美。现在韩国主动下场,意味着 AI 不再是两个大国的专属游戏,工业强国都想拥有属于自己的主权大模型。未来几年,会有更多中等强国加入算力军备竞赛。
但我们也要看清一件事,单纯靠重金外购高端芯片,本身就藏着隐患。海外芯片的供货限制、价格波动,随时会影响项目进度。真正的 AI 自主权,终究不能完全建立在别人的芯片之上。
韩国自己也明白这个道理,所以项目规划里,同步扶持本土自研芯片,就是为了降低外部依赖。
这场新的 AI 较量,现在才刚刚拉开序幕。一万张下一代显卡只是入场券,能不能把硬件优势转化成好用、稳定、产业能用的大模型,还要看后续两年的落地成果。